
Le précédent article examinait des décisions allemandes. Qu’en est-il des États-Unis, terre d’origine des entreprises d’IA ?
Les tribunaux américains raisonnent autrement que les allemands : ils tendent à rapprocher l’entraînement de l’usage loyal. Mais beaucoup de litiges se terminent par des accords financiers considérables plutôt que par des jugements.
Examinons trois grandes affaires américaines sur l’entraînement de l’IA.
⚖️ La balance du fair use
L’usage loyal, ou fair use, est une exception permettant d’utiliser une œuvre sans autorisation. Les tribunaux évaluent quatre facteurs.
Dans les affaires d’entraînement, les premier et quatrième facteurs sont décisifs : lire des livres pour apprendre des régularités linguistiques remplace-t-il l’original ou le transforme-t-il en quelque chose de différent ? Et le résultat empiète-t-il sur son marché ?
L’analyse porte donc sur la nature et les effets de l’usage, non sur la présence de l’œuvre. Elle diffère dès son point de départ de la question allemande : l’œuvre demeure-t-elle dans le modèle ?
📕 Première affaire — Thomson Reuters v. Ross Intelligence [1] : premier rejet du fair use
Tout commence par un refus de licence. La startup juridique Ross Intelligence voulait utiliser les données de Westlaw, le service de recherche de Thomson Reuters, pour créer un outil de recherche de jurisprudence. Craignant un concurrent, Thomson Reuters a refusé.
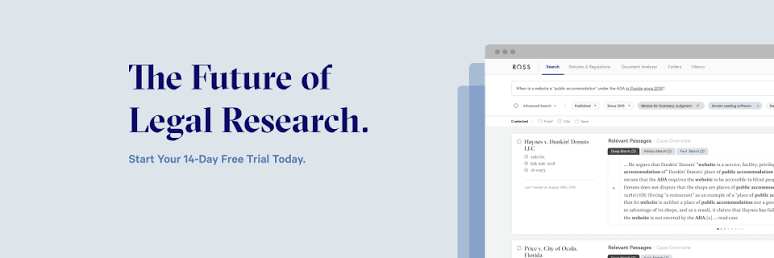
Ross a alors contourné le refus en commandant à un tiers des mémos juridiques, qui reposaient en réalité sur les résumés de jurisprudence, ou headnotes, de Westlaw.
Le tribunal a d’abord jugé que ces résumés ne sont pas de simples extraits de décisions, mais des créations incorporant des choix éditoriaux. Il a refusé le fair use pour leur utilisation à l’entraînement.
Le principal enjeu était le quatrième facteur, l’effet sur le marché : le service envisagé concurrençait directement Westlaw et portait atteinte au marché potentiel de licences de données pour l’IA. Ce second point est crucial, car il reconnaît l’existence d’un marché de licences de données d’entraînement.
Une réserve importante s’impose : l’IA de Ross était un outil de recherche, non génératif. Le juge a précisé que son analyse ne s’appliquait pas automatiquement à l’IA générative.
[1] Thomson Reuters v. Ross Intelligence — tribunal fédéral du Delaware, février 2025. La cour d’appel du troisième circuit a accepté en juin 2025 l’appel interlocutoire de Ross. L’audience s’est tenue le 11 juin 2026, dossier 25-2153. Aucun arrêt n’a encore été rendu.
Ross Intelligence a d’ailleurs déjà cessé ses activités, faute de pouvoir supporter les frais du procès.
📗 Deuxième affaire — Bartz v. Anthropic [2] : oui à l’entraînement, non au piratage
En août 2024, Andrea Bartz et deux autres auteurs ont poursuivi Anthropic. Selon eux, l’entreprise avait téléchargé massivement des livres protégés sur des bibliothèques clandestines comme LibGen pour entraîner Claude, puis les avait conservés définitivement dans sa bibliothèque interne même après avoir renoncé à les utiliser pour l’entraînement.
Le juge Alsup a séparé trois comportements : cette décomposition est au cœur de la décision.
Même si l’objectif d’entraînement est légitime, le mode d’acquisition des données fait donc l’objet d’un examen distinct.
[2] Bartz v. Anthropic — tribunal fédéral du district nord de Californie, juin 2025, juge William Alsup. L’entraînement d’un LLM avec des livres licitement acquis et la numérisation de livres achetés relèvent du fair use, contrairement au téléchargement et à la conservation de copies pirates.
Le troisième volet a été renvoyé devant un jury. Le droit américain permet jusqu’à 150 000 dollars de dommages-intérêts forfaitaires par œuvre. Avec sept millions de livres, l’exposition théorique pouvait menacer l’existence de l’entreprise. Anthropic a finalement conclu un accord de 1,5 milliard de dollars, définitivement approuvé le 20 juillet dernier [3]. Le tribunal l’a qualifié de plus important accord collectif de droit d’auteur de l’histoire.
[3] Accord Bartz : approbation définitive le 20 juillet 2026, 1,5 milliard de dollars pour environ 482 000 œuvres.
Les auteurs soutenaient aussi que Claude pouvait écrire des livres semblables aux leurs et empiéter sur leur marché. Le juge Alsup a rejeté cet argument. Pour illustrer le caractère transformateur, il l’a comparé au fait de se plaindre qu’enseigner l’écriture aux enfants produise des œuvres concurrentes. Le droit d’auteur protège une expression précise, non le droit d’empêcher de nouvelles œuvres concurrentes.
📘 Troisième affaire — Kadrey v. Meta [4] : une victoire qui n’en est pas vraiment une
Treize auteurs, dont Sarah Silverman, ont poursuivi Meta. Le résultat favorise Meta, mais la motivation mérite une lecture attentive.
Le juge Chhabria a fortement reconnu la théorie de la dilution du marché : un afflux illimité d’œuvres similaires produites par l’IA pourrait détruire la demande de l’original et l’incitation à créer. Si elle était démontrée, cette théorie pourrait faire gagner aux demandeurs le quatrième facteur, voire tout le débat sur le fair use. Il a aussi expressément rejeté comme inadaptée la comparaison d’Alsup avec l’apprentissage de l’écriture aux enfants.
Mais les treize demandeurs n’ont fourni aucune preuve de dilution. Meta avait produit des éléments montrant l’absence d’effet de l’entraînement sur leurs ventes ; les auteurs n’ont ni apporté de preuve contraire ni réellement plaidé ce point. Chhabria a donc dû donner raison à Meta, tout en précisant que cela ne signifie pas que son usage est licite : ces demandeurs ont présenté de mauvais arguments et n’ont pas constitué le dossier étayant les bons.
[4] Kadrey v. Meta — tribunal fédéral du district nord de Californie, juin 2025, juge Vince Chhabria. Le fair use a été reconnu pour l’entraînement de Llama, explicitement en raison de l’absence de preuves de dilution fournies par les demandeurs. Les demandes concernant la redistribution, ou seeding, pendant les téléchargements torrent restent examinées séparément.
Deux décisions du même tribunal, à deux jours d’intervalle, ont ainsi adopté des raisonnements opposés. Les États-Unis n’ont donc pas encore de réponse unifiée.
🧭 Pour conclure
Ces trois affaires permettent de résumer la position américaine ainsi :
Une affaire pourrait fournir cette première démonstration : le procès du New York Times contre OpenAI [5]. En janvier dernier, le tribunal a ordonné la remise de vingt millions de conversations ChatGPT anonymisées. Si elles révèlent par exemple une production habituelle de contenus remplaçant des articles payants, l’atteinte au marché que les auteurs n’ont pas prouvée contre Meta pourrait l’être pour la première fois.
[5] The New York Times Co. v. Microsoft Corp. & OpenAI — tribunal fédéral du district sud de New York, dossier 1:23-cv-11195, juge Sidney Stein. Action introduite en décembre 2023. En avril 2025, le tribunal a largement rejeté la demande de classement d’OpenAI, refusant l’argument d’un entraînement intrinsèquement transformateur et exigeant une instruction factuelle du fair use. L’affaire a ensuite été regroupée avec des actions d’autres médias et auteurs dans le MDL no 3143, devant le même juge. En août 2026, la communication des preuves est en cours et aucune date de procès n’est fixée.
Les deux continents examinés dans ces articles divergent donc : en Allemagne, l’entraînement impliquant une reproduction au-delà du nécessaire exige une licence ; aux États-Unis, l’entraînement est transformateur et relève du fair use, sous réserve de l’acquisition et des effets sur le marché.
Quelle voie prendra la Corée ? Selon la question privilégiée — sous quelle forme l’œuvre reste dans le modèle, ou caractère transformateur et effet commercial de son usage — une même affaire peut aboutir à des résultats très différents. Les discussions actuelles sur une exception TDM devraient préciser cette orientation.
#EntreTechnologieEtRègles #DroitAuteurIA #UsageLoyal #FairUse #Anthropic #TDM #IAGénérative