
En el artículo anterior examinamos casos alemanes. ¿Qué ocurre en Estados Unidos, sede de las empresas de IA?
Los tribunales estadounidenses razonan de manera distinta a los alemanes y se inclinan por considerar el entrenamiento uso legítimo. Sin embargo, muchos conflictos terminan en acuerdos millonarios, no en sentencias.
Examinaremos tres grandes casos estadounidenses sobre entrenamiento de IA.
⚖️ La balanza del fair use
El uso legítimo, o fair use, permite excepcionalmente utilizar obras sin permiso. Los tribunales valoran cuatro factores.
En los casos de entrenamiento importan sobre todo el primero y el cuarto: leer libros para aprender patrones lingüísticos sustituye al original o lo convierte en algo diferente; y el resultado invade o no su mercado.
Se examinan la naturaleza y los efectos del uso, no la presencia de la obra. Es un punto de partida diferente al alemán: si la obra permanece dentro del modelo.
📕 Primer caso: Thomson Reuters v. Ross Intelligence [1], primer rechazo del fair use
Todo comenzó con una licencia denegada. La startup jurídica Ross Intelligence quería datos de Westlaw, de Thomson Reuters, para crear un buscador de jurisprudencia. Thomson Reuters rechazó la solicitud por temor a un competidor.
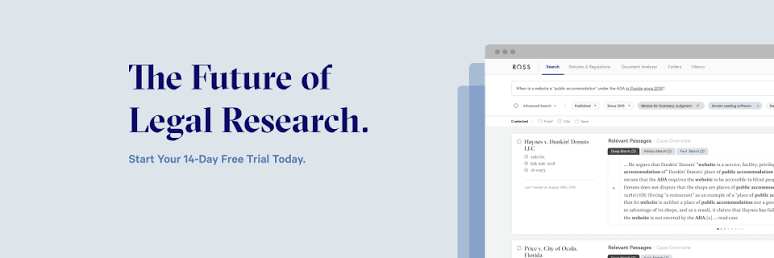
Ross optó por un rodeo: encargó a un tercero memorandos jurídicos que, en realidad, se basaban en los resúmenes de jurisprudencia, o headnotes, de Westlaw.
El tribunal consideró primero que esos resúmenes no eran meros extractos judiciales, sino creaciones con criterio editorial. Rechazó el fair use para entrenar con ellos.
El principal debate fue el cuarto factor, el efecto de mercado: Ross pretendía ofrecer un sustituto que competiría directamente con Westlaw y perjudicaría el mercado potencial de licencias de datos para IA. Este último punto es especialmente importante porque reconoce la existencia de un mercado de licencias de datos de entrenamiento.
Hay una reserva importante: la IA de Ross era de búsqueda, no generativa. El juez aclaró que su criterio no se aplica automáticamente a la IA generativa.
[1] Thomson Reuters v. Ross Intelligence: tribunal federal de Delaware, febrero de 2025. El Tercer Circuito admitió en junio de 2025 la apelación interlocutoria de Ross. La vista oral se celebró el 11 de junio de 2026, expediente 25-2153. Aún no hay sentencia de apelación.
Ross Intelligence, de hecho, ya cerró al no poder afrontar los costes judiciales.
📗 Segundo caso: Bartz v. Anthropic [2], entrenar sí, piratear no
En agosto de 2024, Andrea Bartz y otros dos autores demandaron a Anthropic. Alegaron que había descargado masivamente libros protegidos de bibliotecas clandestinas como LibGen para entrenar Claude y que, incluso tras decidir no utilizarlos, los conservó permanentemente en su biblioteca interna.
El juez Alsup dividió la conducta en tres partes; esa separación es la clave de la sentencia.
Aunque sea legítimo el propósito de entrenar, el modo de obtener los datos se analiza por separado.
[2] Bartz v. Anthropic: tribunal federal del Distrito Norte de California, junio de 2025, juez William Alsup. El entrenamiento de LLM con libros adquiridos legalmente y su digitalización son fair use; descargar y almacenar copias piratas no lo es.
La tercera parte pasó a juicio con jurado. El derecho estadounidense permite indemnizaciones legales de hasta 150 000 dólares por obra. Con siete millones de libros, el cálculo amenazaba la existencia de la empresa. Anthropic acordó finalmente pagar 1 500 millones de dólares, aprobados definitivamente el pasado 20 de julio [3]. El tribunal lo calificó como el mayor acuerdo colectivo de derechos de autor de la historia.
[3] Acuerdo Bartz: aprobación definitiva el 20 de julio de 2026, 1 500 millones de dólares para unas 482 000 obras.
Los autores también alegaron que Claude podía escribir libros similares y erosionar su mercado. Alsup lo rechazó. Al explicar la transformación, comparó esa queja con protestar porque enseñar a escribir a niños produce obras competidoras. Los derechos de autor protegen expresiones concretas, no el derecho a impedir nuevas obras que compitan.
📘 Tercer caso: Kadrey v. Meta [4], una victoria que no lo es del todo
Trece autores, incluida Sarah Silverman, demandaron a Meta. El resultado favoreció a Meta, pero conviene leer detenidamente la motivación.
El juez Chhabria reconoció con fuerza la teoría de dilución del mercado: una avalancha ilimitada de obras similares de IA podría destruir la demanda del original y el incentivo para crear. Si se demostrara, los demandantes podrían ganar el cuarto factor e incluso toda la controversia de fair use. También rechazó expresamente por inadecuada la comparación de Alsup con enseñar a escribir a niños.
Pero los trece demandantes no aportaron pruebas de dilución. Meta presentó datos de que su entrenamiento no afectó a las ventas de sus libros; los autores no aportaron pruebas contrarias ni litigaron adecuadamente el punto. Chhabria tuvo que fallar por Meta, aclarando que no significa que su uso sea legal: esos demandantes plantearon argumentos equivocados y no construyeron un expediente que sustentara los correctos.
[4] Kadrey v. Meta: tribunal federal del Distrito Norte de California, junio de 2025, juez Vince Chhabria. Se reconoció fair use en el entrenamiento de Llama, expresamente porque los demandantes no probaron la dilución del mercado. Las reclamaciones por distribución, o seeding, durante descargas torrent siguen por separado.
Dos asuntos del mismo tribunal, separados por dos días, adoptaron razonamientos opuestos. Ni en Estados Unidos existe todavía una respuesta única.
🧭 Para terminar
Los tres casos permiten resumir la posición estadounidense así:
Un caso podría aportar esa primera prueba: la demanda del New York Times contra OpenAI [5]. El pasado enero, el tribunal ordenó entregar veinte millones de conversaciones anonimizadas de ChatGPT. Si muestran, por ejemplo, producción habitual de contenidos que sustituyen artículos de pago, podría probarse por primera vez el perjuicio de mercado que los autores no demostraron frente a Meta.
[5] The New York Times Co. v. Microsoft Corp. & OpenAI: tribunal federal del Distrito Sur de Nueva York, expediente 1:23-cv-11195, juez Sidney Stein. Presentado en diciembre de 2023. En abril de 2025 se rechazó en gran parte la petición de archivo de OpenAI y su argumento de entrenamiento intrínsecamente transformador, exigiendo examen de hechos sobre fair use. Después se agrupó con demandas de otros medios y autores en el MDL n.º 3143 ante el mismo juez. En agosto de 2026 continúa la fase de descubrimiento de pruebas, sin fecha de juicio.
Las respuestas de los dos continentes divergen: Alemania exige licencia cuando el entrenamiento implica reproducción más allá de lo necesario; Estados Unidos lo ve transformador y fair use, con reservas por adquisición de datos y efectos de mercado.
¿Qué camino seguirá Corea? Según priorice la forma en que la obra permanece en el modelo o el carácter transformador y el efecto comercial del uso, un mismo caso puede terminar de manera muy distinta. El debate actual sobre una excepción TDM debería perfilar esa orientación.
#EntreTecnologíaYNormas #DerechosAutorIA #UsoLegítimo #FairUse #Anthropic #TDM #IAGenerativa