
Lorsqu’on étudie l’IA, certaines questions viennent naturellement à l’esprit :
Si nous comprenons bien notre cerveau, pouvons-nous également mieux comprendre l’IA ? À l’inverse, si l’on comprend bien l’IA, peut-on aussi bien comprendre le cerveau ? Non, avant cela, sont-ils même similaires en premier lieu ?
Cette question est plus délicate que vous ne le pensez, et personne n’a de réponse facile.
Puis, en 2019, un article publié dans PNAS a fait une percée. Saxe et al., « Une théorie mathématique du développement sémantique dans les réseaux de neurones profonds » (PNAS, 2019).
Cet article a été co-écrit avec l'auteur de l'article, Jin Hwa Lee, qui travaille dans le laboratoire du professeur Saxe (The Thinking Lab, University College London).
🧠 De près comme de loin, science du cerveau et IA
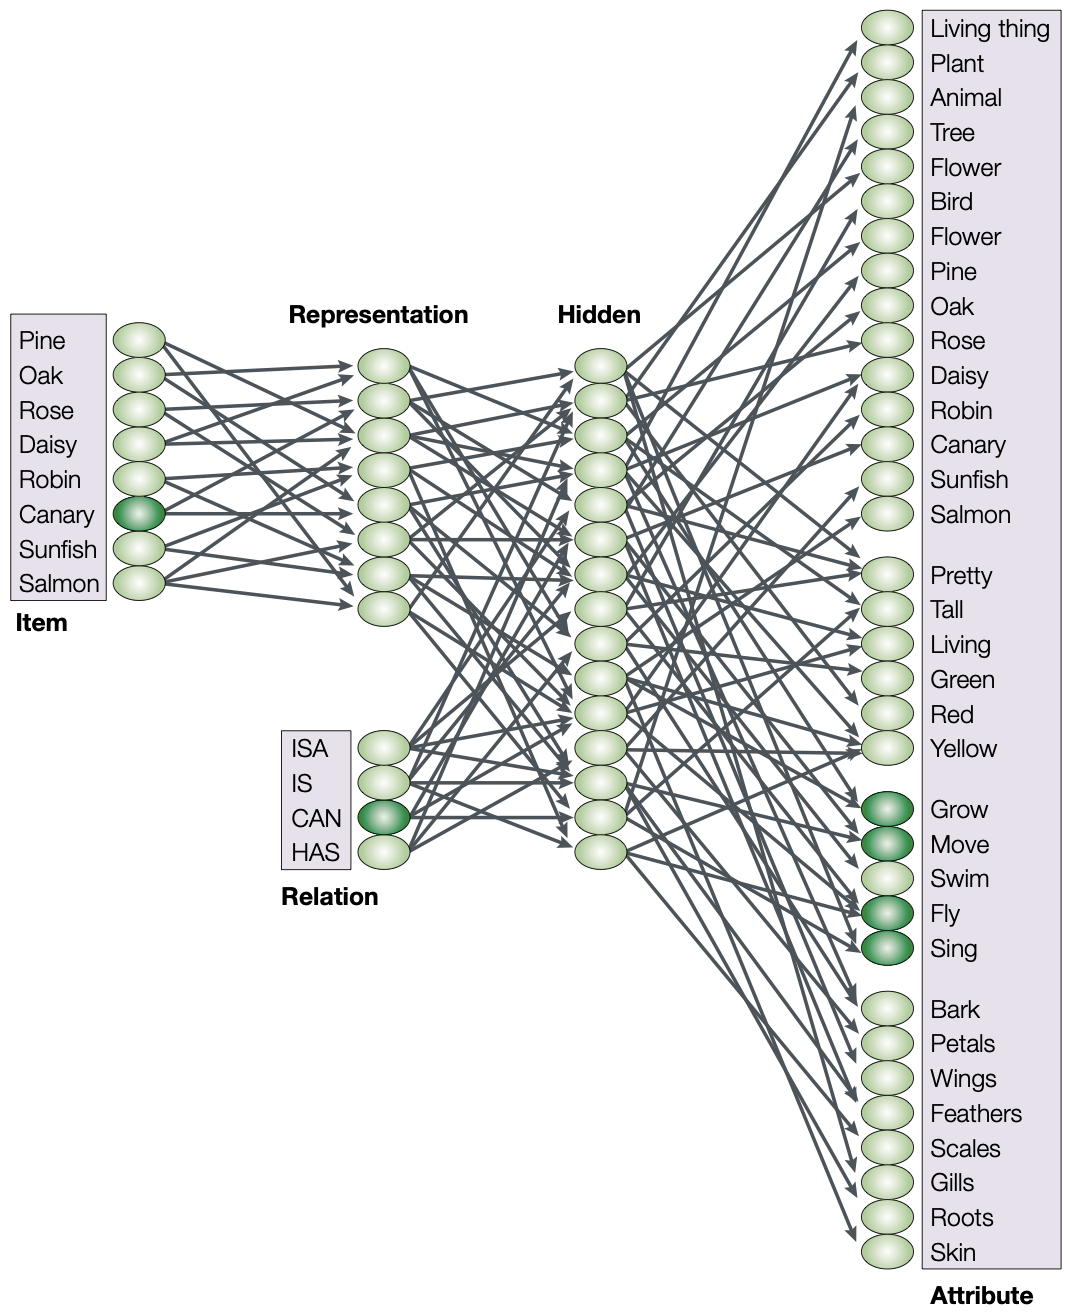
Des années 1940 aux années 1980, les scientifiques ont montré qu’un réseau neuronal calqué sur la structure opérationnelle du cerveau pouvait constituer la base de l’IA.
Dans les années 1940, McCulloch et Pitts ont mis le fonctionnement des neurones dans une équation mathématique. Puis, dans les années 1980, Rumelhart et McClelland ont proposé le modèle PDP (parallel Distributed Processing). L’idée était que, tout comme les neurones du cerveau sont connectés les uns aux autres et fonctionnent en parallèle, un réseau neuronal artificiel pourrait être conçu de cette façon. C'est la première fois qu'il est démontré que « l'intelligence » peut être apprise à l'aide d'une structure qui imite le cerveau. C’est devenu le point de départ direct de l’apprentissage profond d’aujourd’hui.
Mais au fil du temps, les deux domaines se sont de plus en plus éloignés.
Les neurosciences ont approfondi les circuits neuronaux réels. Cela va au niveau biologique profond, avec l'hippocampe créant des souvenirs, l'amygdale traitant la peur et la dopamine orchestrant l'apprentissage des récompenses.
L’IA s’est développée uniquement sur la base de la performance. Les Transformers sont sortis, puis le modèle de langage géant est sorti. L’objectif initial d’imiter les neurones a soudainement été abandonné.
Pour résumer la différence entre les deux, c’est la suivante.
Les neurosciences parlent le langage de l’observation :
Ce sont tous des résultats d’observation minutieusement accumulés, mais il est impossible de calculer pourquoi ils sont ainsi ni comment ils changeront si les conditions changent.
L’IA parle le langage des essais et des erreurs :
Essayez de le modifier, vérifiez les résultats et modifiez-le à nouveau. Nous savons ce qui fonctionne, mais nous ne savons pas pourquoi cela fonctionne.
Puis, après le boom de l’apprentissage profond dans les années 2010, la relation entre l’IA et la science du cerveau a été réexaminée. En fait, des similitudes intéressantes commencent à apparaître entre les deux. La recherche a montré que les modèles d'apprentissage profond qui apprennent des images présentent des modèles d'activité hiérarchiques similaires à ceux du cortex visuel du cerveau (Yamins et DiCarlo, 2014), ce qui laisse espérer que les deux domaines peuvent aider à se comprendre.
Cependant, contrairement aux attentes, aucun progrès significatif n’a été enregistré dans la compréhension mutuelle. Bien que des similitudes aient été observées, la raison pour laquelle de tels liens se produisaient n’était toujours pas clairement expliquée, et la conversation entre les deux domaines restait principalement au niveau de l’analogie. En effet, les langues utilisées dans les deux domaines sont différentes.
Pour combler cet écart, il fallait une troisième langue que les deux domaines pourraient partager.
💡 Stratégie choisie par le journal : volontairement simple
L'article de Saxe publié dans PNAS en 2019 a montré que les changements observés dans le développement de notre cognition peuvent être prédits en expliquant le processus d'apprentissage de l'IA basé sur les réseaux neuronaux avec une formule. Le langage qui pouvait expliquer les principes de fonctionnement des deux systèmes était les mathématiques.
La simplification peut obscurcir des détails, mais elle peut aussi être l’arme la plus puissante pour révéler l’essence d’un système. La loi des gaz parfaits en physique n’explique pas complètement les gaz réels, mais elle capture avec précision la façon dont les gaz constitués d’innombrables molécules changent et se déplacent à travers quelques variables clés.
Au départ, les auteurs n’avaient pas l’intention d’analyser de vrais cerveaux ou des modèles d’IA de pointe. En effet, les deux sont trop complexes pour être complètement résolus avec des formules.
Au lieu de cela, les auteurs ont choisi un modèle appelé réseau linéaire profond. Il s’agit d’un réseau simple sans fonction d’activation non linéaire.
🗝️ Point clé de l'article : Résoudre l'apprentissage des réseaux de neurones avec les mathématiques
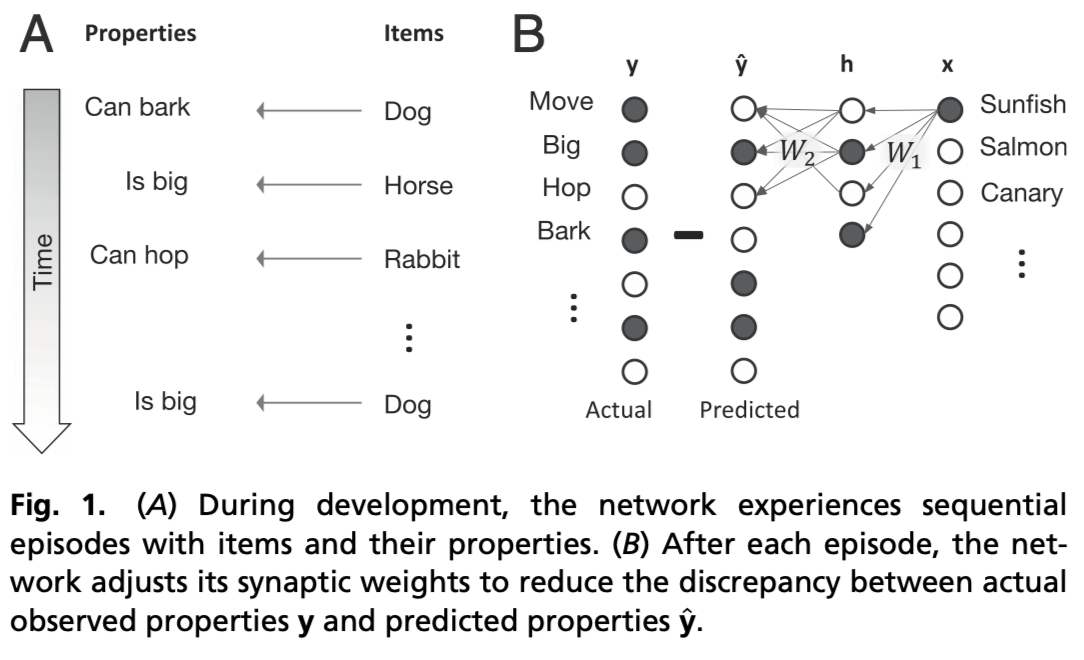
Les auteurs représentent et résolvent des équations différentielles sur la façon dont les poids changent au fil du temps lors de la formation d'un réseau neuronal linéaire profond à l'aide de la descente de gradient. En d’autres termes, le modèle d’apprentissage du réseau neuronal est suivi en temps réel.
En résolvant des équations différentielles, comme la loi des gaz parfaits dans l’exemple précédent, l’apprentissage d’un réseau neuronal composé de dizaines de milliers d’éléments pourrait être brièvement expliqué avec un nombre beaucoup plus réduit de variables.
Les résultats peuvent être résumés comme suit. Les réseaux de neurones n'apprennent pas au hasard des modèles dans les données,
Cela s’apprend.
Voici un peu plus d'explications sur l'importance des motifs.
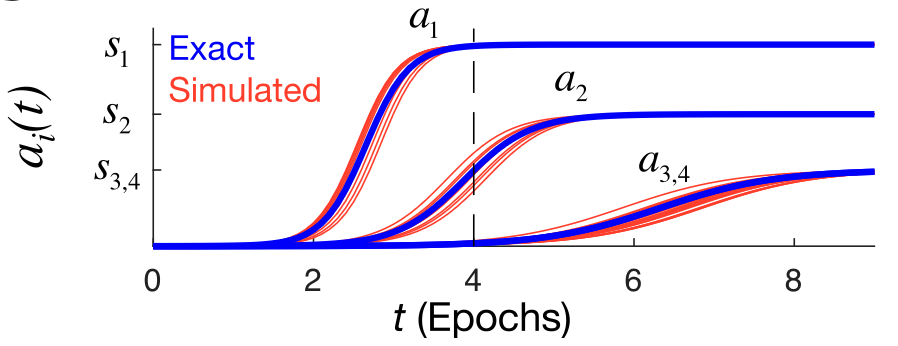
Si vous disposez de données constituées d’animaux et de leurs caractéristiques, il existe plusieurs hiérarchies de modèles mélangés en son sein. À ce stade, le modèle fait référence à la division qui apparaît dans les données, par exemple « Oiseau ou poisson ? », « Pigeon ou moineau ? Dans ce cas, la hiérarchie est divisée en modèles qui sont forts dans l'ensemble des données et qui sont plus importants (« Oiseau ou poisson ? »), et en modèles moins importants qui n'apparaissent que dans une partie des données (« Colombe ou Moineau »).
La descente de gradient capture d'abord les modèles qui apparaissent fortement dans les données, puis les modèles qui n'apparaissent que dans certaines parties des données.
🔢 Expliquer les sciences cognitives avec les mathématiques
Les résultats ci-dessus expliquent divers phénomènes observés par les sciences cognitives au cours des dernières décennies. En voici quelques-uns.
① Apprentissage des grandes catégories (« animaux ») avant les petites catégories (« pigeons »)
Les enfants comprennent les catégories plus larges avant les détails. « Oiseau » vient avant « pigeon », « animal » vient avant « oiseau », et ainsi de suite.
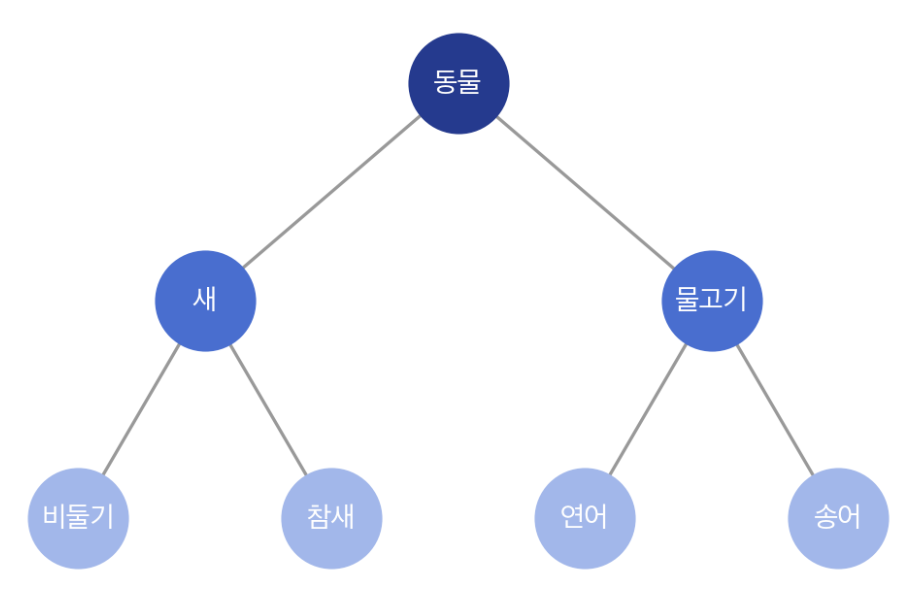
Selon les formules de l’article, cet ordre d’apprentissage est une nécessité mathématique.
② La théorie du développement cognitif de Piaget
Piaget disait que le développement de l'enfant n'est pas continu. Plutôt que de s’améliorer petit à petit, l’étape de bond soudain après une longue période de stagnation se répète.
La courbe en forme de S dérivée de la formule correspond exactement à cela. Et comme différents modèles évoluent à des moments différents, ils ressemblent à des « phases » de l’extérieur.
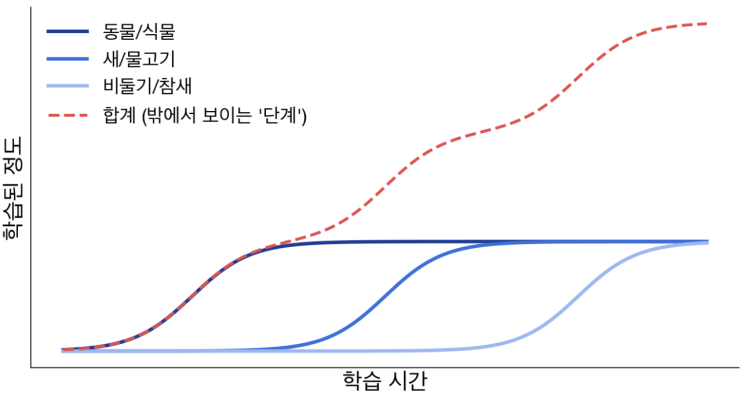
Les étapes du développement de l’enfant que Piaget a dérivées de décennies d’observation des enfants constituent également une nécessité mathématique de l’algorithme d’apprentissage.
③ Courbe d'apprentissage en forme de U - Erreurs temporaires dans le processus d'apprentissage des enfants
Il existe des modèles d’apprentissage communs chez les enfants. C’est le modèle « une fois faux, puis corrigé ». Par exemple, à la question « Le saumon peut-il voler ? », la réponse est « Non » au début de l'apprentissage. Mais à un moment donné, la réponse est « oui » pendant un moment, puis elle revient au « non » plus tard. Ceci est commun à tous les enfants. Pourquoi est-ce ainsi ?
Parce que les modèles sont appris par ordre d’importance, il arrive un moment où les enfants ont appris des distinctions générales (« est/n’est pas un animal ») mais n’ont pas encore appris de distinctions spécifiques (« oiseau vs poisson »). Dans cet état, si nous apprenons un fait sur la subdivision (« les oiseaux peuvent voler »), le réseau, qui traite toujours les oiseaux et les poissons comme le même groupe, appliquera également les caractéristiques des oiseaux aux poissons. Puis, une fois l’apprentissage détaillé de la classification terminé, ces erreurs disparaissent.
En d’autres termes, ces erreurs d’apprentissage transitionnelles que nous avons tous vécues dans l’enfance sont aussi une nécessité mathématique.
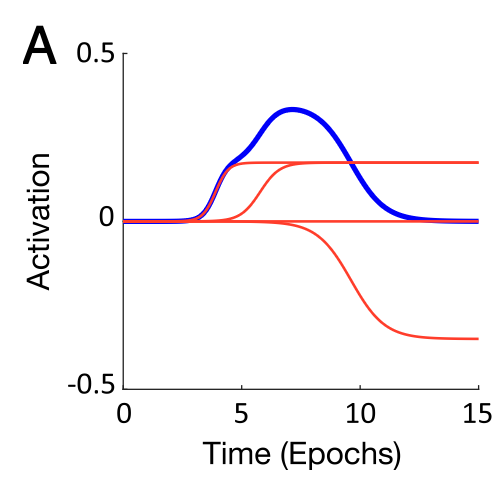
En résumé, cet article a dérivé tous les phénomènes expliqués par différents psychologues, à travers différentes expériences et différentes théories, à partir de formules exprimant le processus d'apprentissage des réseaux neuronaux profonds.
Les auteurs décrivent ces résultats comme une « fenêtre mathématiquement exploitable » sur le processus par lequel les représentations cérébrales se développent à travers l’expérience, bien que cette formule simple ne concerne pas le cerveau lui-même. Et je conclus cet article en disant que j'espère que cette fenêtre servira un jour de tremplin pour révéler comment les calculs mentaux de grande dimension émergent du matériel biologique appelé cerveau.
🧭 Conclusion
L’histoire de cet épisode était que les mathématiques étaient le troisième langage reliant la science du cerveau et l’IA, et que de nombreux faits en sciences cognitives en étaient expliqués d’un coup.
Dans la partie suivante, nous examinerons la contribution de cet article à chaque domaine de la science du cerveau et de l’IA, et quelle réponse il apporte au débat de longue date : « Les humains naissent-ils avec une page vierge ? J'ajouterai également une brève séance de questions-réponses avec le chercheur Lee Jin-hwa, co-auteur de cet article.
#Schéma des tâches techniques #IA #Science du cerveau #Sciences cognitives #Apprentissage profond #Introduction papier