
Beim Studium der KI kommen einem ganz natürlich Fragen in den Sinn:
Wenn wir unser Gehirn gut verstehen, können wir dann auch KI besser verstehen? Umgekehrt: Wenn wir KI gut verstehen, können wir dann auch das Gehirn gut verstehen? Nein, sind sie sich vorher überhaupt ähnlich?
Diese Frage ist schwieriger als Sie denken, und niemand hat eine einfache Antwort.
Dann, im Jahr 2019, gelang mit einem in PNAS veröffentlichten Artikel der Durchbruch. Saxe et al., „Eine mathematische Theorie der semantischen Entwicklung in tiefen neuronalen Netzen“ (PNAS, 2019).
Dieser Artikel wurde gemeinsam mit dem Autor des Artikels, Jin Hwa Lee, verfasst, der im Labor von Professor Saxe (The Thinking Lab, University College London) arbeitet.
🧠 Nah und fern, Hirnforschung und KI
In den 1940er bis 1980er Jahren zeigten Wissenschaftler, dass ein neuronales Netzwerk, das der Funktionsstruktur des Gehirns nachempfunden ist, die Grundlage für KI sein könnte.
In den 1940er Jahren stellten McCulloch und Pitts die Funktionsweise von Neuronen in eine mathematische Gleichung. Dann, in den 1980er Jahren, schlugen Rumelhart und McClelland das PDP-Modell (Parallel Distributed Processing) vor. Die Idee war, dass auf diese Weise ein künstliches neuronales Netzwerk entworfen werden könnte, so wie Neuronen im Gehirn miteinander verbunden sind und parallel arbeiten. Dies ist das erste Mal, dass gezeigt wurde, dass „Intelligenz“ mithilfe einer Struktur erlernt werden kann, die das Gehirn nachahmt. Dies wurde zum direkten Ausgangspunkt für das heutige Deep Learning.
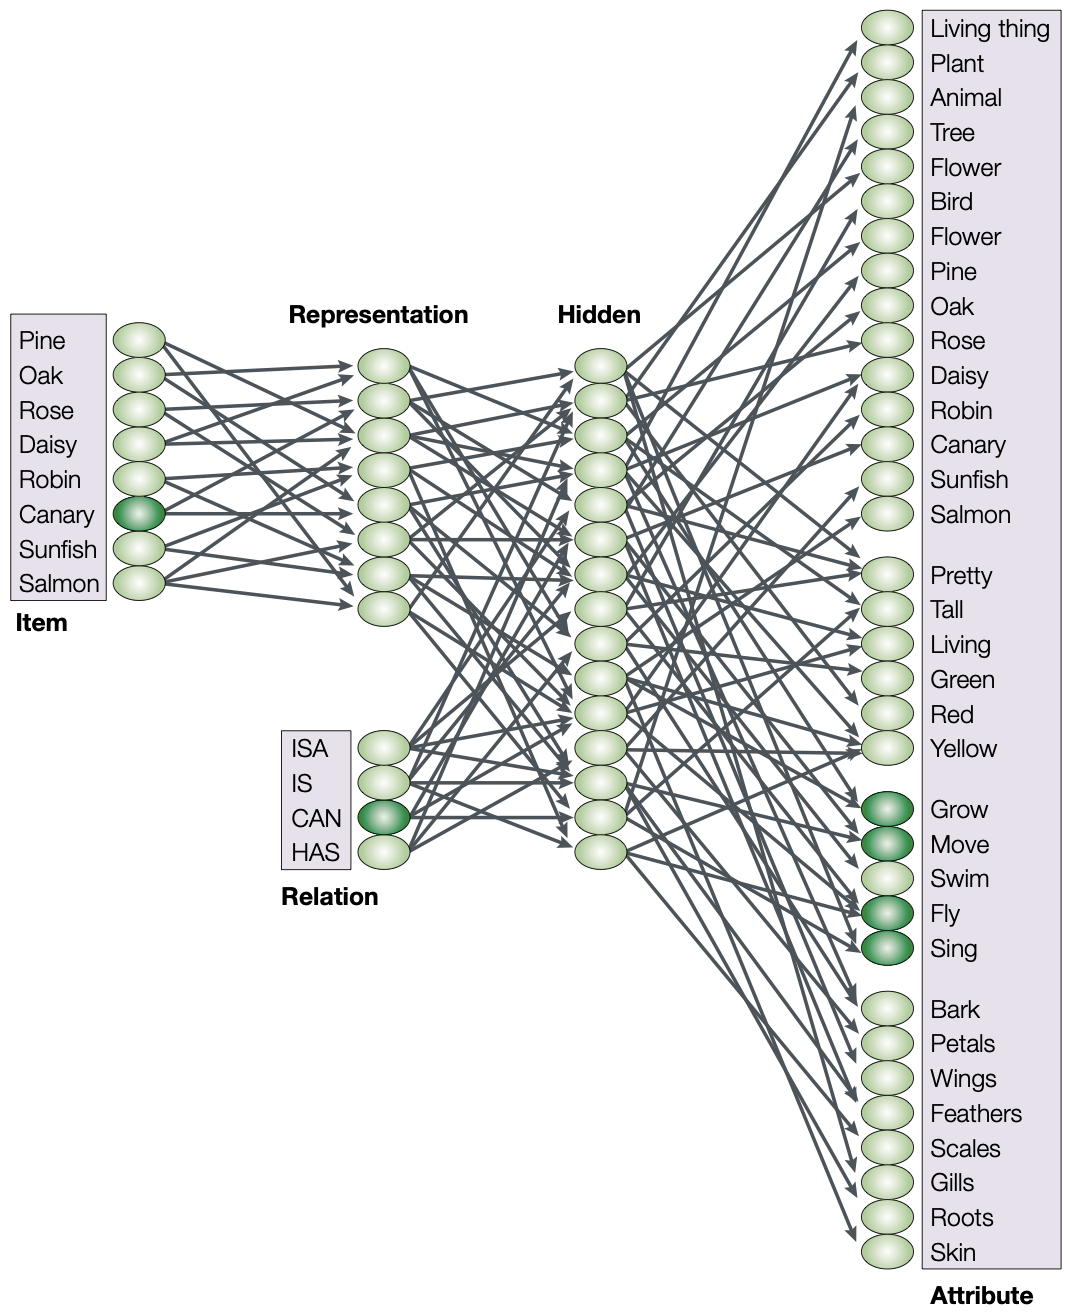
Doch mit der Zeit entfernten sich die beiden Bereiche immer weiter voneinander.
Die Neurowissenschaften haben sich eingehend mit tatsächlichen neuronalen Schaltkreisen befasst. Es geht biologisch tief: Der Hippocampus erzeugt Erinnerungen, die Amygdala verarbeitet Angst und Dopamin orchestriert Belohnungslernen.
KI hat sich ausschließlich leistungsorientiert entwickelt. Transformers kamen heraus und dann kam das riesige Sprachmodell heraus. Das ursprüngliche Ziel, Neuronen nachzuahmen, geriet plötzlich in Vergessenheit.
Um den Unterschied zwischen den beiden zusammenzufassen, ist er wie folgt.
Die Neurowissenschaft spricht die Sprache der Beobachtung:
Das sind alles aufwendig akkumulierte Beobachtungsergebnisse, aber es lässt sich nicht berechnen, warum sie so sind oder wie sie sich verändern, wenn sich die Bedingungen ändern.
KI spricht die Sprache von Versuch und Irrtum:
Versuchen Sie es zu ändern, überprüfen Sie die Ergebnisse und ändern Sie es erneut. Wir wissen, was funktioniert, aber wir wissen nicht, warum es funktioniert.
Dann, nach dem Deep-Learning-Boom in den 2010er Jahren, wurde die Beziehung zwischen KI und Hirnforschung erneut untersucht. Tatsächlich zeichnen sich zwischen den beiden einige interessante Ähnlichkeiten ab. Untersuchungen haben gezeigt, dass Deep-Learning-Modelle, die Bilder lernen, hierarchische Aktivitätsmuster aufweisen, die denen des visuellen Kortex des Gehirns ähneln (Yamins & DiCarlo, 2014), was die Erwartung weckt, dass die beiden Bereiche zum gegenseitigen Verständnis beitragen können.
Allerdings gab es entgegen den Erwartungen keine nennenswerten Fortschritte im gegenseitigen Verständnis. Obwohl Ähnlichkeiten beobachtet wurden, war die Ursache dieser Zusammenhänge immer noch nicht klar geklärt, und die Diskussion zwischen den beiden Bereichen blieb hauptsächlich auf der Ebene der Analogie. Dies liegt daran, dass die in den beiden Bereichen verwendeten Sprachen unterschiedlich sind.
Um diese Lücke zu schließen, war eine dritte Sprache erforderlich, die beide Bereiche gemeinsam nutzen konnten.
💡 Vom Papier gewählte Strategie: bewusst einfach
Saxes im Jahr 2019 in PNAS veröffentlichter Artikel zeigte, dass Veränderungen in der Entwicklung unserer Kognition vorhergesagt werden können, indem der auf neuronalen Netzwerken basierende KI-Lernprozess mit einer Formel erklärt wird. Die Sprache, die die Prinzipien der Funktionsweise der beiden Systeme erklären konnte, war die Mathematik.
Vereinfachung kann Details verschleiern, sie kann aber auch die wirksamste Waffe sein, um das Wesen eines Systems offenzulegen. Das ideale Gasgesetz in der Physik erklärt die tatsächlichen Gase nicht vollständig, erfasst aber genau, wie sich Gase, die aus unzähligen Molekülen bestehen, durch einige Schlüsselvariablen verändern und bewegen.
Die Autoren hatten zunächst nicht die Absicht, echte Gehirne oder hochmoderne KI-Modelle zu analysieren. Denn beide sind zu komplex, um sie vollständig mit Formeln lösen zu können.
Stattdessen wählten die Autoren ein Modell namens „Deep Linear Network“. Dies ist ein einfaches Netzwerk, bei dem die nichtlineare Aktivierungsfunktion entfernt wurde.
🗝️ Kernpunkt der Arbeit: Lösung des Lernens neuronaler Netze mit Mathematik
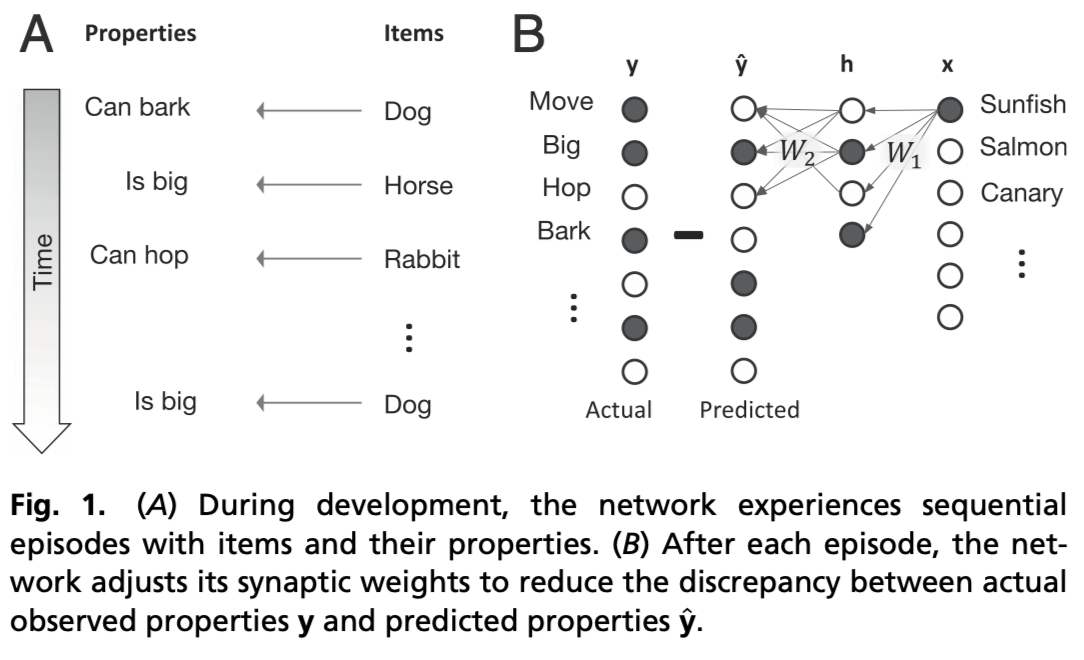
Die Autoren stellen Differentialgleichungen dar und lösen sie, wie sich Gewichte im Laufe der Zeit ändern, wenn ein tiefes lineares neuronales Netzwerk mithilfe des Gradientenabstiegs trainiert wird. Mit anderen Worten: Das Lernmuster des neuronalen Netzwerks wird in Echtzeit verfolgt.
Durch die Lösung von Differentialgleichungen, wie dem idealen Gasgesetz im vorherigen Beispiel, könnte das Lernen eines neuronalen Netzwerks, das aus Zehntausenden von Elementen besteht, kurz mit einer viel geringeren Anzahl von Variablen erklärt werden.
Die Ergebnisse lassen sich wie folgt zusammenfassen. Neuronale Netze lernen Muster in Daten nicht zufällig,
Es ist gelernt.
Hier finden Sie eine weitere Erklärung zur Bedeutung von Mustern.
Wenn Sie über Daten verfügen, die aus Tieren und ihren Merkmalen bestehen, sind darin mehrere Musterhierarchien vermischt. Zu diesem Zeitpunkt bezieht sich das Muster auf die Unterteilung, die in den Daten erscheint, zum Beispiel „Vogel oder Fisch?“, „Taube oder Spatz?“ In diesem Fall wird die Hierarchie in Muster unterteilt, die in den Daten stark ausgeprägt und wichtiger sind („Vogel oder Fisch?“), und in weniger wichtige Muster, die nur in einem Teil der Daten vorkommen („Taube oder Spatz“).
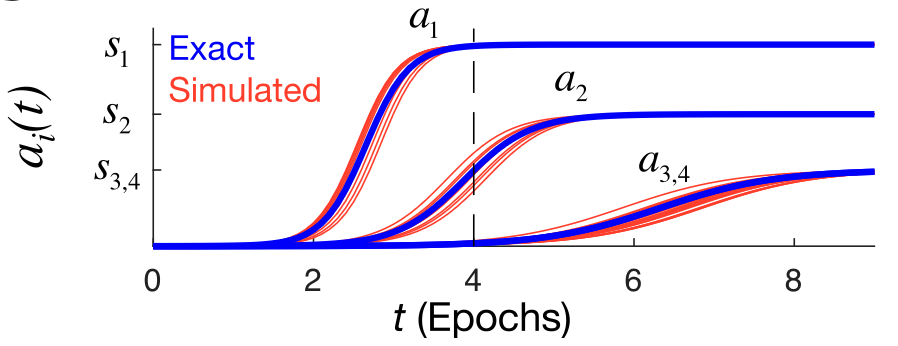
Der Gradientenabstieg erfasst Muster, die zunächst in den gesamten Daten stark auftauchen, und Muster, die später nur in Teilen der Daten auftauchen.
🔢 Kognitionswissenschaft mit Mathematik erklären
Die obigen Ergebnisse erklären verschiedene Phänomene, die die Kognitionswissenschaft in den letzten Jahrzehnten beobachtet hat. Hier sind nur einige davon.
① Große Kategorien („Tiere“) vor kleinen Kategorien („Tauben“) lernen
Kinder verstehen größere Kategorien vor Details. „Vogel“ kommt vor „Taube“, „Tier“ kommt vor „Vogel“ und so weiter.
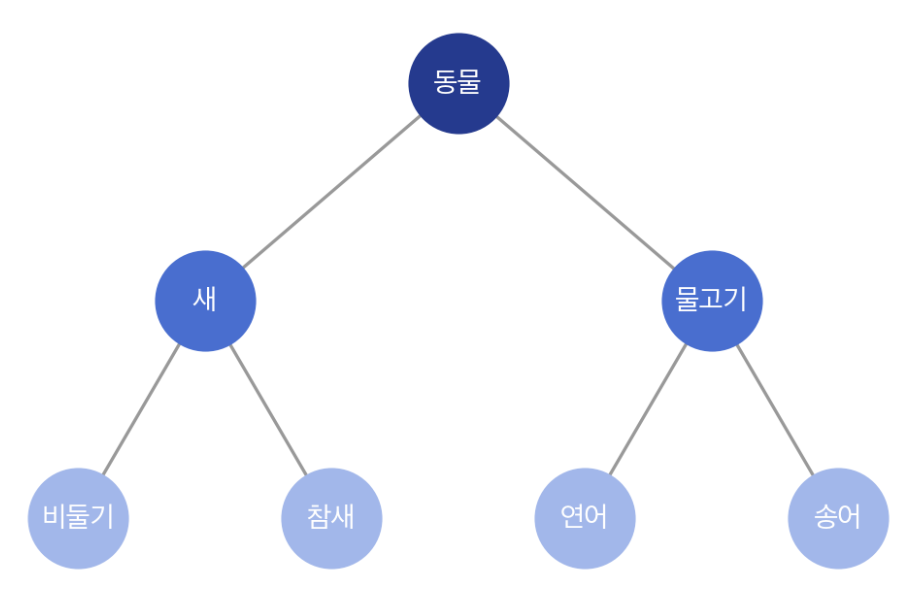
Den Formeln in der Arbeit zufolge ist diese Lernreihenfolge eine mathematische Notwendigkeit.
② Piagets Theorie der kognitiven Entwicklung
Piaget sagte, dass die kindliche Entwicklung nicht kontinuierlich sei. Anstatt sich nach und nach zu verbessern, wiederholt sich das Stadium des plötzlichen Sprungs nach einer langen Phase der Stagnation.
Die aus der Formel abgeleitete S-förmige Kurve passt genau dazu. Und da unterschiedliche Muster zu unterschiedlichen Zeiten übergehen, sehen sie von außen wie „Phasen“ aus.
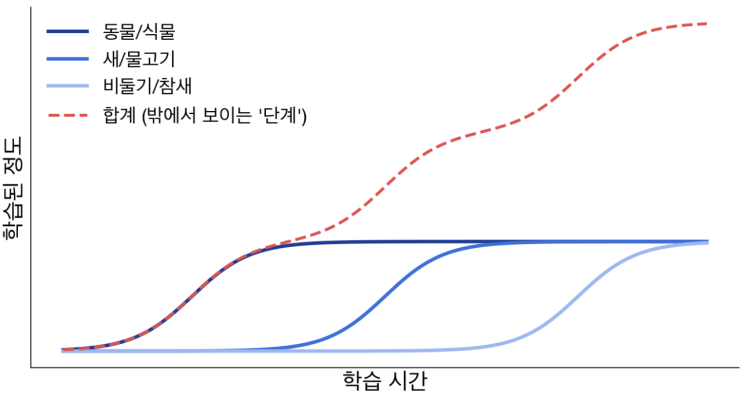
Die Stadien der kindlichen Entwicklung, die Piaget aus jahrzehntelanger Beobachtung von Kindern ableitete, sind auch eine mathematische Notwendigkeit des Lernalgorithmus.
③ U-förmige Lernkurve – Vorübergehende Fehler im Lernprozess von Kindern
Bei Kindern gibt es gemeinsame Lernmuster. Dies ist das Muster „Einmal falsch und dann korrigiert“. Beispielsweise lautet die Antwort auf die Frage „Kann Lachs fliegen?“ zu Beginn des Lernens „Nein“. Aber irgendwann lautet die Antwort für einen Moment „Ja“, um später wieder „Nein“ zu sagen. Das ist allen Kindern gemeinsam. Warum ist das so?
Da Muster in der Reihenfolge ihrer Wichtigkeit erlernt werden, kommt der Punkt, an dem Kinder allgemeine Unterscheidungen („ist/ist kein Tier“), aber noch keine spezifischen Unterscheidungen („Vogel vs. Fisch“) gelernt haben. Wenn wir in diesem Zustand eine Tatsache über die Unterteilung erfahren („Vögel können fliegen“), wendet das Netzwerk, das Vögel und Fische immer noch als dieselbe Gruppe behandelt, die Merkmale von Vögeln auch auf Fische an. Sobald das detaillierte Klassifizierungslernen abgeschlossen ist, verschwinden diese Fehler.
Mit anderen Worten: Diese vorübergehenden Lernfehler, die wir alle in der Kindheit erlebt haben, sind auch eine mathematische Notwendigkeit.
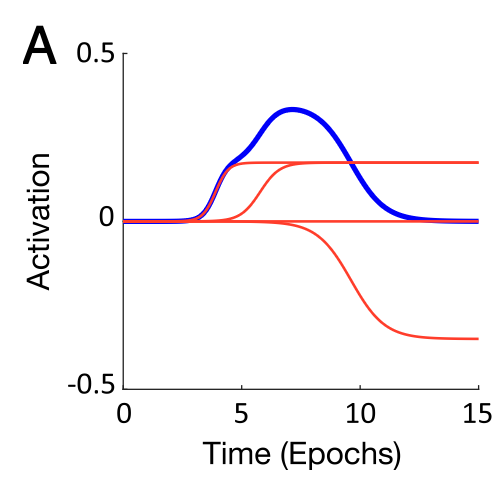
Zusammenfassend lässt sich sagen, dass dieser Artikel alle Phänomene, die von verschiedenen Psychologen durch verschiedene Experimente und durch verschiedene Theorien erklärt wurden, aus Formeln abgeleitet hat, die den Lernprozess tiefer neuronaler Netze ausdrücken.
Die Autoren beschreiben diese Ergebnisse als „mathematisch nachvollziehbares Fenster“ in den Prozess, durch den sich Gehirnrepräsentationen durch Erfahrung entwickeln, obwohl diese einfache Formel nicht das Gehirn selbst ist. Und zum Abschluss des Artikels möchte ich sagen, dass ich hoffe, dass dieses Fenster eines Tages als Sprungbrett dienen wird, um zu enthüllen, wie aus der biologischen Hardware namens Gehirn hochdimensionale Berechnungen des Geistes entstehen.
🧭 Zusammenfassung
Die Geschichte dieser Episode war, dass Mathematik die dritte Sprache war, die Hirnforschung und KI verbindet, und dass daraus zahlreiche kognitionswissenschaftliche Fakten auf einmal erklärt wurden.
Im nächsten Teil werden wir den Beitrag dieser Arbeit zu den einzelnen Bereichen der Hirnforschung und der KI untersuchen und welche Antwort sie auf die langjährige Debatte „Werden Menschen mit einer leeren Tafel geboren?“ geben. Ich werde auch eine kurze Frage-und-Antwort-Runde mit dem Forscher Lee Jin-hwa, Co-Autor dieses Artikels, hinzufügen.
#Technisches Aufgabendiagramm #KI #Gehirnwissenschaft #Kognitionswissenschaft #Deep Learning #Papiereinführung