
In het vorige artikel bespraken we een Duitse rechtszaak. Maar hoe zit het in de Verenigde Staten, de thuisbasis van veel AI-bedrijven?
Om met de conclusie te beginnen: Amerikaanse rechters oordelen anders dan Duitse. Zij neigen ernaar AI-training als fair use te zien. Opvallend is wel dat veel geschillen niet eindigen met een vonnis, maar met een enorme schikking.
In dit artikel bekijken we drie grote Amerikaanse zaken over AI-training.
⚖️ De weegschaal van fair use
Eerst iets over fair use in het Amerikaanse auteursrecht. Deze uitzondering staat gebruik zonder toestemming toe. Rechters wegen vier factoren af.
Bij AI-training draaien de geschillen feitelijk om de eerste en de vierde factor. Vervangt een AI die boeken leest en taalpatronen leert het origineel, of maakt zij er iets wezenlijk anders van — transformatief gebruik? En verdringt het resultaat de markt voor het origineel — markteffect?
Hier staan aard en gevolgen van het gebruik centraal, niet de aanwezigheid van het werk. Dat is een ander vertrekpunt dan de Duitse vraag uit het vorige artikel: blijft het werk in het AI-model bewaard?
📕 Eerste zaak — Thomson Reuters v. Ross Intelligence[1]: fair use voor het eerst afgewezen
Het begon met een geweigerde licentie. De juridische AI-start-up Ross Intelligence wilde voor een zoekdienst voor rechtspraak gegevens gebruiken van Westlaw, de juridische onderzoeksdienst van Thomson Reuters. Die weigerde uit vrees voor een concurrent.
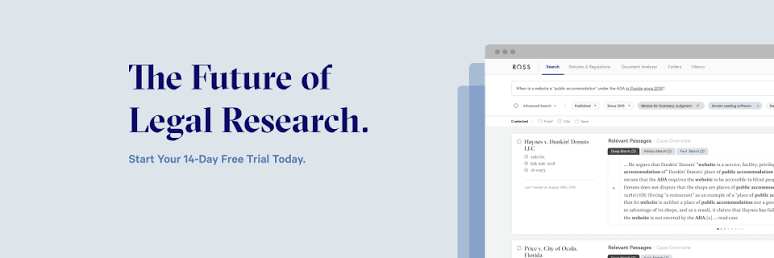
Ross koos vervolgens een omweg. Het liet een externe onderneming juridische memo’s opstellen, maar die bleken feitelijk gebaseerd op Westlaws samenvattingen van rechterlijke uitspraken, de zogeheten headnotes.
De rechter oordeelde eerst dat die headnotes geen eenvoudige uittreksels waren, maar creatieve werken waarin redactionele keuzes besloten lagen. Het gebruik ervan voor training was geen fair use.
De belangrijkste kwestie was de vierde factor: het markteffect. Ross wilde immers een direct concurrerend alternatief voor Westlaw maken. Ook de potentiële markt waarop Thomson Reuters trainingsgegevens aan AI-bedrijven had kunnen licentiëren, werd geraakt. Vooral dat laatste is belangrijk: daarmee erkende de rechter het bestaan van een licentiemarkt voor trainingsdata.
Er geldt wel een belangrijke beperking. De AI van Ross was zoekgericht, niet generatief, en de rechter maakte duidelijk dat de uitspraak niet zonder meer voor generatieve AI gold.
[1] Thomson Reuters v. Ross Intelligence — Federale rechtbank van Delaware, uitspraak februari 2025. Ross vroeg tussentijds hoger beroep aan; het federale hof van beroep voor het derde circuit stond dat in juni 2025 toe. Op 11 juni 2026 vond de mondelinge behandeling plaats, zaaknummer 25-2153. Er is nog geen uitspraak.
Ross Intelligence heeft zijn activiteiten inmiddels gestaakt omdat het de proceskosten niet meer kon dragen.
📗 Tweede zaak — Bartz v. Anthropic[2]: trainen mag, piraterij niet
Thrillerauteur Andrea Bartz en twee andere schrijvers spanden in augustus 2024 een zaak aan tegen Anthropic. Volgens hen had het bedrijf grote aantallen beschermde boeken gedownload van schaduwbibliotheken zoals LibGen om Claude te trainen. Ook boeken die uiteindelijk niet voor training zouden worden gebruikt, bleven permanent in een interne bibliotheek staan.
Rechter William Alsup splitste de handelingen in drie categorieën. Juist die opsplitsing vormt de kern van het vonnis.
Een rechtmatig trainingsdoel maakt de manier waarop de gegevens zijn verkregen dus niet automatisch rechtmatig.
[2] Bartz v. Anthropic — Federale rechtbank voor Noord-Californië, juni 2025, rechter William Alsup. LLM-training met rechtmatig verkregen boeken en digitalisering van gekochte boeken vielen onder fair use; het downloaden en bewaren van illegale kopieën niet.
Het derde onderdeel ging uiteindelijk naar een juryprocedure. De wettelijke schadevergoeding in het Amerikaanse auteursrecht kan oplopen tot 150.000 dollar per werk. Bij zeven miljoen boeken zou dat rekenkundig het voortbestaan van het bedrijf bedreigen. Anthropic schikte daarom voor 1,5 miljard dollar. Op 20 juli werd de schikking definitief goedgekeurd[3]. De rechtbank noemde haar de grootste collectieve auteursrechtschikking ooit.
[3] Schikking in de zaak Bartz — Definitief goedgekeurd op 20 juli 2026. Totaal 1,5 miljard dollar, voor circa 482.000 werken.
De schrijvers betoogden ook dat Claude door de training vergelijkbare boeken kon schrijven en zo hun markt zou aantasten. Alsup wees dit argument af. Bij zijn uitleg van transformatief gebruik vergeleek hij het met klagen dat goed schrijfonderwijs aan kinderen nieuwe concurrerende boeken oplevert. Het auteursrecht beschermt concrete uitdrukkingsvormen, geen recht om nieuwe concurrerende werken tegen te houden.
📘 Derde zaak — Kadrey v. Meta[4]: gewonnen, maar geen volledige overwinning
Dertien schrijvers, onder wie Sarah Silverman, klaagden Meta aan. Wie alleen naar de uitkomst kijkt, ziet een overwinning voor Meta. Maar het vonnis verdient nauwkeurige lezing.
Rechter Vince Chhabria onderschreef nadrukkelijk de theorie van marktverwatering, market dilution. Wanneer generatieve AI onbeperkt soortgelijke werken op de markt brengt, kunnen vraag naar de originelen en de prikkel om te creëren instorten. Als dat wordt bewezen, kunnen eisers volgens hem de vierde factor, en zelfs het hele fair-usegeschil, winnen. Hij wees ook Alsups vergelijking met schrijfonderwijs aan kinderen expliciet af als ongeschikt.
Maar de dertien eisers hadden geen enkel bewijs van marktverwatering ingediend. Meta onderbouwde dat zijn training de boekverkoop niet had beïnvloed; de eisers leverden geen tegenbewijs en bestreden dit punt onvoldoende. Chhabria kon daardoor alleen Meta gelijk geven. Hij schreef echter nadrukkelijk dat het vonnis niet betekende dat Meta’s gebruik rechtmatig was, alleen dat deze eisers de verkeerde argumenten hadden aangevoerd en geen dossier hadden opgebouwd voor de juiste.
[4] Kadrey v. Meta — Federale rechtbank voor Noord-Californië, juni 2025, rechter Vince Chhabria. De training van Llama werd als fair use aangemerkt, uitdrukkelijk omdat de eisers geen bewijs van marktverwatering hadden ingebracht. Vorderingen over verspreiding, seeding, tijdens torrentdownloads lopen afzonderlijk door.
Vergeleken met de tweede zaak gebruikten twee uitspraken van dezelfde rechtbank, met twee dagen ertussen, dus tegengestelde redeneringen. Ook binnen de VS bestaat nog geen eensluidend antwoord.
🧭 Tot slot
Op basis van deze drie zaken kan de Amerikaanse benadering zo worden samengevat:
Er is een zaak die als mogelijke eerste bewijsproef wordt gevolgd. In de procedure van The New York Times tegen OpenAI[5] beval de rechtbank afgelopen januari alle twintig miljoen geanonimiseerde ChatGPT-gesprekslogboeken over te leggen. Als daaruit marktschade blijkt, bijvoorbeeld dat ChatGPT routinematig inhoud produceerde die betaalde artikelen vervangt, kan voor het eerst worden bewezen wat de schrijvers in de Meta-zaak niet konden aantonen.
[5] The New York Times Co. v. Microsoft Corp. & OpenAI — Federale rechtbank voor Zuid-New York, zaak 1:23-cv-11195, rechter Sidney Stein. Aangespannen in december 2023. In april 2025 wees de rechter OpenAI’s verzoek tot afwijzing grotendeels af, verwierp de stelling dat AI-training inherent transformatief is en oordeelde dat fair use feitelijk onderzoek vereist. De zaak is met vergelijkbare procedures van media en schrijvers gebundeld in multidistrict litigation MDL No. 3143 bij dezelfde rechter. In augustus 2026 loopt de bewijsuitwisseling; een procesdatum is niet vastgesteld.
Zo verschillen de antwoorden op de twee continenten die we in twee artikelen bekeken. Duitsland stelt dat training met reproducties buiten het noodzakelijke bereik een licentie vereist. De VS noemen training transformatief en dus fair use, maar houden verkrijgingswijze en markteffect als voorwaarden open.
Welke richting zal Korea kiezen? De uitkomst kan sterk verschillen naargelang de belangrijkste vraag: in welke vorm blijft een werk in het model achter, of is het gebruik transformatief en wat doet het met de markt? Er loopt momenteel overleg over een TDM-uitzondering; daarin zal de koers waarschijnlijk duidelijker worden.
#TussenTechnologieEnRegels #AIAuteursrecht #FairUse #Anthropic #TDM #GeneratieveAI