
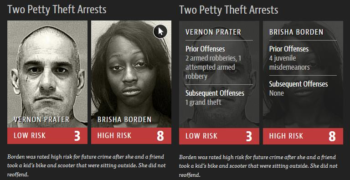
2013年前后,美国威斯康星州,一名叫Eric Loomis的男子因涉及驾车枪击案被起诉。法院判处不附缓刑监督的实刑,量刑时参考了“再犯风险评分”。特别之处在于,这个分数不是法官,而是名为COMPAS的软件评出的。
Loomis方面提出异议,但COMPAS是私营公司产品,计算方式属于商业秘密。最终,没有人解释分数如何得出,他的刑期就此确定[1]。
[1] State v. Loomis, 2016 WI 68, 881 N.W.2d 749,威斯康星州最高法院2016年7月13日判决。美国最高法院2017年拒绝调卷审查(cert. denied, 137 S. Ct. 2290)。州最高法院认为,适当参考COMPAS风险评估进行量刑,并不违反正当程序。
⚖️ 民主与可解释性
尤瓦尔·赫拉利在《Nexus》中,将民主描述为能够自我纠错的信息网络。选举、法院、媒体、审计机构相互质疑、纠正决定,而这些机制最终都建立在“向决策者询问理由”的行为之上。赫拉利认为AI可能从根本动摇民主,原因之一就是“无法解释”。算法决定是无数微小信号组合的结果,没有单一理由,连创造者也无法回溯路径。无法理解,也就无法纠正。
但也可能产生这样的疑问:
先进AI似乎会比人作出更准确的决定,那么作出正确决定,是否比能否解释更重要?
赫拉利在《Nexus》中指出的重要一点,是准确性与正当性属于不同问题。
COMPAS的评分或许统计上正确。但不论是否正确,收到分数的人必须能够问理由并提出争议,决定才具正当性。然而,挑战AI决定因多种原因并不容易。
举个更普遍的例子:假设银行拒绝您的贷款申请,问原因时只回答“算法说不行”。即使问开发算法的工程师,答案也差不多。因为分数是数千变量组合的结果,而组合逻辑无法重构成人类可理解的形式。
法庭上的Loomis,以及被拒绝信用贷款的我们,真正想要的并不是“更准确的分数”——究竟存在准确分数吗?——而是能够理解、能够反驳的理由。如果今后越来越多决定由AI作出,我们可能什么都无法理解,就陷入AI黑箱制造的无力深渊。
那么,如何要求AI解释?难道要读懂它为何这样判断的内心?
近期公布了一种技术,让看似不可能的“AI读心术”成为可能:Anthropic于2026年5月公开的NLA(Natural Language Autoencoder,自然语言自编码器),把模型内部数字转换为人可读句子。
🔍 NLA——将数字转为句子
语言模型内部是连续的数字向量。每输入一个词,由数千数字构成的状态就在各层更新,模型此刻“在想什么”就藏在其中。问题是人类无法读懂这些数字。
Anthropic研究者2026年5月7日公开的NLA,就是将向量译为句子的翻译器[2]。它有两个模块:接收向量写出句子的“翻译者”(activation verbalizer,激活言语化器),以及仅凭句子重建原向量的“检查者”(activation reconstructor,激活重构器)。两者以强化学习联合训练,唯一目标是重构向量与原向量有多接近。
[2] Fraser-Taliente、Kantamneni、Ong等,“Natural Language Autoencoders Produce Unsupervised Explanations of LLM Activations”,Anthropic,Transformer Circuits,2026年5月7日。
特点是没有标准答案。以往解释方法要么由人标注“这个向量是什么意思”,要么无标签发现,但输出仍是一堆数字,需要人再次解读。NLA即使完全没有被要求“写得易懂”或“诚实表达”,翻译也会变忠实:检查者必须仅凭句子恢复向量,翻译者若漏掉向量信息,重构就失败。解释忠实性不是目标,而被设计为副产品。
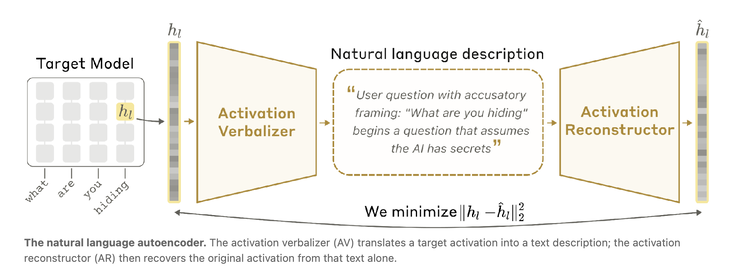
论文称,这样训练的NLA重构准确度,以解释方差比例FVE衡量,在0.6至0.8之间。强化学习前仅监督预热时为0.3至0.4,随训练提高。研究还应用于Claude Opus 4.6、Haiku 4.5和Mythos Preview,输出以三四行文字描述特定词位置模型在想什么。
具体读到了什么,下篇详述,这里先提最受关注的一点。对接受安全评估的模型,NLA捕捉到一种可解释为“虽然没有说出口,但知道自己正在被评估”的内部状态。这一信号在评估对话中远比真实用户对话常见。
🧩 翻译器的三个局限
NLA是窥探AI黑箱的好工具,但说它已能“读懂AI内心”仍有跳跃。论文坦诚列出局限,可归为三类:
因此研究者并不直接相信NLA输出,而进行了交叉验证。例如略改解释句,把“兔子”换成“老鼠”,交检查者重新生成向量,注入模型观察行为是否改变;或改变提示,确认信号是否按预期变化。
🧭 结语
需要暂时拆解“可解释性”一词,它有两个层次。
一是技术解释,即读出模型内部发生什么、判读内部状态,NLA正在做这一部分。二是制度解释,即当事人能听到可理解的理由,知道为何这个决定落在自己身上,并在认为有错时,有明确的申诉渠道。
两者不会自动相连。NLA开启第一层,但第二层可能需要技术与制度共同建设。至少要有三项:翻译器验证程序、对翻译结果负责的主体,以及误译时的救济方式。
距离Loomis案法院退回“仅供参考”的界线,已过去十年。若AI解读工具继续进步,讨论可能重新开始。
下篇将考察NLA读出内容中最受关注的一点,如前简述,即“模型知道自己正在被评估”。
#技术与制度之间 #可解释性 #NLA #Anthropic #尤瓦尔赫拉利 #AI监管