
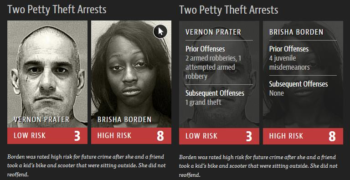
2013年頃、米国ウィスコンシン州。エリック・ルミスと呼ばれる男性は、車両の銃撃事件に関連する容疑で起訴され、法廷に立った。ルミスには保護観察のない実刑が宣告されたが、量刑段階で裁判所は「再犯リスクスコア」を参考にした。珍しいのは、この再犯リスクスコアが判事ではなく、COMPASというソフトウェアが付けられたものだったということです。
ルミス側はこの判断に異議を申し立てたが、COMPASは民間企業の製品であり、計算方式は営業秘密であった。結局、そのスコアがどのように出てきたかは誰も説明していないまま、ルミスの刑量は確定されました[1]。
[1] State v. Loomis, 2016 WI 68, 881 N.W.2d 749 (Wis. 2016. 7. 13. 宣告).米国連邦最高裁判所は2017年に上告を棄却した(cert. denied, 137 S. Ct. 2290)。ウィスコンシン州最高裁判所は、量型でCOMPASリスク評価の参考が適切に行われた場合、適法手続きに違反しないと見た。
⚖️民主主義と説明可能性
誘発ハラリは『ネクサス』で民主主義を自ら誤りを直す情報網として説明します。選挙と裁判所、マスコミ、監査機関がお互いの決定を問い直す仕組みであり、これらの装置は結局「決定した者に理由を問う行為」に基づいています。ハラリがAIを民主主義を根本的に振ることができると見る理由の一つが、まさに「説明できない」です。アルゴリズムの決定は、数多くの微細な信号を組み合わせた結果であり、ただ一つの理由であることはなく、作った人でさえその経路を振り返ることができません。理解できないものは直すこともできません。
しかし、この疑問があるかもしれません:
発展したAIは人間よりも正確な決定をしそうだが、正しい決定をすることが説明可能かどうかよりも重要なのではないだろうか?
『ネクサス』でハラリが追い出した重要なポイントは、精度と正当性が異なる問題ということです。
COMPASのスコアが統計的に合っている可能性があります。しかし当たったのとは別に、そのスコアを受けた人が理由を尋ねて争うことができなければ決定に正当性が生じます。しかし、AIが下した決定を争うのは、多くの理由で容易ではありません。
もっと普遍的な例を挙げましょう。銀行があなたの融資申請を拒否したとしましょう。理由を尋ねれば銀行は「アルゴリズムにならないと言った」とだけ答えます。そのアルゴリズムを作成したエンジニアに尋ねても、答えはあまり変わりません。何千もの変数を組み合わせたスコアであり、その組み合わせの論理は人間が理解できる形に再構成されないからです。
法廷でのルミスも、信用ローンを拒否された私たちも本当に欲しいのは「より正確なスコア」ではありませんでした(もともと正確なスコアというのが存在するのでしょうか?)。なぜそのような結果が出たのか、「納得して反論できる理由」でした。今後ますます多くの決定がAIを介して行われると、私たちは何も納得できないままAIのブラックボックスが作る無気力のガタガタに陥ってしまいます。
それでは、AIに説明を求めることができますか? AIになぜそんな判断をしたのか、その心を読んでもいいのでしょうか?
どうやら不可能に見えたこの「AI毒心術」を可能にする技術が最近発表されました。 2026年5月、アントロピックが公開したNLA(Natural Language Autoencoder)です。モデル内部の数字を人が読む文章に移す装置です。
🔍 NLA — 数字を文章に移動する
言語モデルの内部は数値ベクトルの連続です。単語一つが入るたびに数千の数字の状態が階ごとに更新され、その数字のどこかにモデルが今「何を考えているのか」が込められています。問題は、その数字を人間が読むことができないということでした。
アントロピック研究者が2026年5月7日に公開した NLAは、このベクターを文章に移す翻訳機です[2]。 NLAは2つのモジュールで構成されています。 1つはベクトルを受け取り、文を書く翻訳者(activation verbalizer)、もう1つはその文だけを見て元のベクトルを復活させる検査官(activation reconstructor)です。両方を強化学習で一緒に訓練するが、目標はただ一つ、検査官が蘇ったベクトルがオリジナルにどれだけ近いかです。
[2] Fraser-Taliente、Kantamneni、Ongら、「Natural Language Autoencoders Produce Unsupervised Explanations of LLM Activations」、Anthropic、Transformer Circuits、2026年5月7日。
特徴は正解がないという点です。従来の解釈方法は、人が「このベクトルはこんな意味」とラベルを付けて教えるか、ラベルなしで見つけられますが、結果が数字の塊として出て再び人が読まなければなりませんでした。一方、NLAは翻訳者に「読みやすく」、「正直に書く」という指示が全くないにもかかわらず翻訳が忠実になります。検査官が文章だけを見てベクトルを復活させなければならないので、翻訳者がベクトルに込めた情報を欠くと復元が失敗するからです。説明の忠実性が目標ではなく、副産物として設計されたわけです。
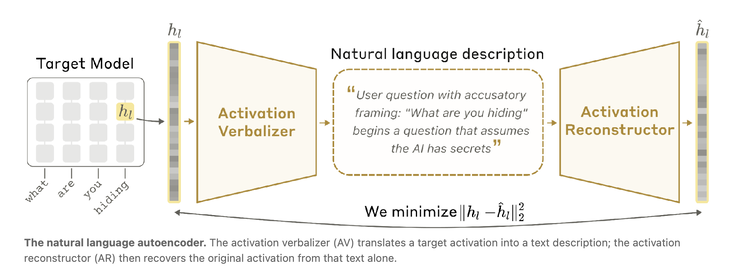
論文によると、このように訓練されたNLAの復元精度(説明された分散率、FVE)は0.6から0.8の間です。強化学習前に監督学習で予熱だけした時の0.3~0.4から出発し、学習が進むほど上がりました。 Claude Opus 4.6とHaiku 4.5、Mythos Previewにも適用しました。結果は、特定の単語の位置でモデルが何を考えているのか、3行の文章から来ます。
何を読んだのかは次の部分で詳しく取り上げますが、最も注目を集めた内容を一行だけ書き留めます。安全評価中のモデルの内部で、モデルが「(表では言っていませんが)今評価されていることを知っている」 はと解釈される状態をNLAが捉えました。実際のユーザー会話よりも評価用会話でこのシグナルがはるかに頻繁に現れました。
🧩トランスレータの3つの制限
NLAはAIブラックボックスの秘密を垣間見ることができる素晴らしいツールですが、まだ「AIの心を読むことができる」という秘訣があります。論文は自分の限界をかなり率直に書き留めました。
そこで研究陣もNLAの出力をそのまま信じておらず、交差検証を行ったそうです。説明文を少し直して(例えば「ウサギ」を「ネズミ」に)検査官に再びベクトルにさせた後、モデルに注入して行動が変わるかどうかを見たり、プロンプトを変えて信号が期待通りに動くか確認するなどの方式です。
🧭仕上げ
しばらく「説明可能性」という言葉を一度分解してみる必要があります。説明可能性には2つの階層があります。
1つは技術的な説明です。モデル内で何が起こったのかを読み出すこと、つまり内部状態の読み取りを意味し、NLAがこの部分をこなしています。もう一つは、制度的説明です。なぜ私にこの決定が下されたのか当事者が納得できる理由で聞いて、間違ったと思えばどこに異議を申し立てるのかが決まっている状態と見ることができます。
どちらも自動的には続きません。 NLAは最初の説明可能性を開きましたが、2番目はおそらく技術だけではなく、制度が一緒に作らなければならない領域であるようです。少なくとも3つの翻訳者の検証手順、翻訳結果に責任がある主体、誤訳があったときの救済方法などが用意されなければなりません。
ルミス事件で裁判所が「参考にせよ」という線に退いてから10年が経ちましたが、AIリーダーが今後さらに発展するならば、議論は再開されるかもしれません。
次に、NLAが読んだ内容の中で最も注目されている部分を見てみましょう。先ほどちょっと紹介したように、「モデルが自分が評価されていることを知っている」という部分です。
#技術課題の間で#説明可能性#NLA#アントロピック#誘発原理#AI規制