
Im vorigen Beitrag betrachteten wir deutsche Gerichtsverfahren. Wie sieht es in den USA aus, der Heimat der großen KI-Unternehmen?
Vorweg: Amerikanische Gerichte urteilen anders als deutsche. Sie sehen KI-Training eher als Fair Use. Bemerkenswert ist allerdings, dass viele Trainingsstreitigkeiten nicht durch Urteile, sondern durch enorme Vergleiche beendet werden.
Hier betrachten wir drei wichtige US-Verfahren zum KI-Training.
⚖️ Die Waage des Fair Use
Zunächst zum Fair Use im US-Urheberrecht. Diese Ausnahme erlaubt, fremde Werke ohne Erlaubnis zu nutzen. Gerichte prüfen vier Faktoren:
Beim KI-Training sind praktisch der erste und vierte Faktor umstritten. Ersetzt das Lesen von Büchern und Erlernen von Sprachmustern durch KI die Originale, oder verwandelt es sie in etwas ganz anderes — Transformativität? Und verdrängt das Ergebnis den Markt der Originale — Marktauswirkungen?
Es geht um Art und Folgen der Nutzung statt um das Vorhandensein des Werks. Der Ausgangspunkt unterscheidet sich somit grundsätzlich von der deutschen Frage im vorigen Artikel, ob das Werk im Modell erhalten bleibt.
📕 Erstens — Thomson Reuters gegen Ross Intelligence[1]: die erste Ablehnung von Fair Use
Ausgangspunkt war eine verweigerte Lizenz. Das Legal-AI-Start-up Ross Intelligence wollte für eine Rechtsprechungssuche Daten aus Thomson Reuters’ Recherchedienst Westlaw nutzen. Thomson Reuters verweigerte dies aus Sorge vor einem Konkurrenten.
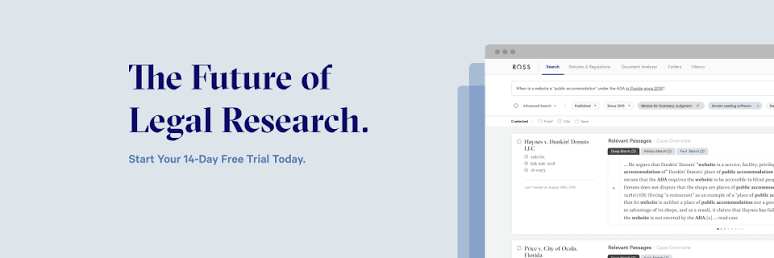
Ross wählte einen Umweg: Ein externer Anbieter sollte juristische Vermerke erstellen. Diese beruhten faktisch auf Westlaws Rechtsprechungszusammenfassungen, den Headnotes.
Das Gericht sah die Headnotes zunächst als schöpferische Werke mit redaktionellen Entscheidungen und nicht bloß als Urteilsauszüge an. Für ihre Verwendung zum Training verneinte es Fair Use.
Im Mittelpunkt stand der vierte Faktor, die Marktwirkung. Ross wollte einen unmittelbar mit Westlaw konkurrierenden Ersatz schaffen und beeinträchtigte zugleich den potenziellen Markt, auf dem Thomson Reuters Trainingsdaten hätte lizenzieren können. Gerade der letzte Punkt ist wichtig: Das Gericht erkannte damit einen Markt für Trainingsdatenlizenzen an.
Eine wichtige Einschränkung bleibt: Ross’ KI war suchbasiert, nicht generativ. Das Gericht stellte ausdrücklich klar, dass seine Beurteilung nicht unverändert für generative KI gilt.
[1] Thomson Reuters gegen Ross Intelligence — US District Court for the District of Delaware, Urteil vom Februar 2025. Ross beantragte eine Zwischenberufung, die der Third Circuit im Juni 2025 zuließ. Die mündliche Verhandlung fand am 11. Juni 2026 statt (Aktenzeichen 25-2153). Ein Urteil liegt noch nicht vor.
Ross Intelligence hat inzwischen den Betrieb eingestellt, weil es die Prozesskosten nicht tragen konnte.
📗 Zweitens — Bartz gegen Anthropic[2]: Training ja, Raubkopien nein
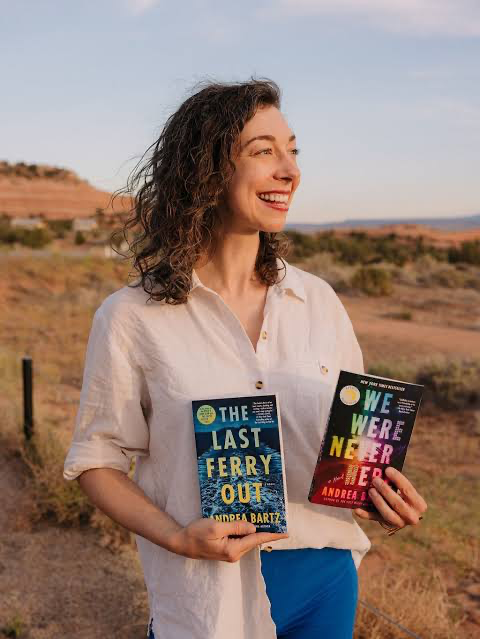
Die Thrillerautorin Andrea Bartz und zwei weitere Autoren verklagten Anthropic im August 2024. Sie warfen dem Unternehmen vor, urheberrechtlich geschützte Bücher massenhaft aus Schattenbibliotheken wie LibGen heruntergeladen und für Claude-Training verwendet zu haben. Auch Bücher, die nicht mehr zum Training vorgesehen waren, seien dauerhaft in einer internen Bibliothek behalten worden.
Richter Alsup teilte das Verhalten in drei Kategorien. Diese Aufgliederung ist der Kern des Urteils.
Auch bei einem legitimen Trainingszweck wird also die Art der Datenbeschaffung gesondert geprüft.
[2] Bartz gegen Anthropic — US District Court for the Northern District of California, Urteil vom Juni 2025, Richter William Alsup. LLM-Training mit rechtmäßig erworbenen Büchern und Digitalisierung gekaufter Bücher galten als Fair Use; Download und Aufbewahrung von Raubkopien nicht.
Die dritte Kategorie ohne Fair-Use-Schutz sollte letztlich vor Geschworenen verhandelt werden. Das US-Urheberrecht erlaubt gesetzlichen Schadensersatz bis zu 150.000 Dollar pro Werk. Bei sieben Millionen Büchern könnte die rechnerische Summe die Existenz des Unternehmens gefährden. Anthropic einigte sich schließlich auf 1,5 Milliarden Dollar; der Vergleich wurde am 20. Juli endgültig genehmigt[3]. Das Gericht bezeichnete ihn als größten Urheberrechts-Sammelvergleich der Geschichte.
[3] Bartz-Vergleich — endgültig genehmigt am 20. Juli 2026, insgesamt 1,5 Milliarden Dollar für etwa 482.000 Werke.
Die Autoren argumentierten außerdem, Claude könne durch dieses Training ähnliche Bücher schreiben und damit ihren Markt verdrängen. Richter Alsup wies die Sorge zurück. Zur Transformativität verglich er die Argumentation damit, sich darüber zu beklagen, dass guter Schreibunterricht für Kinder konkurrierende Werke hervorbringe. Das Urheberrecht schützt bestimmte Ausdrucksformen, nicht das Recht, neue Konkurrenzwerke zu verhindern.
📘 Drittens — Kadrey gegen Meta[4]: ein Sieg, der keiner ist
Dreizehn Autoren, darunter Sarah Silverman, verklagten Meta. Dem Ergebnis nach gewann Meta, doch das Urteil verdient genaue Lektüre.
Richter Chhabria befürwortete ausdrücklich die Theorie der Marktverwässerung (Market Dilution): Wenn generative KI unbegrenzt ähnliche Werke auf den Markt bringt, können Nachfrage nach Originalen und Schaffensanreize zusammenbrechen. Werde dies bewiesen, könnten Kläger beim vierten Fair-Use-Faktor und sogar in der gesamten Fair-Use-Frage gewinnen. Alsups Vergleich mit Schreibunterricht für Kinder wies er ausdrücklich als unpassend zurück.
Die dreizehn Kläger legten jedoch keinerlei Beweise für Marktverwässerung vor. Meta präsentierte Material, wonach das Training die Buchverkäufe nicht beeinträchtigt habe. Die Kläger brachten weder Gegenbeweise noch setzten sie sich angemessen damit auseinander. Daher musste Chhabria für Meta entscheiden. Er stellte aber ausdrücklich klar: Das Urteil besage nicht, dass Metas Nutzung rechtmäßig sei, sondern nur, dass diese Kläger die falschen Argumente vorgebracht und für die richtigen keine hinreichende Tatsachengrundlage geschaffen hätten.
[4] Kadrey gegen Meta — US District Court for the Northern District of California, Urteil vom Juni 2025, Richter Vince Chhabria. Fair Use für Llama-Training wurde anerkannt, ausdrücklich wegen fehlender Beweise der Kläger zur Marktverwässerung. Ansprüche wegen Verbreitung durch Torrent-Seeding beim Herunterladen werden gesondert weiterverfolgt.
Im Vergleich zum zweiten Fall wählten also zwei Entscheidungen desselben Gerichts im Abstand von zwei Tagen entgegengesetzte Begründungen. Auch innerhalb der USA gibt es noch keine einheitliche Antwort.
🧭 Abschließende Gedanken
Aus den drei Fällen lässt sich die US-Position so zusammenstellen:
Ein Verfahren gilt als möglicher erster Nachweis: In der Klage der New York Times gegen OpenAI[5] ordnete das Gericht im Januar die Vorlage aller zwanzig Millionen anonymisierten ChatGPT-Gesprächsprotokolle an. Zeigen sie Anzeichen von Marktschäden, etwa eine regelmäßige Erzeugung von Ersatz für kostenpflichtige Artikel, könnte erstmals gelingen, was die Autoren im Meta-Fall nicht schafften: der Beweis einer Marktbeeinträchtigung.
[5] The New York Times Co. gegen Microsoft Corp. und OpenAI — US District Court for the Southern District of New York, Aktenzeichen 1:23-cv-11195, Richter Sidney Stein. Im Dezember 2023 eingereicht. Im April 2025 wies das Gericht OpenAIs Abweisungsantrag weitgehend zurück und lehnte die Behauptung ab, KI-Training sei seinem Wesen nach transformativ. Fair Use erfordere eine Tatsachenprüfung. Das Verfahren wurde mit ähnlichen Klagen anderer Medien und Autoren als Multidistrict Litigation (MDL No. 3143) vor derselben Kammer zusammengeführt. Im August 2026 läuft die Beweisoffenlegung; ein Verhandlungstermin steht nicht fest.
Die Antworten der beiden Kontinente aus diesen zwei Beiträgen unterscheiden sich also. Deutschland verlangt Lizenzen für Training mit über das notwendige Maß hinausgehenden Kopien. Die USA sehen Training als transformativ und damit Fair Use, lassen aber Einschränkungen bei Beschaffungswegen und Marktwirkungen offen.
Welche Richtung wird Südkorea wählen? Je nachdem, welche Frage wichtiger wird — in welcher Form bleibt das Werk im Modell, oder ist die Nutzung transformativ und wie wirkt sie auf den Markt? — können gleiche Sachverhalte sehr unterschiedliche Ergebnisse haben. Derzeit wird die Einführung einer TDM-Ausnahme diskutiert; dabei dürfte die Richtung deutlicher werden.
#ZwischenTechnikUndRegeln #KIUrheberrecht #FairUse #FairUse #Anthropic #TDM #GenerativeKI