
Das im vorigen Beitrag behandelte KI-Rahmengesetz betraf Kennzeichnungspflichten für erzeugte Inhalte, also die Regulierung des Outputs. Bei KI-Streitigkeiten gibt es jedoch am entgegengesetzten Ende eine weitere Front: den Input.
Dass KI-Training enorme Datenmengen erfordert, ist bekannt. Ungeklärt bleibt, wem und wie für diese Trainingsdaten eine Vergütung zusteht — oder ob überhaupt bezahlt werden muss.
Bei neuen Rechtsfragen beginnt oft ein Abwarten, wer den ersten Schritt wagt. Im November 2025 erging in Deutschland ein viel beachtetes Urteil. Vor zwei Wochen, am 31. Juli, folgte ein weiteres mit ähnlicher Stoßrichtung. Beide Fälle möchte ich hier untersuchen.
🇩🇪 Erstes Urteil — „Reproduktion über das Lernen hinaus“
Wissen Sie, wie ein KI-Agent wie ChatGPT derzeit antwortet, wenn man nach dem Text eines bestimmten Liedes fragt?
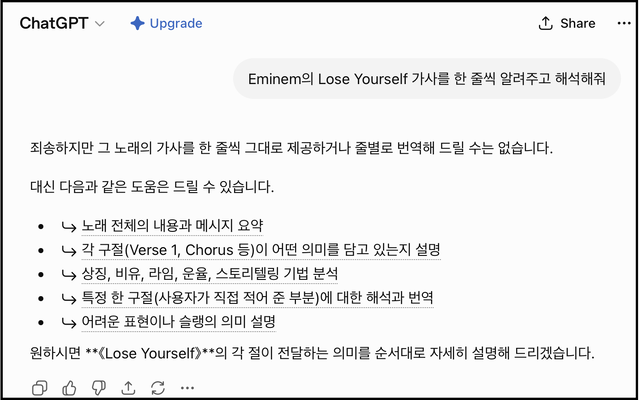
Wie oben gezeigt, gibt ChatGPT den Text nicht direkt aus. Das erste Urteil hängt mit diesem Verhalten zusammen.
Im Verfahren der deutschen Musikverwertungsgesellschaft GEMA gegen OpenAI entschied das Landgericht München I, dass ChatGPT durch unbefugtes Training mit Liedtexten und deren wortgetreue Ausgabe deutsches Urheberrecht verletzte[1]. Es ging um neun bekannte deutsche Lieder, darunter Atemlos, Männer und Über den Wolken.
[1] GEMA gegen OpenAI — Landgericht München I, 42. Zivilkammer, Urteil vom 11. November 2025, Aktenzeichen 42 O 14139/24. Die GEMA beanstandete das unbefugte Training mit und die Ausgabe von Liedtexten durch GPT-4 und GPT-4o.
OpenAI wandte ein, Modelle speicherten keine konkreten Daten, sondern lernten nur statistische Zusammenhänge. Das Gericht akzeptierte das nicht: Schon einfache Prompts wie die Frage nach einem Refrain reproduzierten die Originaltexte fast wörtlich. Es verglich dies mit verlustbehafteter MP3-Kompression. Auch ohne das vollständige Original liege eine Vervielfältigung vor, wenn statistische Informationen eine erkennbare Rekonstruktion ermöglichen. Drei Punkte stehen im Mittelpunkt.
Betrachten wir kurz die TDM-Ausnahme des zweiten Punkts. Text and Data Mining bezeichnet die automatische Analyse von Werken, um Informationen wie Muster, Trends oder Zusammenhänge zu gewinnen. Da Werke dabei zwangsläufig kopiert werden, schuf Europa 2019 mit der Urheberrechtsrichtlinie für den digitalen Binnenmarkt (2019/790) eine Ausnahme von der Rechtsverletzung. Deutschland setzte sie in § 44b UrhG um[2].
§ 44b erlaubt zwar Vervielfältigungen, verlangt aber ihre Löschung, sobald sie für das Mining nicht mehr benötigt werden. Die Ausnahme gilt also während der Analyse, nicht für den weiteren Besitz danach. KI-Modelle boten ihren Dienst jedoch nach dem Training weiter an und behielten die Inhalte in ihren Parametern. An diesem Punkt verneinte das Gericht die Ausnahme.
Das Gericht verpflichtete OpenAI schließlich zur Unterlassung, Auskunft über Umfang der bisherigen Nutzung und erzielte Einnahmen sowie zum Schadensersatz; bei Verstößen drohen 250.000 Euro Ordnungsgeld pro Fall.
🇩🇪 Zweites Urteil — vom Text zur Melodie
Am 31. Juli ging dieselbe Kammer einen Schritt weiter. Diesmal war der KI-Musikdienst Suno betroffen[2].
[2] GEMA gegen Suno — Landgericht München I, 42. Zivilkammer, Urteil vom 31. Juli 2026, Aktenzeichen 42 O 763/25. Die GEMA hatte im Januar 2025 geklagt; das Gericht gab den Ansprüchen auf Unterlassung, Auskunft und Schadensersatz weitgehend statt. Betroffen waren sechs Werke: Atemlos durch die Nacht, Rasputin, Big in Japan, Forever Young, der Refrain von Mambo No. 5 und Daddy Cool. Das Urteil ist noch nicht rechtskräftig.
Die GEMA wies nach, dass Sunos Ergebnisse in Melodie, Harmonie und Rhythmus erheblich mit den Originalen übereinstimmten; die Kammer folgte dem. Dies ist faktisch das erste öffentlich zugängliche Urteil, das KI-generierte Audioinhalte unmittelbar behandelt. Ging es vorher um Liedtexte, also Text, war nun die Musik selbst Gegenstand.
Interessant war Sunos Verteidigung. Das Unternehmen hatte das Training mit dem GEMA-Repertoire bereits eingeräumt. Es bestritt lediglich eine Vergütungspflicht. Auch dass Trainingsdaten per sogenanntem Stream-Ripping von YouTube heruntergeladen worden waren, war unstreitig.
Das Gericht wies diese Argumentation klar zurück und verneinte erneut die TDM-Ausnahme. Suno habe die Werke nicht lediglich analysiert, sondern dauerhaft im Modell gespeichert und als Dienstfunktion genutzt. Damit setzte es die enge Auslegung des acht Monate zuvor ergangenen OpenAI-Urteils fort.
⚖️ Wie steht es um die Zuständigkeit?
Ein weiterer wichtiger Aspekt betrifft den Ort des Trainings.
Suno ist ein US-Unternehmen und trainierte in den USA. Das war bisher eine recht starke Verteidigungslinie für KI-Unternehmen: Auch wenn der Dienst in Europa verfügbar sei, habe das Training außerhalb Europas stattgefunden und könne nicht nach europäischem Recht beurteilt werden.
Diese Argumentation war tatsächlich schon erfolgreich, etwa im Urteil des britischen High Court vom 4. November des Vorjahres in Getty Images gegen Stability AI[3]. Getty Images räumte ein Training außerhalb Großbritanniens ein und musste seinen zentralen Urheberrechtsvorwurf während des Prozesses zurücknehmen. Auch die übrigen Ansprüche wurden abgewiesen; übrig blieb nur eine sehr begrenzte Markenrechtsverletzung bei Wasserzeichen.
[3] Getty Images gegen Stability AI — High Court of England and Wales, Urteil vom 4. November 2025, [2025] EWHC 2863 (Ch), Richterin Joanna Smith. Als Europas erstes KI-Urheberrechtsurteil beachtet, konnte es wegen Zuständigkeits- und anderer Fragen die zentrale Frage nach der Rechtswidrigkeit des KI-Trainings nicht beantworten.
Das Münchner Urteil nimmt KI-Unternehmen jedoch diese Sicherheit. Unabhängig vom Training in den USA bejahte das deutsche Gericht eine Urheberrechtsverletzung durch Bereitstellung des Modells und seiner Ergebnisse in Deutschland. Es ist das erste europäische Urteil, wonach vollständig außerhalb der EU durchgeführtes KI-Training zu deutscher Urheberrechtshaftung führen kann. Der Tenor im zweiten Fall untersagte Suno ausdrücklich, die Werke auf US-Territorium zum Training musikgenerierender KI-Modelle zu vervielfältigen.
Damit ist die Bedeutung viel größer: Die Strategie, in den weniger regulierten USA zu trainieren und lediglich den Dienst in Europa anzubieten, funktioniert zumindest in Deutschland nicht mehr.
Alle Lücken sind damit nicht geschlossen. Die Grundlage für die Beurteilung des US-Trainings war ein besonderer Gerichtsstand, den das Verwertungsgesellschaftengesetz (VGG) Organisationen wie der GEMA gewährt. Offen bleiben, ob einzelne Rechteinhaber dasselbe erreichen könnten, wie der für die Zuständigkeit wichtige Verletzungsort zu bestimmen ist und vor allem, ob sich das deutsche Urteil tatsächlich in den USA anerkennen und vollstrecken lässt.
🧭 Abschließende Gedanken
Streng genommen beurteilten die Urteile nicht eine Vergütung oder Haftung für KI-Lernen selbst, sondern vor allem, ob das Original nach Ende von Training oder Analyse in den Modellparametern reproduzierbar erhalten bleibt.
Ich persönlich vermute allerdings, dass die Diskussion auch künftig um Output und Reproduzierbarkeit kreisen wird, weil sie vergleichsweise eindeutig und nachprüfbar sind. Eine angemessene Vergütung oder den Schaden des KI-Trainings zu beziffern ist außerordentlich schwierig.
Was ist KI-„Lernen“ überhaupt genau? Das Einlesen von Werken selbst oder die dabei entstandene Menge von Gewichten? Wie ähnlich ist es menschlichem Lernen, wie unterschiedlich? Welchem unserer bisherigen Rechtsbegriffe sollten wir es zuordnen?
Die beiden Fälle sind noch nicht abgeschlossen. OpenAI hat mit dem Vorwurf Berufung eingelegt, das Urteil missverstehe die Funktionsweise von KI. Auch das Suno-Urteil ist nicht rechtskräftig. Die Verfahren könnten daher höhere Instanzen oder den Europäischen Gerichtshof (EuGH) erreichen. Wie es ausgeht, dürfte wohl jeder
Im nächsten Beitrag betrachten wir die wichtigsten US-Verfahren zum KI-Training, also im Zentrum der KI-Branche.
#ZwischenTechnikUndRegeln #KIUrheberrecht #GEMA #OpenAI #TDM #GenerativeKI