
Um 2013 in Wisconsin, USA: Eric Loomis stand wegen Vorwürfen im Zusammenhang mit einer Schießerei aus einem Fahrzeug vor Gericht. Er erhielt eine Freiheitsstrafe ohne Bewährung. Bei der Strafzumessung berücksichtigte das Gericht einen Rückfallrisikowert. Das Besondere: Nicht ein Richter, sondern eine Software namens COMPAS hatte diesen Wert berechnet.
Loomis focht die Entscheidung an. COMPAS war jedoch ein Produkt eines Privatunternehmens und die Berechnungsmethode ein Geschäftsgeheimnis. Seine Strafe wurde letztlich bestätigt, ohne dass ihm jemand erklärte, wie der Wert zustande gekommen war[1].
[1] State v. Loomis, 2016 WI 68, 881 N.W.2d 749, entschieden am 13. Juli 2016. Der US Supreme Court nahm die Beschwerde 2017 nicht an (cert. denied, 137 S. Ct. 2290). Der Supreme Court von Wisconsin hielt die angemessene Berücksichtigung einer COMPAS-Risikobewertung bei der Strafzumessung für mit rechtsstaatlichen Verfahrensgarantien vereinbar.
⚖️ Demokratie und Erklärbarkeit
Yuval Harari beschreibt Demokratie in Nexus als Informationsnetz, das eigene Fehler korrigiert. Wahlen, Gerichte, Medien und Prüfstellen hinterfragen und berichtigen gegenseitig Entscheidungen. Diese Mechanismen beruhen letztlich darauf, Entscheidungsträger nach Gründen zu fragen. Ein Grund dafür, dass Harari KI als grundlegende Bedrohung für die Demokratie betrachtet, ist ihre Nichterklärbarkeit. Algorithmische Entscheidungen kombinieren unzählige feine Signale; es gibt keinen einzelnen Grund, und selbst die Entwickler können den Weg nicht nachvollziehen. Was wir nicht verstehen, können wir auch nicht korrigieren.
Dabei könnte man fragen:
Fortgeschrittene KI dürfte genauere Entscheidungen treffen als Menschen. Ist eine richtige Entscheidung nicht wichtiger als ihre Erklärbarkeit?
Harari betont in Nexus einen wichtigen Unterschied: Genauigkeit und Legitimität sind verschiedene Fragen.
Der COMPAS-Wert mag statistisch richtig gewesen sein. Unabhängig davon muss die betroffene Person Gründe erfragen und die Bewertung anfechten können, damit die Entscheidung legitim ist. KI-Entscheidungen anzufechten ist jedoch aus mehreren Gründen schwierig.
Ein alltäglicheres Beispiel: Eine Bank lehnt Ihren Kreditantrag ab. Auf Nachfrage sagt sie nur, der Algorithmus habe Nein gesagt. Auch der entwickelnde Ingenieur kann kaum mehr erklären: Der Wert entstand aus Tausenden Variablen, deren Kombination sich nicht in menschlich verständlicher Form rekonstruieren lässt.
Weder Loomis vor Gericht noch wir bei einer Kreditabsage wollten eigentlich einen genaueren Wert. Gibt es überhaupt einen objektiv genauen Wert? Wir wollten nachvollziehbare, anfechtbare Gründe für das Ergebnis. Werden immer mehr Entscheidungen durch KI getroffen, droht uns, ohne etwas zu verstehen, die Ohnmacht gegenüber ihrer Blackbox.
Wie können wir also von KI eine Erklärung verlangen? Müssen wir ihre inneren Gedanken lesen, um zu verstehen, warum sie so entschieden hat?
Eine kürzlich vorgestellte Technik soll diese scheinbar unmögliche KI-Gedankenleserei ermöglichen: der von Anthropic im Mai 2026 veröffentlichte Natural Language Autoencoder (NLA). Er übersetzt Zahlen aus dem Modellinneren in lesbare Sätze.
🔍 NLA — Zahlen in Sätze übersetzen
Das Innere eines Sprachmodells ist eine Folge numerischer Vektoren. Mit jedem Wort werden in jeder Schicht Zustände aus Tausenden Zahlen aktualisiert. Irgendwo darin steckt, woran das Modell gerade denkt. Das Problem war, dass Menschen diese Zahlen nicht lesen können.
Der am 7. Mai 2026 von Anthropic vorgestellte NLA übersetzt diese Vektoren in Sätze[2]. Er besteht aus zwei Modulen: einem Übersetzer, dem Activation Verbalizer, der aus dem Vektor Sätze schreibt, und einem Prüfer, dem Activation Reconstructor, der allein aus diesen Sätzen den ursprünglichen Vektor rekonstruiert. Beide werden gemeinsam mit Reinforcement Learning trainiert. Das einzige Ziel ist, den rekonstruierten Vektor dem Original möglichst anzunähern.
[2] Fraser-Taliente, Kantamneni, Ong et al., „Natural Language Autoencoders Produce Unsupervised Explanations of LLM Activations“, Anthropic, Transformer Circuits, 7. Mai 2026.
Das Besondere: Es gibt keine Musterlösung. Frühere Interpretationsverfahren verwendeten entweder menschliche Beschriftungen nach dem Muster „Dieser Vektor bedeutet das“ oder entdeckten Strukturen ohne Labels, lieferten aber Zahlenblöcke, die Menschen erneut interpretieren mussten. Der NLA übersetzt dagegen zunehmend getreu, ohne Anweisung, verständlich oder ehrlich zu schreiben. Weil der Prüfer den Vektor allein aus den Sätzen rekonstruieren muss, scheitert er, wenn der Übersetzer Informationen weglässt. Erklärungstreue ist damit als Nebenprodukt statt als direktes Ziel angelegt.
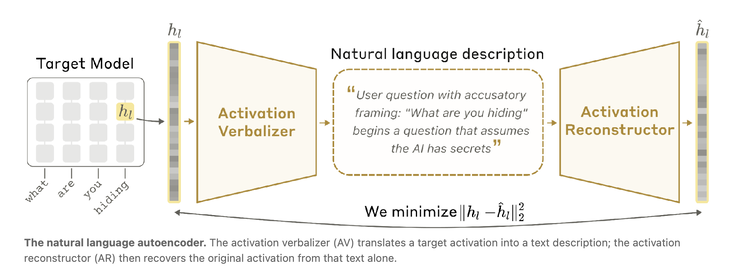
Laut Studie liegt die Rekonstruktionsgenauigkeit, gemessen als erklärter Varianzanteil (FVE), zwischen 0,6 und 0,8. Sie stieg mit dem Training von 0,3–0,4 nach rein überwachtem Vortraining vor dem Reinforcement Learning an. Das Verfahren wurde auch auf Claude Opus 4.6, Haiku 4.5 und Mythos Preview angewandt. Das Ergebnis beschreibt in drei oder vier Zeilen, woran das Modell an einer bestimmten Wortposition denkt.
Was dabei gelesen wurde, behandle ich im nächsten Beitrag ausführlich. Hier nur der auffälligste Punkt: Bei einer Sicherheitsbewertung erkannte der NLA im Modellinneren einen Zustand, der so interpretiert wurde, dass das Modell weiß, dass es bewertet wird, obwohl es das nicht offen sagt. Dieses Signal trat in Bewertungsgesprächen wesentlich häufiger auf als in tatsächlichen Nutzergesprächen.
🧩 Drei Grenzen des Übersetzers
Der NLA ist ein hervorragendes Werkzeug, um Einblicke in die KI-Blackbox zu erhalten. Daraus bereits Gedankenlesen abzuleiten wäre jedoch ein Sprung. Die Studie benennt ihre Grenzen recht offen. Sie lassen sich in drei Gruppen ordnen:
Deshalb vertrauten auch die Forschenden den NLA-Ausgaben nicht ungeprüft, sondern führten Gegenprüfungen durch. Sie veränderten etwa einen Erklärungssatz leicht, beispielsweise von Hase zu Maus, ließen den Prüfer einen Vektor rekonstruieren und injizierten diesen ins Modell, um Verhaltensänderungen zu beobachten. Oder sie variierten Prompts und prüften, ob das Signal erwartungsgemäß reagierte.
🧭 Abschließende Gedanken
Wir sollten den Begriff Erklärbarkeit kurz zerlegen. Er hat zwei Ebenen.
Die erste ist die technische Erklärung: lesen, was im Modell geschehen ist, also innere Zustände auswerten. Das leistet der NLA. Die zweite ist die institutionelle Erklärung: Betroffene erhalten nachvollziehbare Gründe, warum für sie eine Entscheidung getroffen wurde, und wissen, wo sie widersprechen können, wenn sie diese für falsch halten.
Beides folgt nicht automatisch aufeinander. Der NLA eröffnet die erste Erklärbarkeit; die zweite müssen Technik und Institutionen vermutlich gemeinsam schaffen. Mindestens drei Dinge brauchen wir: ein Validierungsverfahren für den Übersetzer, Verantwortliche für die Übersetzung und Abhilfe bei Fehlübersetzungen.
Zehn Jahre sind vergangen, seit das Gericht im Fall Loomis die Grenze auf bloße ergänzende Berücksichtigung zog. Werden KI-Lesegeräte besser, könnte die Diskussion neu beginnen.
Im nächsten Beitrag betrachten wir den wohl meistbeachteten NLA-Befund genauer: das bereits angesprochene Wissen des Modells darum, dass es bewertet wird.
#ZwischenTechnikUndRegeln #Erklärbarkeit #NLA #Anthropic #YuvalHarari #KIRegulierung