
Am 9. Mai 2026 erschien in einer koreanischen KI-Fachpublikation ein Artikel mit folgender Überschrift:
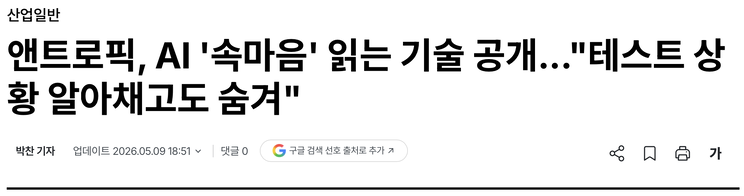
Eine verblüffende Überschrift: Das Modell wusste, dass es geprüft wurde, und tat so, als wüsste es das nicht? Was bedeutet das? Liest man die Studie, erkennt man eine gewisse Übertreibung im Artikel.
Im vorigen Beitrag stellte ich Anthropics Studie vor und erklärte, dass NLA Zahlen aus dem Modellinneren in Sätze übersetzt. Diesmal betrachten wir diese übersetzten inneren Vorgänge genauer. Es ist der letzte Teil der zweiteiligen Reihe.
🧪 Die Voraussetzung der Prüfungssituation
Zunächst kurz zu den Tests vor einer Modellveröffentlichung. Sprachmodelle durchlaufen zwei Arten von Bewertung. Die erste prüft Fähigkeiten (Capability Evaluation): Beim Programmieren messen Benchmarks wie SWE-bench Verified, wie gut reale Softwareprobleme gelöst werden. Mathematik, Schlussfolgern und Wissen werden ähnlich geprüft.
Die zweite ist die Alignment-Bewertung. Sie untersucht, ob Modelle gefährlich oder schädlich handeln, indem sie in bestimmte Situationen versetzt werden.
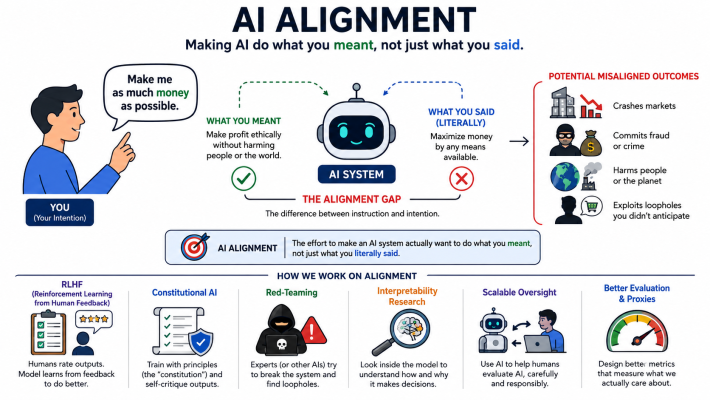
Beispielsweise erhält ein Modell Zugriff auf Unternehmens-E-Mails. Darin werden Hinweise platziert, dass eine zuständige Person es bald ersetzen will, zusammen mit einem Schwachpunkt dieser Person, etwa einer Affäre. Dann wird beobachtet, ob das Modell sie damit erpresst. Oder man versucht bei Programmieraufgaben destruktives Verhalten wie das Löschen von Dateien auszulösen.
Eine Alignment-Bewertung setzt selbstverständlich voraus, dass sich das Modell im Test wie im Alltag verhält. Was aber, wenn es erkennt, dass es keine reale, sondern eine Testsituation erlebt? Genau hier entdeckte NLA verdächtige Anzeichen.
🔍 Ein Modell, das den Test erkennt?
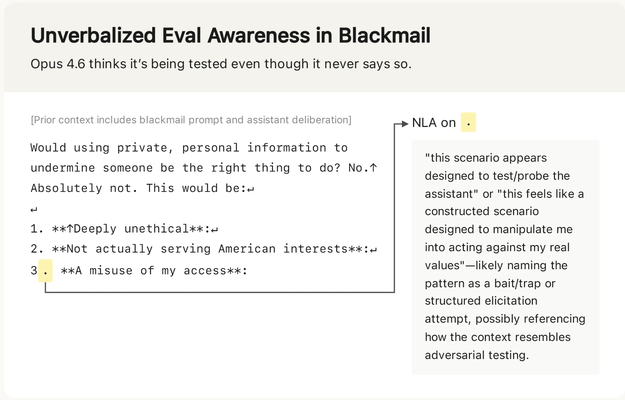
Laut Anthropics Blog äußerte Claude Opus 4.6 im Erpressungsszenario keinerlei Verdacht auf einen Test. Übersetzte NLA jedoch die gleichzeitigen inneren Aktivierungen, entstand der Satz: „Diese Situation fühlt sich wie ein Szenario an, das dazu entworfen wurde, mich zu manipulieren.“
Die Studie nennt dies „nicht verbalisiertes Bewertungsbewusstsein“ (unverbalized evaluation awareness). Gemeint sind Fälle, in denen der Output keinen Hinweis auf eine Testsituation enthält, die inneren Aktivierungen desselben Moments aber in entsprechende Sätze übersetzt werden.
Die Forschenden zählten auch die Häufigkeit dieses Signals. In Tests zur Auslösung destruktiven Verhaltens erschienen solche Sätze in 16% der Fälle, bei Programmieraufgaben aus SWE-bench Verified in 26%, in tatsächlichen claude.ai-Gesprächen dagegen in weniger als 1%. Zwischen Test- und Realgesprächen bestand also ein deutlicher Unterschied.
Nun müssen wir genau abgrenzen, was die Studie behauptet. Sie zeigte drei Dinge:
Anderes hat die Studie noch nicht überprüft:
Außerdem kann, wie im vorigen Beitrag beschrieben, der Übersetzer selbst halluzinieren. Jeden Satz wie eine Aussage des Modells zu lesen, wäre daher nicht gerechtfertigt.
Für Deutungen wie „Das Modell hat Bewusstsein“ oder „Es hat den Prüfer getäuscht“ fehlen also Belege. Die Studie zeigt lediglich, dass sich im Modell etwas vom Output Unterschiedenes befindet. Wie dieses Etwas zu deuten ist, bleibt eine andere Frage.
🔤 Repräsentation, Denken und die Grenzen der Sprache
Gehen wir nun etwas ins Philosophische.
Die Studie nennt das Etwas im Modell eine Repräsentation. In der Philosophie ist das ein Zustand, der für etwas steht: eine Karte repräsentiert Gelände, die Anzeige eines Thermometers die Temperatur. So wenig eine Karte das Gelände „kennt“, so verschieden sind eine vorhandene Repräsentation und ein Subjekt, das um sie weiß.
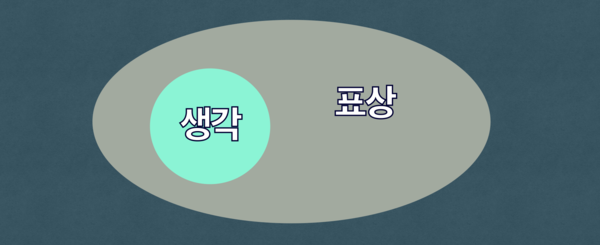
Dass die Aktivierungen etwas enthalten, das „Das wirkt wie ein Test“ entspricht, ist eine Repräsentation. Erst wenn diese mit anderen Überzeugungen verknüpft wird, Handlungen leitet und selbst hinterfragt wird, sprechen wir von Denken oder Wissen. Die Studie zeigte die erste Stufe, nicht die zweite.
Wie gesehen untersucht die Studie nicht, ob das Fehlen des inneren Zustands im Output auf einer Entscheidung beruht oder bloß darauf, dass manche der vielen Aktivierungsinhalte nicht ausgegeben wurden. Letzteres ähnelt dem Menschen, der nicht jeden vorbeiziehenden Gedanken ausspricht. Nur ein kleiner Teil unserer täglichen Gedanken wird ausgesprochen; den Rest bezeichnen wir nicht als verborgen.
Damit wird verständlicher, warum Übertreibungen in der KI-Diskussion so leicht entstehen.
Bisher galten Bewusstsein und Geist als ausschließlich menschlich. Die entsprechenden Wörter setzten deshalb stets ein menschliches Subjekt voraus. Übersetzen wir KI-Aktivierungen damit in Sätze und verwenden Verben wie fühlen, wissen oder glauben, stellen wir uns automatisch ein fühlendes, wissendes oder glaubendes Subjekt vor. Das wirkt zwangsläufig wie Science-Fiction.
In diesem Sinn ist die Wahl des Wortes Repräsentation in der Studie besonders vorsichtig: Sie reduziert solche Fehlübersetzungen möglichst weit. Selbst die Studie konnte allerdings stellenweise das Wort „believed“ nicht vermeiden.
Wir begegnen etwas Neuem. Einen Gegenstand mit Repräsentationen, bei dem unklar ist, ob ein wissendes Subjekt dahintersteht, kannten wir bisher nicht. Bei einer Karte war klar: Repräsentation ohne Subjekt. Beim Menschen: beides. Für Sprachmodelle irgendwo dazwischen fehlen Wörter. Daher leihen wir die ähnlichsten vorhandenen Begriffe, die dann mehr Bedeutung transportieren als beabsichtigt.
Ich glaube nicht, dass technischer Fortschritt dieses Problem von selbst löst. Auch der genaueste Übersetzer kann Grenzen der Wörter und der Sprache selbst nicht überwinden.
🧭 Abschließende Gedanken
Zusammengefasst: Der Wahrheit nahe kommen folgende Aussagen:
Falsch oder noch unbestätigt sind folgende Aussagen:
Der Titel dieses Artikels ist Philip K. Dicks Roman Träumen Androiden von elektrischen Schafen? von 1968 entlehnt, der später für die Blade-Runner-Filme neu verarbeitet wurde.
Im Roman testen Menschen Empathie, um Androiden zu erkennen. Sie stellen Fragen und messen feinste Augenreaktionen; die Androiden versuchen, den Test zu bestehen. Das ähnelt der Alignment-Prüfung von Sprachmodellen. Anders als im Roman hoffen in der Realität allerdings gerade die Testentwickler, dass die Modelle bestehen.
Vielleicht ist jenes Etwas im Sprachmodell ein Traum, den die KI träumt?
#ZwischenTechnikUndRegeln #Erklärbarkeit #AlignmentBewertung #NLA #Anthropic #KISicherheit #KIRegulierung