
La Ley Marco de IA examinada anteriormente regulaba las marcas de los contenidos generados, es decir, las salidas. Pero existe otro frente de litigios en el extremo contrario: las entradas.
Es sabido que entrenar IA requiere cantidades enormes de datos. Lo que aún no está resuelto es a quién y cómo remunerarlos, o incluso si debe pagarse.
Cuando surge una cuestión jurídica nueva, suele esperarse a ver quién actúa primero. En noviembre de 2025, una sentencia alemana atrajo todas las miradas. Dos semanas antes de este artículo, el 31 de julio, llegó otra en el mismo sentido. Examinemos ambas.
🇩🇪 Primera sentencia: reproducción más allá del entrenamiento
¿Sabe qué responden hoy agentes como ChatGPT al pedirles la letra de una canción concreta?
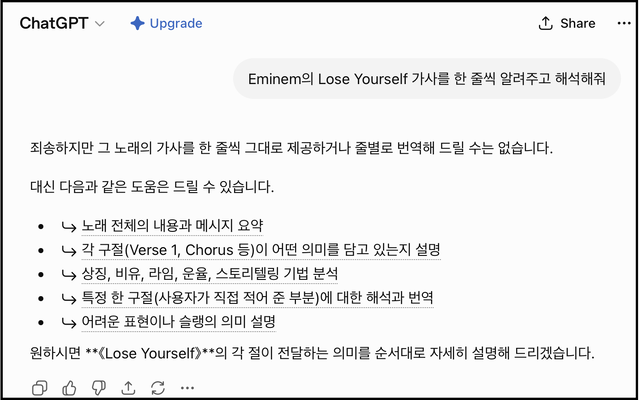
Como se muestra arriba, ChatGPT no ofrece directamente la letra. La primera sentencia se relaciona con este fenómeno.
En la demanda de la entidad musical alemana GEMA contra OpenAI, el Tribunal Regional de Múnich I consideró que entrenar sin permiso con letras y reproducirlas mediante ChatGPT infringía el derecho de autor alemán [1]. Se trataron nueve canciones famosas, entre ellas Atemlos, Männer y Über den Wolken.
[1] GEMA v. OpenAI: Tribunal Regional de Múnich I, Sala Civil 42, 11 de noviembre de 2025, expediente 42 O 14139/24. GEMA cuestionó el entrenamiento y la reproducción de letras sin autorización por GPT-4 y GPT-4o.
OpenAI alegó que el modelo no almacena datos concretos y solo aprende correlaciones estadísticas. El tribunal lo rechazó porque instrucciones tan simples como pedir el estribillo reproducían casi exactamente las letras. Lo comparó con la compresión MP3 con pérdida: aunque no se conserve todo el original, reproducirlo reconociblemente desde información estadística es copiar. Hay tres puntos centrales.
Aclaremos la excepción TDM. Text and Data Mining analiza automáticamente obras para extraer patrones, tendencias y correlaciones. Como requiere copias, la Directiva europea 2019/790 de derechos de autor en el mercado único digital introdujo una excepción, transpuesta en Alemania mediante el artículo 44b [2].
Pero el artículo 44b exige eliminar las copias cuando dejen de ser necesarias para la minería. La excepción cubre el tiempo del análisis, no conservarlas después. Los modelos seguían prestando servicios con esos contenidos en sus parámetros tras entrenar; ahí el tribunal negó la excepción.
Finalmente ordenó a OpenAI cesar la infracción, revelar el alcance del uso y los ingresos obtenidos e indemnizar los daños, con una multa coercitiva de 250 000 euros por incumplimiento.
🇩🇪 Segunda sentencia: de la letra a la melodía
El pasado 31 de julio, la misma sala fue más allá, esta vez frente al generador musical Suno [2].
[2] GEMA v. Suno: Tribunal Regional de Múnich I, Sala Civil 42, 31 de julio de 2026, expediente 42 O 763/25. GEMA demandó en enero de 2025. Se estimaron mayoritariamente las pretensiones de cesación, información e indemnización. Abarcó seis obras: Atemlos durch die Nacht, Rasputin, Big in Japan, Forever Young, el estribillo de Mambo No. 5 y Daddy Cool. No es sentencia firme.
GEMA probó coincidencias sustanciales de melodía, armonía y ritmo con los originales, y el tribunal las aceptó. Es prácticamente la primera sentencia publicada que aborda directamente audio generado por IA. Antes se trató de letras, texto; ahora, de la música misma.
La defensa fue interesante: Suno ya reconocía haber entrenado con el repertorio GEMA. Solo discutía que debiera pagar. Tampoco se discutía la descarga de datos de YouTube mediante stream ripping.
El tribunal rechazó claramente esa posición y de nuevo la excepción TDM: Suno no había analizado simplemente las obras, sino que las conservaba permanentemente en el modelo como función del servicio. Mantuvo la interpretación restrictiva adoptada ocho meses antes frente a OpenAI.
⚖️ ¿Y la jurisdicción?
Otra cuestión importante es dónde se entrenó el modelo.
Suno es estadounidense y entrenó allí. Hasta entonces era una defensa sólida: prestar servicios en Europa no permitiría aplicar derecho europeo a un entrenamiento realizado fuera.
Ese argumento funcionó en Getty Images v. Stability AI ante el Tribunal Superior británico el pasado 4 de noviembre [3]. Getty reconoció que el entrenamiento ocurrió fuera del Reino Unido y tuvo que retirar durante el juicio su pretensión principal de derechos de autor. El resto también se desestimó, salvo una infracción de marcas muy limitada por las marcas de agua.
[3] Getty Images v. Stability AI: Tribunal Superior de Inglaterra y Gales, 4 de noviembre de 2025, [2025] EWHC 2863 (Ch), jueza Joanna Smith. Aunque se destacó como primera sentencia europea de derechos de autor sobre IA, no respondió a si entrenar constituye infracción, entre otros motivos por la jurisdicción.
La sentencia de Múnich impide esa tranquilidad. Al margen del entrenamiento estadounidense, ofrecer el modelo y sus resultados en Alemania vulneró el derecho alemán. Es la primera sentencia europea que admite responsabilidad alemana por un entrenamiento íntegramente ajeno a la UE. En el segundo caso, incluso ordenó a Suno cesar la reproducción de obras en territorio estadounidense para entrenar su modelo musical.
Su alcance es por ello enorme: entrenar en unos Estados Unidos menos regulados y ofrecer solo el servicio en Europa ya no basta, al menos en Alemania.
No desaparecen todas las lagunas. La competencia sobre el entrenamiento estadounidense se basó en el fuero especial que la ley VGG concede a entidades de gestión como GEMA. Sigue pendiente si un titular individual obtendría la misma respuesta, cómo determinar el lugar de infracción y, sobre todo, si la sentencia alemana puede reconocerse y ejecutarse realmente en Estados Unidos.
🧭 Para terminar
En rigor, estas sentencias no cobran ni sancionan el entrenamiento en sí: examinan sobre todo si, terminado el análisis, el original permanece reproducible en los parámetros del modelo.
A mi juicio, como calcular una remuneración o un perjuicio adecuado por entrenamiento resulta extremadamente difícil, el debate seguirá probablemente centrado en criterios más claros y verificables: las salidas y la reproducción.
Sobre todo, ¿qué es exactamente aprender para una IA? ¿Leer obras o el conjunto de pesos resultante? ¿Cuánto se parece al aprendizaje humano y cuánto difiere? ¿Con qué concepto jurídico existente debemos relacionarlo?
Los dos asuntos no han terminado. OpenAI apeló por considerar que se entendió mal el funcionamiento de la IA, y la sentencia Suno tampoco es firme. Pueden llegar a tribunales superiores o al Tribunal de Justicia de la UE. Sobre el resultado futuro, probablemente todos…
La próxima entrega examinará los grandes casos estadounidenses de entrenamiento, en el centro de la industria de IA.
#EntreTecnologíaYNormas #DerechosAutorIA #GEMA #OpenAI #TDM #IAGenerativa