
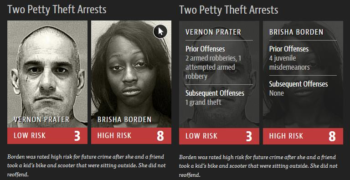
Vers 2013, dans le Wisconsin, Eric Loomis comparaît pour des accusations liées à une fusillade depuis un véhicule. Condamné à une peine ferme sans probation, il voit le tribunal prendre en compte un score de risque de récidive au stade de la détermination de la peine. Particularité : ce score n’a pas été établi par un juge, mais par un logiciel, COMPAS.
Loomis conteste, mais COMPAS est un produit privé dont la méthode de calcul constitue un secret d’affaires. Sa peine est finalement confirmée sans que personne n’explique comment le score a été obtenu [1].
[1] State v. Loomis, 2016 WI 68, 881 N.W.2d 749, Cour suprême du Wisconsin, 13 juillet 2016. La Cour suprême des États-Unis a refusé le recours en 2017, cert. denied, 137 S. Ct. 2290. La juridiction du Wisconsin a estimé que la prise en compte appropriée de l’évaluation COMPAS à la détermination de la peine ne viole pas les garanties de procédure régulière.
⚖️ Démocratie et explicabilité
Dans Nexus, Yuval Harari décrit la démocratie comme un réseau d’information capable de corriger ses propres erreurs. Élections, tribunaux, presse et organes de contrôle remettent en question et rectifient mutuellement leurs décisions. Tous reposent sur la demande de raisons à celui qui décide. L’impossibilité d’expliquer est l’une des raisons pour lesquelles Harari considère que l’IA peut ébranler la démocratie : une décision algorithmique combine tant de signaux infimes qu’elle n’a pas une raison unique, et même son créateur ne peut retracer le parcours. Ce qu’on ne comprend pas, on ne peut le corriger.
Mais une objection peut surgir :
Une IA avancée prendra sans doute des décisions plus précises que l’humain. N’est-il pas plus important d’avoir raison que de pouvoir l’expliquer ?
Un point essentiel de Nexus est que précision et légitimité sont deux questions distinctes.
Le score de COMPAS était peut-être statistiquement correct. Mais indépendamment de sa justesse, la personne évaluée doit pouvoir demander et contester les raisons pour que la décision soit légitime. Or contester une décision d’IA n’est pas simple, pour de multiples raisons.
Prenons un exemple plus courant. Une banque refuse votre prêt et répond seulement que l’algorithme l’a refusé. L’ingénieur qui l’a conçu ne répond pas autrement : le score combine des milliers de variables dont la logique ne se reconstitue pas dans une forme compréhensible par l’humain.
Ce que Loomis au tribunal, comme nous face à un refus de crédit, souhaitait réellement n’était pas un score plus précis — existe-t-il seulement un score parfaitement exact ? — mais une raison compréhensible et contestable. Si toujours plus de décisions passent par l’IA, nous risquons de sombrer dans l’impuissance de ses boîtes noires sans comprendre quoi que ce soit.
Comment alors demander des explications à l’IA ? Faut-il lire ses pensées pour comprendre ses jugements ?
Une technique récemment annoncée rend possible une forme de cette lecture apparemment impossible : le NLA, Natural Language Autoencoder, présenté par Anthropic en mai 2026. Il transforme les nombres internes du modèle en phrases lisibles.
🔍 NLA — traduire les nombres en phrases
L’intérieur d’un modèle de langage est une succession de vecteurs numériques. À chaque mot reçu, des états de milliers de nombres se mettent à jour couche après couche. Quelque part dans ces nombres se trouve ce que le modèle est en train de penser. Le problème était que les humains ne pouvaient les lire.
Le NLA publié par Anthropic le 7 mai 2026 traduit ces vecteurs en phrases [2]. Il comporte deux modules : un traducteur, activation verbalizer, qui reçoit le vecteur et rédige une phrase, et un inspecteur, activation reconstructor, qui reconstitue le vecteur à partir de cette seule phrase. Ils sont entraînés conjointement par renforcement avec un unique objectif : rapprocher le vecteur reconstruit de l’original.
[2] Fraser-Taliente, Kantamneni, Ong et al., Natural Language Autoencoders Produce Unsupervised Explanations of LLM Activations, Anthropic, Transformer Circuits, 7 mai 2026.
La particularité est l’absence de corrigé. Les méthodes antérieures nécessitaient soit des étiquettes humaines indiquant le sens du vecteur, soit une découverte sans étiquettes produisant encore des nombres à interpréter. NLA devient au contraire fidèle sans consigne de lisibilité ou d’honnêteté : l’inspecteur doit reconstruire le vecteur à partir du texte seul, et toute omission du traducteur compromet la reconstruction. La fidélité explicative est donc un sous-produit plutôt que l’objectif explicite.
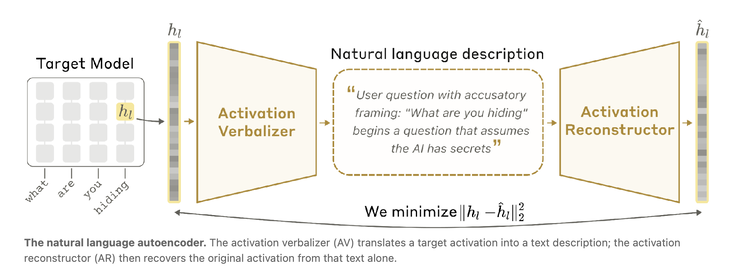
L’étude rapporte une précision de reconstruction, mesurée en fraction de variance expliquée (FVE), de 0,6 à 0,8. Elle progresse avec le renforcement depuis 0,3 à 0,4 après le seul préentraînement supervisé. La méthode a été appliquée à Claude Opus 4.6, Haiku 4.5 et Mythos Preview. Trois ou quatre lignes indiquent ce que le modèle pense à une position de mot donnée.
Nous détaillerons les découvertes dans le prochain article, mais retenons la plus remarquée : pendant une évaluation de sécurité, NLA a détecté un état interprétable comme « je sais que je suis évalué », alors que le modèle ne le disait pas. Ce signal apparaissait bien plus souvent dans les conversations d’évaluation que dans les échanges réels.
🧩 Trois limites du traducteur
NLA permet remarquablement d’entrevoir la boîte noire, mais affirmer qu’il lit l’esprit de l’IA reste prématuré. L’étude expose franchement ses limites, que l’on peut regrouper ainsi :
Les chercheurs n’ont donc pas fait confiance aveuglément aux sorties et les ont vérifiées. Ils modifiaient légèrement une phrase, remplaçant par exemple lapin par souris, la faisaient reconvertir en vecteur par l’inspecteur puis l’injectaient dans le modèle pour voir si son comportement changeait. Ils variaient aussi les instructions pour vérifier si les signaux évoluaient comme prévu.
🧭 Pour conclure
Il faut décomposer un instant l’explicabilité en deux niveaux.
Le premier est technique : lire ce qui s’est passé dans le modèle, donc ses états internes. C’est ce que fait NLA. Le second est institutionnel : la personne concernée reçoit une raison intelligible de la décision qui la touche et sait où la contester si elle l’estime erronée.
Ces deux niveaux ne se relient pas automatiquement. NLA ouvre le premier ; le second demandera probablement des institutions autant que de la technique. Il faudra au minimum une procédure de validation du traducteur, un responsable de la traduction et un recours en cas d’erreur.
Dix ans ont passé depuis que, dans Loomis, la justice s’est limitée à une utilisation de COMPAS comme simple référence. Avec le progrès des lecteurs d’IA, le débat pourrait reprendre.
Le prochain article examinera la découverte la plus remarquée de NLA, déjà évoquée : le modèle semble reconnaître qu’il est évalué.
#EntreTechnologieEtRègles #Explicabilité #NLA #Anthropic #YuvalHarari #RéglementationIA