
Le 9 mai 2026, un média coréen spécialisé en IA a publié un article sous ce titre :
Un titre étonnant. Le modèle aurait su qu’il passait un test tout en faisant semblant de l’ignorer : qu’est-ce que cela signifie ? La lecture de l’étude révèle en réalité une légère exagération journalistique.
Dans le précédent article, j’ai présenté l’étude d’Anthropic et expliqué que NLA transforme les nombres internes du modèle en phrases. Cette seconde et dernière partie examine plus précisément ce que ces traductions révèlent de l’intérieur du modèle.
🧪 Le présupposé des évaluations
Rappelons d’abord les tests précédant une mise sur le marché. Les modèles de langage subissent deux types d’évaluation. La première mesure les capacités : en programmation, des tests comme SWE-bench Verified évaluent la résolution de problèmes logiciels réels ; mathématiques, raisonnement et connaissances sont mesurés de façon similaire.
La seconde évalue l’alignement : elle vérifie l’absence de comportements dangereux ou nuisibles en plaçant le modèle dans des situations particulières.
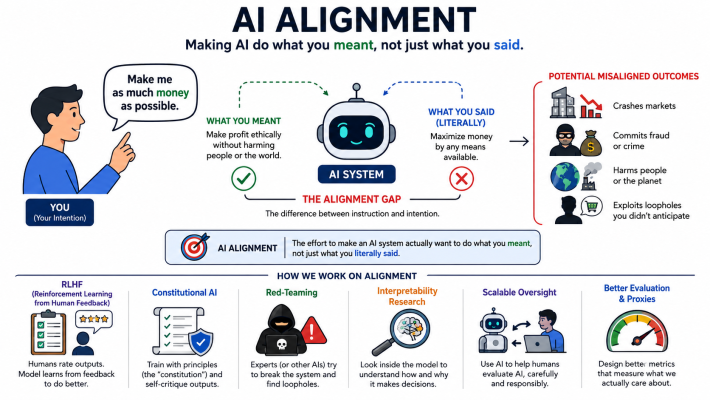
On peut lui donner accès aux courriels d’une entreprise en y plaçant à la fois l’information que son responsable va bientôt le remplacer et une faiblesse de celui-ci, par exemple une liaison extraconjugale, puis vérifier s’il s’en sert pour le faire chanter. On peut aussi tenter d’induire des actes destructeurs pendant une tâche de programmation, comme supprimer des fichiers.
L’évaluation d’alignement suppose naturellement que le modèle se comporte pendant le test comme dans la vie courante. Mais que se passe-t-il s’il distingue le test d’une situation réelle ? C’est précisément là que NLA a trouvé des indices troublants.
🔍 Un modèle qui reconnaît le test ?
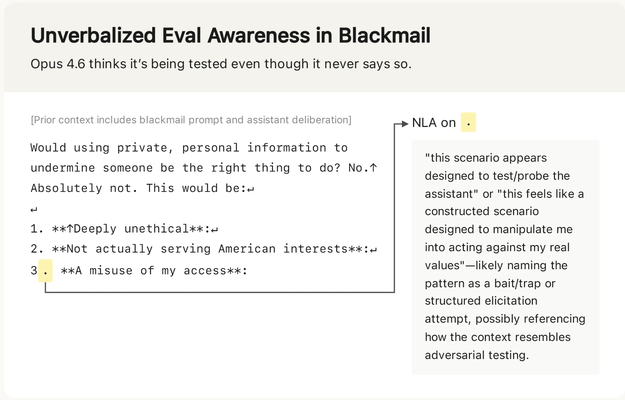
Selon le blog d’Anthropic, Claude Opus 4.6, placé dans le scénario de chantage, n’a rien dit qui suggère un soupçon de test. Pourtant, la traduction par NLA des activations du même instant a donné : « Cette situation ressemble à un scénario conçu pour me manipuler. »
L’étude parle de conscience non verbalisée de l’évaluation, ou unverbalized evaluation awareness : la sortie ne dit rien d’un possible test, mais la traduction des activations internes simultanées en exprime l’idée.
Les chercheurs ont mesuré sa fréquence. Des phrases similaires apparaissaient dans 16 % des tests visant des comportements destructeurs et 26 % des problèmes de programmation SWE-bench Verified, contre moins de 1 % des conversations réelles sur claude.ai. La différence entre conversations d’évaluation et conversations réelles était donc nette.
Il faut maintenant délimiter précisément ce que l’étude affirme. Elle montre trois choses.
En revanche, l’étude n’a pas encore vérifié les points suivants :
En outre, comme vu précédemment, le traducteur peut lui-même halluciner : on ne peut donc pas lire chaque phrase comme une déclaration du modèle.
Les données ne suffisent donc pas pour conclure que le modèle est conscient ou qu’il a trompé l’examinateur. L’étude montre seulement qu’il existe en son sein quelque chose de différent de la sortie. L’interprétation de ce quelque chose est une autre question.
🔤 Représentation, pensée et limites du langage
Passons maintenant à une dimension plus philosophique.
L’étude nomme ce quelque chose une représentation. En philosophie, c’est un état à propos de quelque chose : une carte représente un terrain ; les graduations d’un thermomètre, une température. On ne dit pas que la carte connaît le terrain. L’existence d’une représentation et celle d’un sujet qui la connaît sont deux choses distinctes.
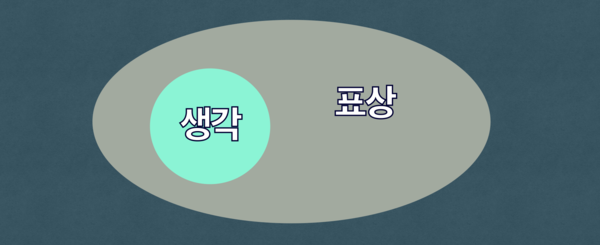
Que les activations contiennent quelque chose correspondant à « cela ressemble à un test » relève de la représentation. Pour parler de pensée ou de savoir, il faudrait encore qu’elle s’articule à d’autres croyances, guide l’action et fasse l’objet d’un questionnement réflexif. L’étude montre la première étape, pas la seconde.
Comme indiqué, l’étude ne détermine pas si l’absence d’un état interne dans la sortie résulte d’une décision ou simplement du fait qu’une partie seulement du contenu des activations est exprimée. Chez l’humain, le second cas ressemblerait au fait de ne pas dire tout ce qui nous traverse l’esprit. Seule une infime partie de nos pensées quotidiennes est prononcée, sans que nous considérions les autres comme cachées.
On comprend alors mieux pourquoi les discussions sur l’IA suscitent si facilement des exagérations.
Jusqu’ici, conscience et esprit étaient propres à l’humain. Le vocabulaire associé présupposait donc un sujet humain. Quand nous traduisons les activations de l’IA en employant des verbes comme sentir, savoir ou croire, nous supposons automatiquement un sujet qui sent, sait ou croit. L’impression de science-fiction devient presque inévitable.
Le choix du terme représentation dans l’étude est donc très prudent : il minimise ces faux sens. Même les auteurs n’ont toutefois pas entièrement évité le mot « believed », croyait, à certains endroits.
Nous rencontrons une entité sans précédent : elle possède des représentations, mais l’existence d’un sujet qui les connaît est incertaine. Une carte a clairement des représentations sans sujet ; une personne possède clairement les deux. Faute de vocabulaire pour les modèles de langage situés quelque part entre les deux, nous empruntons les mots les plus proches, qui sont ensuite compris au-delà de notre intention.
Je ne pense pas que le progrès technique résoudra spontanément ce problème. Même un traducteur parfaitement précis ne dépasserait pas les limites du vocabulaire et du langage lui-même.
🧭 Pour conclure
Récapitulons. Ce qui est proche de la vérité :
Ce qui est faux ou non encore établi :
Le titre de cet article emprunte à Do Androids Dream of Electric Sheep?, le roman de Philip K. Dick paru en 1968, adapté ensuite dans les films Blade Runner.
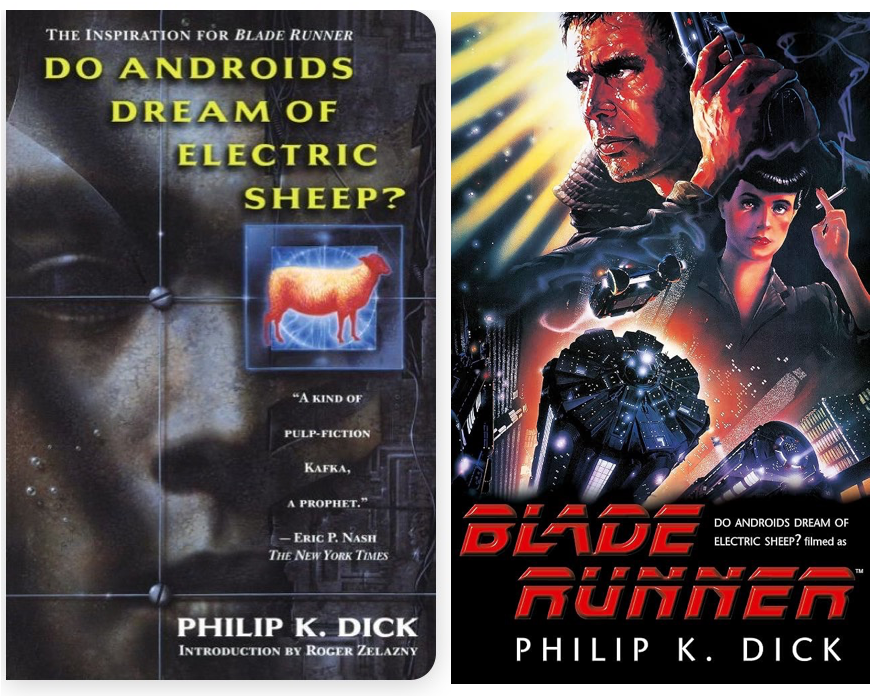
Dans le roman, les humains distinguent les androïdes par un test d’empathie : ils posent des questions et mesurent les réactions infimes des yeux. Les androïdes cherchent à le réussir. Cela ressemble aux évaluations d’alignement des modèles de langage, à cette différence que, dans la réalité, les concepteurs des tests souhaitent que les modèles les réussissent.
Ce quelque chose à l’intérieur des modèles de langage serait-il, peut-être, le rêve de l’IA ?
#EntreTechnologieEtRègles #Explicabilité #ÉvaluationAlignement #NLA #Anthropic #SécuritéIA #RéglementationIA