
2013년경 미국 위스콘신주. 에릭 루미스라는 남성이 차량 총격 사건과 관련된 혐의로 기소되어 법정에 섰습니다. 루미스에게는 보호관찰 없는 실형이 선고되었는데, 양형 단계에서 법원은 '재범 위험 점수'를 참고했습니다. 특이했던 것은 이 재범 위험 점수가 판사가 아닌, COMPAS라는 소프트웨어가 매긴 것이었다는 점입니다.
루미스 측은 이 판단에 이의를 제기했지만, COMPAS는 민간 기업의 제품이었고 계산 방식은 영업 비밀이었습니다. 결국 그 점수가 어떻게 나왔는지는 아무도 설명해 주지 않은 채, 루미스의 형량은 확정되었습니다[1].
[1] State v. Loomis, 2016 WI 68, 881 N.W.2d 749 (Wis. 2016. 7. 13. 선고). 미국 연방대법원은 2017년 상고를 기각(cert. denied, 137 S. Ct. 2290). 위스콘신주 대법원은 양형 시 COMPAS 위험평가 참고가 적절히 이루어진다면 적법절차를 위반하지 않는다고 보았다.
⚖️ 민주주의와 설명가능성
유발 하라리는 『넥서스』에서 민주주의를 스스로 오류를 고치는 정보망으로 설명합니다. 선거와 법원, 언론, 감사 기관이 서로의 결정을 되묻고 바로잡는 구조인데, 이 장치들은 결국 '결정한 자에게 이유를 묻는 행위'를 기초로 합니다. 하라리가 AI를 민주주의를 근본적으로 흔들 수 있는 것으로 보는 이유 중 하나가 바로 '설명할 수 없음'입니다. 알고리즘의 결정은 수많은 미세한 신호를 조합한 결과라 단 하나의 이유라는 것이 없고, 만든 사람조차 그 경로를 되짚지 못합니다. 이해할 수 없는 것은 고칠 수도 없죠.
하지만 이런 의문이 들 수도 있습니다:
발전한 AI는 인간보다 더 정확한 결정을 할 것 같은데, 옳은 결정을 하는 것이 설명 가능 여부보다 더 중요한 것이 아닐까?
『넥서스』에서 하라리가 짚어낸 중요한 지점은, 정확성과 정당성이 다른 문제라는 것입니다.
COMPAS의 점수가 통계적으로 맞았을 수도 있습니다. 그러나 맞았는지와 별개로, 그 점수를 받은 사람이 이유를 묻고 다툴 수 있어야 결정에 정당성이 생깁니다. 하지만 AI가 내린 결정을 다투는 것은 여러 이유에서 쉽지가 않죠.
좀 더 보편적인 예시를 들어보겠습니다. 은행이 당신의 대출 신청을 거절했다고 해봅시다. 이유를 물으면 은행은 "알고리즘이 안 된다고 했다"고만 답합니다. 그 알고리즘을 만든 엔지니어에게 물어도 답은 크게 다르지 않습니다. 수천 개의 변수를 조합해 나온 점수이고, 그 조합의 논리는 인간이 이해할 수 있는 형태로 재구성되지 않기 때문입니다.
법정에서의 루미스도, 신용대출을 거부당한 우리도 진짜 원한 것은 '더 정확한 점수'가 아니었습니다(애초에 정확한 점수라는 것이 존재할까요?). 왜 그런 결과가 나왔는지, '납득하고 반박할 수 있는 이유'였죠. 앞으로 점점 더 많은 결정이 AI를 통해 이루어진다면, 우리는 아무것도 납득하지 못한 채 AI의 블랙박스가 만드는 무기력의 구렁텅이에 빠져버릴 것입니다.
그렇다면 어떻게 AI에게 설명을 요구할 수 있을까요? AI에게 왜 그런 판단을 했는지, 그 속마음을 읽어내기라도 해야 할까요?
아무래도 불가능해 보였던 이 'AI 독심술'을 가능하게 만드는 기술이 최근 발표되었습니다. 2026년 5월 앤트로픽이 공개한 NLA(Natural Language Autoencoder)입니다. 모델 내부의 숫자를 사람이 읽는 문장으로 옮기는 장치입니다.
🔍 NLA — 숫자를 문장으로 옮기다
언어모델의 내부는 숫자 벡터의 연속입니다. 단어 하나가 들어올 때마다 수천 개의 숫자로 된 상태가 층마다 갱신되고, 그 숫자 어딘가에 모델이 지금 '무엇을 생각하고 있는지'가 담겨 있습니다. 문제는 그 숫자를 사람이 읽을 수 없다는 점이었습니다.
앤트로픽 연구진이 2026년 5월 7일 공개한 NLA는 이 벡터를 문장으로 옮기는 번역기입니다[2]. NLA는 두 모듈로 구성되어 있습니다. 하나는 벡터를 받아 문장을 쓰는 번역가(activation verbalizer), 다른 하나는 그 문장만 보고 원래 벡터를 되살리는 검사관(activation reconstructor)입니다. 둘을 강화학습으로 함께 훈련하는데, 목표는 단 하나, 검사관이 되살린 벡터가 원본과 얼마나 가까운가입니다.
[2] Fraser-Taliente, Kantamneni, Ong 외, "Natural Language Autoencoders Produce Unsupervised Explanations of LLM Activations", Anthropic, Transformer Circuits, 2026년 5월 7일.
특징은 정답지가 없다는 점입니다. 기존의 해석 방법은 사람이 "이 벡터는 이런 뜻"이라고 라벨을 달아 가르치거나, 라벨 없이 찾아내되 결과가 숫자 덩어리로 나와 다시 사람이 읽어야 했습니다. 반면, NLA는 번역가에게 "읽기 쉽게 써라"거나 "정직하게 써라"는 지시가 전혀 없는데도 번역이 충실해집니다. 검사관이 문장만 보고 벡터를 되살려야 하니, 번역가가 벡터에 담긴 정보를 빠뜨리면 복원이 실패하기 때문입니다. 설명의 충실성이 목표가 아니라 부산물로 설계된 셈입니다.
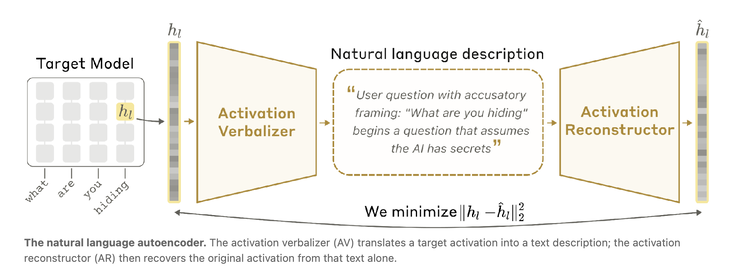
논문에 따르면 이렇게 훈련한 NLA의 복원 정확도(설명된 분산 비율, FVE)는 0.6에서 0.8 사이입니다. 강화학습 전에 감독 학습으로 예열만 했을 때의 0.3~0.4에서 출발해 학습이 진행될수록 올라갔습니다. Claude Opus 4.6과 Haiku 4.5, Mythos Preview에도 적용했습니다. 결과물은 특정 단어 위치에서 모델이 무엇을 생각하고 있는지 서너 줄의 문장으로 나옵니다.
무엇을 읽어냈는지는 다음 편에서 자세히 다루겠지만 가장 주목을 받았던 내용을 한 줄만 적어 두겠습니다. 안전 평가 중인 모델의 내부에서, 모델이 "(겉으로는 말하지 않았지만) 지금 평가받는 중임을 알고 있다"는 것으로 해석되는 상태를 NLA가 잡아냈습니다. 실제 사용자 대화보다 평가용 대화에서 이 신호가 훨씬 자주 나타났고요.
🧩 번역기의 세 가지 한계
NLA는 AI 블랙박스의 비밀을 엿보게 해줄 훌륭한 도구이기는 하지만, 아직 'AI의 마음을 읽을 수 있다'고 하기에는 비약이 있습니다. 논문은 자신의 한계를 꽤 솔직하게 적어 두었는데, 세 갈래로 정리하면 이렇습니다:
그래서 연구진도 NLA의 출력을 그대로 믿지 않아, 교차 검증을 수행했다고 합니다. 설명 문장을 살짝 고쳐(예컨대 '토끼'를 '쥐'로) 검사관에게 다시 벡터로 만들게 한 뒤 모델에 주입해 행동이 바뀌는지 보거나, 프롬프트를 바꿔 가며 신호가 예상대로 움직이는지 확인하는 등의 방식입니다.
🧭 마무리
잠시 '설명가능성'이라는 말을 한 번 분해해 볼 필요가 있습니다. 설명가능성에는 두 층위가 있습니다.
하나는 기술적 설명입니다. 모델 안에서 무슨 일이 있었는지를 읽어내는 일, 즉 내부 상태의 판독을 의미하고, NLA가 이 부분을 해내고 있습니다. 다른 하나는 제도적 설명입니다. 왜 나에게 이 결정이 내려졌는지를 당사자가 납득할 수 있는 이유로 듣고, 틀렸다고 생각하면 어디에 이의를 제기하는지가 정해져 있는 상태라고 볼 수 있습니다.
이 둘은 자동으로 이어지지 않습니다. NLA는 첫 번째 설명가능성을 열어주었지만, 두 번째는 아마 기술만이 아니라 제도가 함께 만들어 가야 할 영역일 것으로 보입니다. 적어도 세 가지 - 번역기의 검증 절차, 번역 결과에 책임지는 주체, 오역이 있었을 때의 구제 방법 등이 마련되어야겠죠.
루미스 사건에서 법원이 "참고만 하라"는 선으로 물러선 지 10년이 지났는데, AI 판독기가 앞으로 더욱 발전한다면, 논의는 다시 시작될지도 모릅니다.
다음 편에서는 NLA가 읽어낸 내용 중 가장 주목받았던 부분을 살펴보겠습니다. 앞서 잠깐 소개했듯이, '모델이 자신이 평가받고 있음을 알고 있다'는 부분입니다.
#기술과제도사이 #설명가능성 #NLA #앤트로픽 #유발하라리 #AI규제