
前回はドイツの裁判例を見ました。ではAI企業の本拠地、米国はどうでしょうか。
結論からいえば、米国の裁判所はドイツと判断が異なり、AI学習はフェアユースに近いという立場です。ただし紛争の多くが判決ではなく巨額の和解で収まる点が注目されます。
今回は米国の主要な3事件を見ていきます。
⚖️ フェアユースという天秤
まず米国著作権法のフェアユース(Fair Use)を確認します。他人の作品を許可なく使える例外で、裁判所は次の4要素で判断します。
AI学習では事実上、第一と第四が争点です。AIが本を読み言語のパターンを学ぶのは原作の代替なのか、別物へ変えることなのか(変容性)、その結果が原作の市場を侵食するか(市場影響)を判断します。
作品の存在ではなく利用の性質と結果を問うため、前回のドイツの「作品がAIモデル内に残るか」とは出発点から異なります。
📕 第一 — Thomson Reuters v. Ross Intelligence[1]:フェアユースを退けた初の事例
発端はライセンス拒絶でした。法律AIスタートアップRoss Intelligenceは判例検索サービスのためWestlawのデータ利用を望みましたが、Thomson Reutersは競合化を懸念して拒否しました。
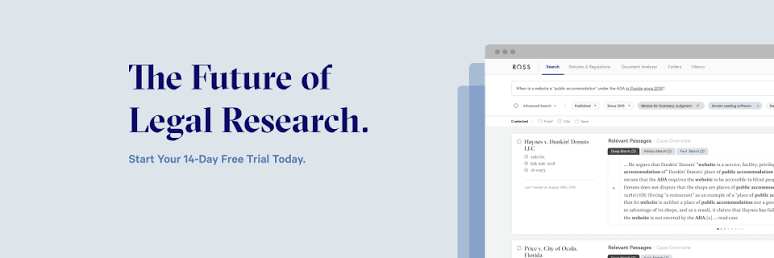
そこでRossは迂回路を選び、外部企業に「法律メモ」を作らせました。しかし実質的にはWestlawの判例要約、ヘッドノートに基づくものでした。
裁判所はヘッドノートを単なる判決抜粋ではなく編集者の判断を含む創作物と認め、学習利用にフェアユースを認めませんでした。
最大の争点は第四要素の市場影響です。Rossが作るのはWestlawと直接競争する代替物であり、Thomson Reutersが「AI学習データをライセンスできた潜在市場」まで侵害されたとしました。後者は「学習データのライセンス市場」の存在を認めた点で特に重要です。
ただし大きな留保があります。RossのAIは生成型ではなく検索型で、裁判所も生成AIへそのまま適用する判断ではないと明示しました。
[1] Thomson Reuters v. Ross Intelligence — デラウェア連邦地裁、2025年2月判決。Rossの中間上訴を第3巡回区控訴裁判所が2025年6月に受理し、2026年6月11日に口頭弁論(25-2153)。判決はまだ出ていない。
なお、Rossは訴訟費用を賄えず、すでに事業を終了しています。
📗 第二 — Bartz v. Anthropic[2]:学習はよいが海賊版はだめ
スリラー作家Andrea Bartzら3人が2024年8月にAnthropicを訴えた事件です。LibGenなどの「シャドーライブラリー」から著作権のある本を大量にダウンロードしてClaudeの学習に使い、学習に使わないと決めた本まで社内図書館へ恒久保存したと主張しました。
William Alsup判事は行為を三つに分けました。この分解が核心です。
つまり学習という「目的」が正当でも、入手の「方法」は別に判断するのです。
[2] Bartz v. Anthropic — カリフォルニア北部連邦地裁、2025年6月、William Alsup判事。合法取得本のLLM学習と購入本のデジタル化はフェアユースだが、海賊版サイトからのダウンロード・保存は該当しないと判断。
第三部分は陪審審理に付されました。米国法の法定損害賠償は作品当たり最大15万ドルで、700万冊なら企業存続を揺るがす額です。結局Anthropicは15億ドルで和解し、7月20日に最終承認されました[3]。裁判所は史上最大の著作権集団訴訟和解と表現しました。
[3] Bartz事件の和解 — 2026年7月20日最終承認。総額15億ドル、約48万2,000作品が対象。
作家らは、学習したClaudeが似た本を書けるようになり市場を侵食するとも主張しました。Alsup判事は退け、子どもに文章を教えると競合作品が増えると不満を言うのと変わらないと説明しました。著作権は特定の表現を守るのであって、競争する新作が出ない権利ではないという趣旨です。
📘 第三 — Kadrey v. Meta[4]:勝ったが勝ち切ったわけではない
Sarah Silvermanら13人の作家がMetaを訴えた事件です。結果だけならMeta勝訴ですが、判決を詳しく読む必要があります。
Vince Chhabria判事は「市場の希薄化(market dilution)」理論を強く認めました。生成AIが類似作を無限に市場へ流せば原作需要と創作意欲そのものが崩れるという論理で、証明できれば第四要素、さらにはフェアユース全体で原告が勝てるとまで述べました。「子どもに文章を教える」という比喩も不適切だと正面から反論しました。
しかし原告13人は希薄化の証拠を一つも出しませんでした。Metaが学習は本の販売に影響しなかったとの資料を出した一方、原告は反証も適切な議論もせず、判事はMetaを勝たせるほかありませんでした。ただし「Metaの利用が合法という意味ではなく、原告が誤った主張をし、正しい主張を支える記録を作れなかったというだけ」と明記しました。
[4] Kadrey v. Meta — カリフォルニア北部連邦地裁、2025年6月、Vince Chhabria判事。Llama学習をフェアユースとしたが、原告が市場希薄化の証拠を提出できなかったためと明示。トレントのダウンロード時の配布(seeding)に関する請求は別途進行中。
第二事件と比べると、同じ裁判所で2日違いの判決が正反対の論理を取ったことになります。米国内でも答えは一つではないのです。
🧭 おわりに
3事件から米国の姿勢をまとめると次のとおりです。
初めて証明する候補として注目の事件があります。New York TimesのOpenAI訴訟[5]で、1月に裁判所は匿名化したChatGPT会話ログ2,000万件全件の提出を命じました。有料記事の代替を日常的に生成したなどの市場侵害の状況が分かれば、Meta事件の作家らができなかった立証が初めて実現するかもしれません。
[5] The New York Times Co. v. Microsoft Corp. & OpenAI — ニューヨーク南部連邦地裁、1:23-cv-11195、Sidney Stein判事。2023年12月提訴。2025年4月にOpenAIの棄却申立ての大半を退け、学習が本質的に変容的との主張を排し、フェアユースには事実審理が必要と判断。その後、他の報道社・作家の類似訴訟とMDL No. 3143に統合され同じ裁判部で審理中。2026年8月現在は証拠開示段階で、公判日は未定。
2回で見た両大陸の答えは分かれます。ドイツは「必要範囲を超える複製を伴う学習にはライセンスが必要」、米国は「学習は変容的なのでフェアユース」とし、取得経路と市場影響を留保しました。
韓国はどちらへ進むでしょう。作品がモデル内にどう残るか、それとも利用の変容性と市場影響か、どちらの問いを重視するかで同じ事案でも結論は大きく違います。現在のTDM免責導入議論で輪郭が見えてくるでしょう。
#技術と制度のあいだ #AI著作権 #フェアユース #FairUse #Anthropic #TDM #生成AI