
AIを勉強してみると自然に浮かぶ質問があります:
私たちの脳をよく理解すれば、AIもよく理解できるだろうか?逆にAIをよく理解すれば脳もよく理解できるだろうか?いや、その前に、 そもそも二つが似ているのは一かな?
この質問は思ったより難しく、誰も簡単に答えることができませんでした。
そして2019年、PNASに掲載された論文が突破口を開いた。 Saxe et al., 「A Mathematical Theory of Semantic Development in Deep Neural Networks」(PNAS, 2019).
この記事は、論文の著者であるSaxe教授のLab(The Thinking Lab、University College London)で研究中の Jin Hwa Lee と書かれています。
🧠近く、遠く、脳科学とAI
1940-80年代の科学者たちは、脳の作動構造を模したニューラルネットワークがAIの基盤になることを示しました。
1940年代、McCullochとPittsはニューロンがどのように機能するかを数式に移しました。その後、1980年代、RumelhartとMcClellandはPDP(並列分散処理)モデルを提案しました。脳のニューロンが互いに接続されて並列に動作するように、人工ニューラルネットワークもそのように設計できるというアイデアでした。脳をまねた構造で「知能」を学習させることができることを初めて見せたのです。これが今日のディープラーニングの直接的な出発点になりました。
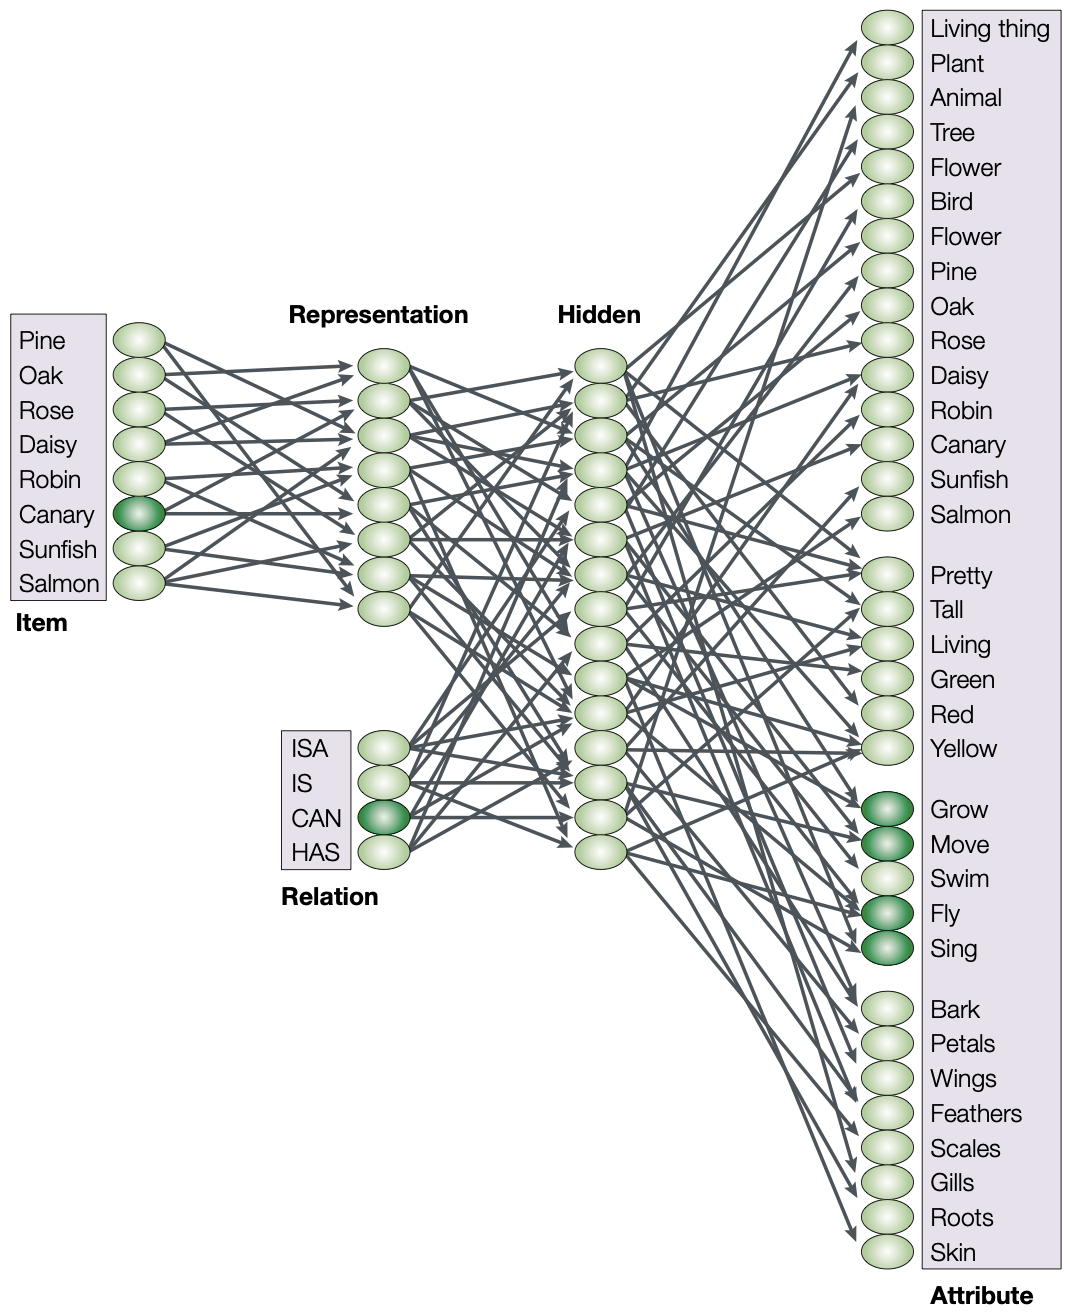
しかし、時間が経つにつれて、2つの分野はますます離れています。
脳科学は実際の神経回路を深く掘り下げました。タツノオトシゴが記憶を作り、扁桃体が恐怖を処理し、ドーパミンが報酬学習を調整するというように、生物学的に深くなりました。
AIは性能だけを基準に発展していきました。変圧器が出てきて、巨大言語モデルが出てきた。ニューロンをまねるという当初の目標はいつの間にか後戦になりました。
二つの違いをまとめるとこんな感じです。
脳科学は観察の言語を書きます:
すべて精巧に蓄積された観察結果ですが、それがなぜそうなのか、条件を変えればどのように変わるのか計算できません。
AIは試行錯誤の言語を書き込みます。
変えてみて、結果を確認して、また変えてみましょう。 何が動作するのかはわかりますが、なぜそれが動作するのかわかりません。
その後、2010年代のディープラーニングブーム以降、AIと脳科学の関係が再照明されました。実際、両者の間に興味深い類似性が発見され始めた。 の画像を学習したディープラーニングモデルが脳の視覚皮質に似た階層的な活動パターンを示しているは研究が出てきて(Yamins&DiCarlo、2014)、2つの分野がお互いを理解するのに役立つことが期待されています。
しかし、期待とは異なり、相互理解に大きな進展はありませんでした。類似性は観察されたが、なぜそのようなつながりが生じるのかはまだ明快に説明されておらず、の2つの分野の会話は主にたとえ話のレベルにとどまった。 2つの分野は使用する言語とは異なるためです。
このギャップを埋めるには、2つの分野が共有できる3番目の言語が必要でした。
💡論文が選択した戦略:わざと単純に
2019年、PNASに掲載されたSaxeの論文は、ニューラルネットワークベースのAI学習過程を式で説明すると、私たちの認知の発達過程で見られる変化を予測できるを示しました。両方のシステムが動作する原理を一緒に説明できる言語は、まさに数学でした。
の簡素化はやや細部をぼかすことができますが、どのシステムの本質を明らかにするために最も強力な武器にもなります。物理学の理想気体法則は実際の気体を完全に説明することはできませんが、数え切れないほど多くの分子からなる気体がどのように変化して運動するかをいくつかのコア変数で正確に捉えているように言います。
著者は最初から実際の脳や最新のAIモデルを分析しようとしませんでした。どちらも複雑すぎて式で完全に解くことができないからです。
代わりに、著者は深い線形ニューラルネットワーク(deep linear network)というモデルを選択しました。これは非線形活性化関数を除去した単純なネットワークである。
🗝️論文の核心:ニューラルネットワークの学習を数学的に解く
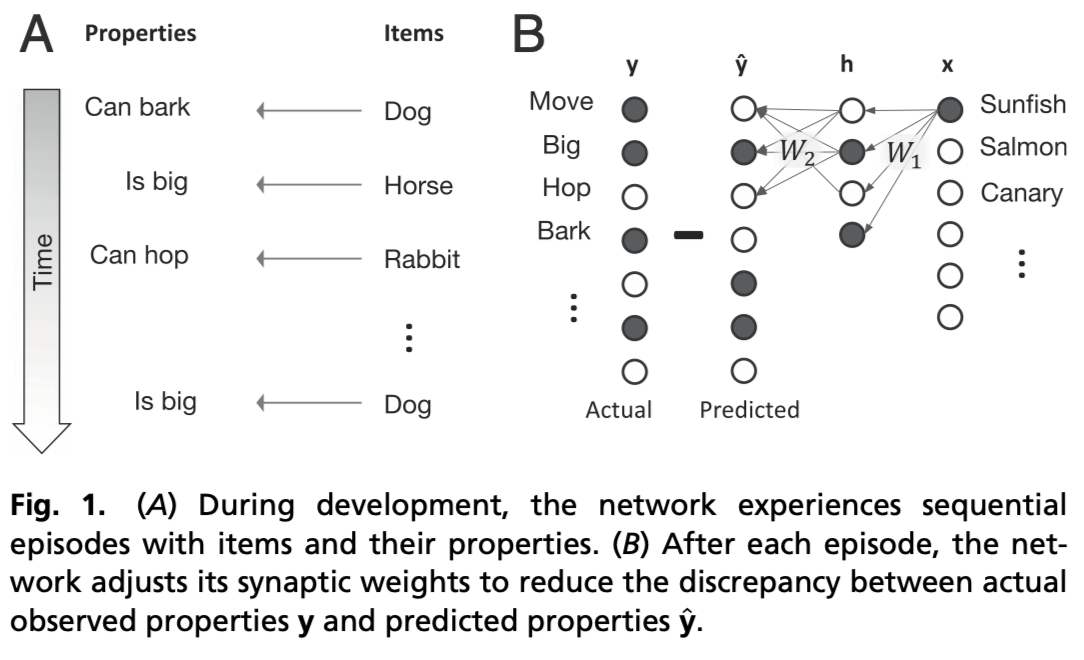
著者らは、深層線形ニューラルネットワークを傾斜下降法で訓練する際に、重みが時間とともにどのように変化するかを微分方程式で表して解いた。つまり、ニューラルネットワークの学習態様をリアルタイムで追跡したわけです。
微分方程式を解くことにより、先に例示した理想気体法則のように数千数万個からなるニューラルネットワークの学習もはるかに少ない数の変数でその態様を簡潔に説明することができました。
その結果をまとめるとこんな感じです。ニューラルネットワークはデータ内のパターンをランダムに学習するのではなく、
学習されます。
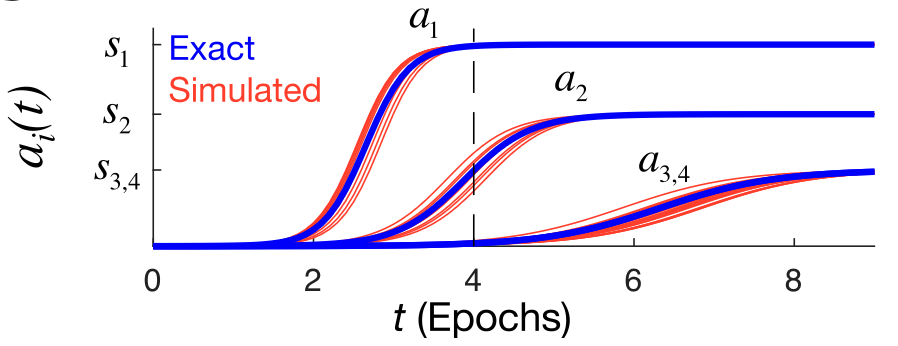
パターンの重要性についてもう少し説明しましょう。
動物とその特徴からなるデータがある場合、その中には複数の階層のパターンが混ざっています。この時パターンとは、データに現れる区別で、例えば「鳥か魚か」、「鳩かすずめか」などをいいます。このとき、層はデータ全体に強く現れ、より重要なパターン(「鳥か魚か」)、データの一部にのみ現れ、あまり重要なパターン(「鳩かすずめか」)に分けられます。
傾斜降下法は、データ全体で強く現れるパターンを最初にキャプチャし、データの一部にのみ現れるパターンは後でキャプチャします。
🔢数学で認知科学を説明する
以上の結果から、認知科学が過去数十年間観察してきた様々な現象が一度に説明されます。そのうち、いくつか紹介します。
①大きなカテゴリ(「動物」)を小さなカテゴリ(「ハト」)の前に学習
子供たちは、詳細項目より大きいカテゴリを最初に理解します。 「ハト」より「鳥」を、「鳥」より「動物」を先にした式です。
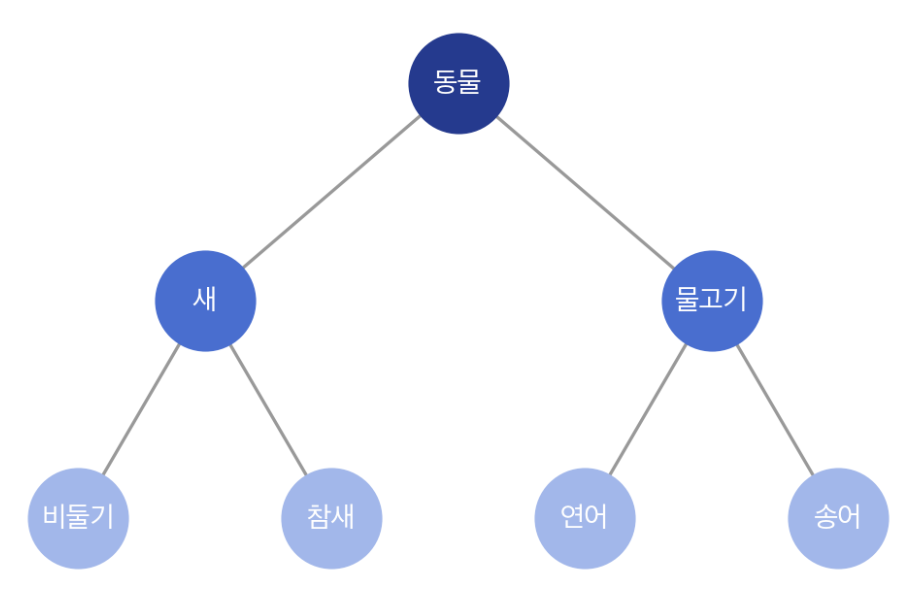
論文の式から導き出されたところによると、これらの学習の順序は数学的必然性です。
② ピアジェ(Piaget)の認知発達理論
ピアジェは子供の発達が連続的ではないと言いました。少しずつ良くなるのではなく、長い停滞期の後ろに突然跳躍する段階が繰り返されるそうです。
数式で導き出されたS字曲線はこれと正確に一致します。そして、複数のパターンが異なる時点に切り替わるので、外から見ると「ステップ」のように見えます。
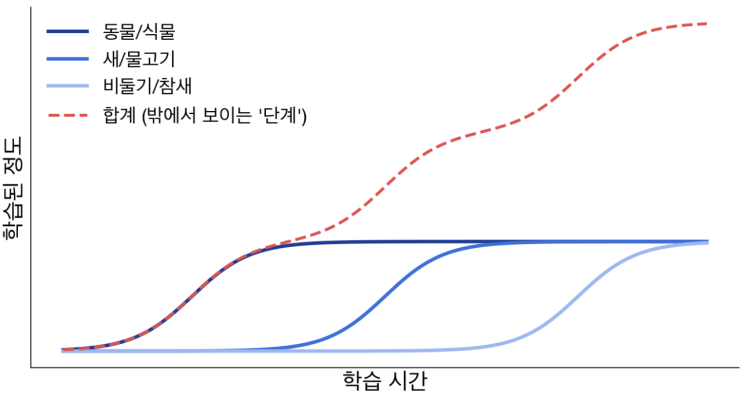
ピアジェが数十年間子供たちを観察して帰納した児童発達段階も学習アルゴリズムの数学的必然です。
③ U字型学習曲線 - 幼児学習過程の一時的なエラー
子供の一般的な学習パターンがあります。まさに「一度間違って修正される」パターンです。たとえば、「サーモンが飛ぶことができますか?」という質問に、学習の初めには「いいえ」と答えます。ところがある時点からちょっと「はい」と答えたが、後でまた「いいえ」に戻ってくる式です。これはすべての子供たちに共通して現れます。なぜですか?
パターンは重要度順に学習されるため、子供たちには広範な区分(「動物である/いいえ」)は学習されていますが、まだ細部区分(「新しいvs魚」)は学習されていない時点があります。この状態で細部区分に関する事実(「鳥は飛ぶことができる」)を学ぶと、鳥と魚をまだ同じ束で処理するネットワークが、鳥に対する特徴を魚にも適用してしまうのです。その後、詳細な区分の学習が完了すると、これらのエラーは消えます。
つまり、私たち全員が経験した子供時代のこの過渡的な学習エラーも数学的必然性であるということです。
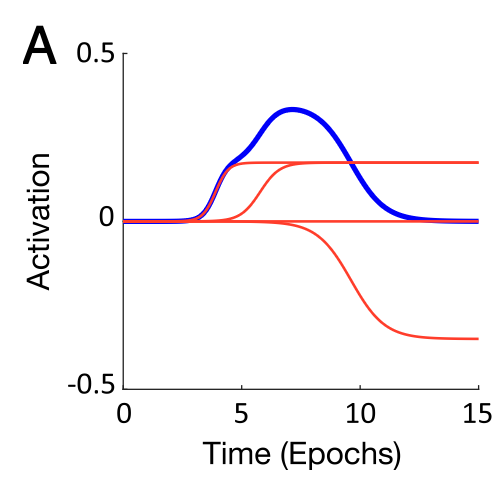
まとめると、この論文はそれぞれ異なる心理学者が、異なる実験で、異なる理論で説明してきた現象を深層ニューラルネットワークの学習過程を表現する式からすべて導出してきました。
著者らはこの結果を置き、この単純な式が脳自体ではないが、経験を通じて脳の表象が発達する過程を覗く「数学的に扱える窓」と表現します。そしてこの窓がいつか脳という生物学的ハードウェアで心の高次元的計算がどのように出現するかを明らかにする足場になることを願うという言葉で論文を結びます。
🧭仕上げ
脳科学とAIをつなぐ第3の言語が数学だったこと、そしてこれから数多くの認知科学的事実が一度に説明されたというのが今回の話でした。
次の本では、この論文が脳科学とAIの各分野に貢献したところ、「人間は白紙に生まれるか」という古い論争にどのような答えを与えるのかを見ていきます。そしてこの記事の共同執筆者であるイ・ジンファ研究員と簡単に分けた問答も付け加える予定です。
#技術課題の間#AI#脳科学#認知科学#ディープラーニング#論文紹介