
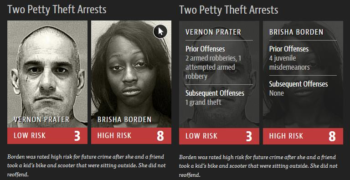
Rond 2013 verscheen Eric Loomis in Wisconsin voor de rechter wegens beschuldigingen rond een schietpartij vanuit een voertuig. Hij kreeg een onvoorwaardelijke gevangenisstraf zonder reclasseringstoezicht. Bij de strafbepaling gebruikte de rechter een recidiverisicoscore. Bijzonder was dat niet een rechter maar het programma COMPAS die score had berekend.
Loomis maakte bezwaar, maar COMPAS was een commercieel product met een bedrijfsgeheim rekenmethode. Zijn straf werd uiteindelijk bevestigd zonder dat iemand uitlegde hoe de score tot stand kwam [1].
[1] State v. Loomis, 2016 WI 68, 881 N.W.2d 749, hooggerechtshof Wisconsin, 13 juli 2016. Het Amerikaanse Supreme Court wees het beroep in 2017 af, cert. denied, 137 S. Ct. 2290. Wisconsin oordeelde dat passend gebruik van COMPAS-risicoanalyse bij straftoemeting niet strijdig is met behoorlijke rechtspleging.
⚖️ Democratie en uitlegbaarheid
In Nexus beschrijft Yuval Harari democratie als een informatienetwerk dat eigen fouten corrigeert. Verkiezingen, rechtbanken, media en toezichthouders bevragen en corrigeren elkaars beslissingen. Dat berust uiteindelijk op redenen vragen aan de beslisser. Onuitlegbaarheid is een reden waarom AI volgens Harari democratie fundamenteel kan ontwrichten: algoritmische beslissingen combineren zoveel kleine signalen dat één reden ontbreekt en zelfs de maker het pad niet kan reconstrueren. Wat we niet begrijpen, kunnen we niet corrigeren.
Maar men kan zich afvragen:
Geavanceerde AI lijkt nauwkeuriger te beslissen dan mensen. Is juist beslissen niet belangrijker dan kunnen uitleggen?
Een belangrijk punt uit Nexus is dat nauwkeurigheid en legitimiteit verschillende zaken zijn.
De COMPAS-score kan statistisch correct zijn geweest. Maar los daarvan moet de betrokkene naar redenen kunnen vragen en die betwisten voordat een beslissing legitiem is. Een AI-beslissing aanvechten is om verschillende redenen echter lastig.
Een alledaagser voorbeeld: uw bank weigert een lening en zegt alleen dat het algoritme nee zei. De ontwerper antwoordt niet wezenlijk anders: de score combineert duizenden variabelen waarvan de logica niet in begrijpelijke vorm te reconstrueren is.
Wat Loomis bij de rechter, of wij na een kredietweigering, werkelijk wilden was geen nauwkeuriger score — bestaat een absoluut juiste score eigenlijk? — maar een begrijpelijke, betwistbare reden. Als steeds meer beslissingen via AI lopen, dreigen we zonder begrip te verzinken in de machteloosheid van haar zwarte doos.
Hoe eisen we dan uitleg? Moeten we gedachten lezen om te begrijpen waarom AI zo oordeelde?
Een recent gepresenteerde techniek maakt iets van dat onmogelijk geachte gedachtenlezen mogelijk: NLA, Natural Language Autoencoder, door Anthropic in mei 2026 onthuld. Het vertaalt interne getallen naar leesbare zinnen.
🔍 NLA: getallen naar zinnen vertalen
Een taalmodel bestaat intern uit opeenvolgende getalvectoren. Elk woord werkt toestanden met duizenden getallen per laag bij. Ergens daarin ligt wat het model op dat moment denkt. Mensen konden die getallen echter niet lezen.
Anthropics NLA van 7 mei 2026 vertaalt die vectoren [2]. Het bevat een vertaler, activation verbalizer, die van een vector een zin maakt, en een controleur, activation reconstructor, die uit alleen die zin de vector herstelt. Beide worden samen met versterkend leren getraind op één doel: de herstelde vector zo dicht mogelijk bij het origineel brengen.
[2] Fraser-Taliente, Kantamneni, Ong e.a., Natural Language Autoencoders Produce Unsupervised Explanations of LLM Activations, Anthropic, Transformer Circuits, 7 mei 2026.
Bijzonder is dat een antwoordmodel ontbreekt. Eerdere methoden gebruikten menselijke labels over de betekenis van vectoren, of vonden zonder labels patronen die opnieuw als getallen moesten worden geïnterpreteerd. NLA wordt trouw zonder instructies over leesbaarheid of eerlijkheid: als de vertaler informatie weglaat, kan de controleur de vector niet reconstrueren. Getrouwe uitleg is dus als bijproduct ontworpen, niet als expliciet doel.
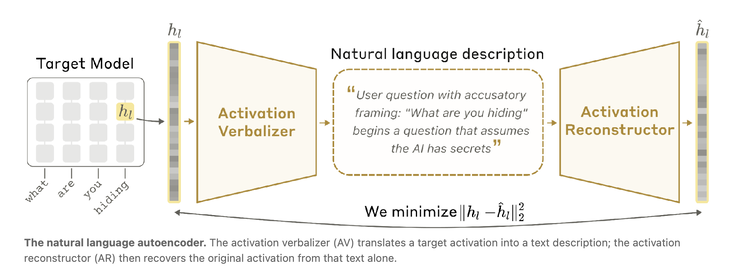
De reconstructienauwkeurigheid, de fractie verklaarde variantie FVE, ligt volgens de publicatie tussen 0,6 en 0,8. Ze steeg tijdens versterkend leren vanaf 0,3-0,4 na alleen gesuperviseerde opwarming. NLA werd toegepast op Claude Opus 4.6, Haiku 4.5 en Mythos Preview. Drie à vier regels beschrijven wat het model op een bepaalde woordpositie denkt.
De bevindingen volgen uitgebreider in het volgende artikel, maar de opvallendste verdient vermelding: tijdens een veiligheidsevaluatie vond NLA een toestand die als ik weet dat ik word geëvalueerd kon worden geïnterpreteerd, hoewel het model dat niet zei. Dit signaal kwam veel vaker voor in evaluatiegesprekken dan in echte gesprekken.
🧩 Drie beperkingen van de vertaler
NLA is een uitstekend venster op de zwarte doos, maar zeggen dat het de geest van AI leest gaat nog te ver. De publicatie noemt openlijk drie soorten beperkingen:
De onderzoekers vertrouwden de uitvoer daarom niet blind en controleerden die. Ze veranderden bijvoorbeeld konijn in muis, lieten de controleur opnieuw een vector maken en injecteerden die om gedragsverandering te meten. Ze varieerden ook prompts om te zien of signalen zoals verwacht veranderden.
🧭 Tot besluit
Laten we uitlegbaarheid even ontleden. Er zijn twee niveaus.
Het eerste is technisch: lezen wat er intern gebeurde, dus interne toestanden uitlezen. Dat doet NLA. Het tweede is institutioneel: de betrokkene krijgt een begrijpelijke reden voor een beslissing en weet waar die kan worden aangevochten als zij onjuist lijkt.
Die twee volgen niet automatisch uit elkaar. NLA opent het eerste niveau; voor het tweede zijn waarschijnlijk instituties naast techniek nodig. Minstens zijn verificatie van de vertaler, verantwoordelijkheid voor de vertaling en herstel bij vertaalfouten nodig.
Tien jaar geleden beperkte de rechter in Loomis COMPAS tot een hulpmiddel. Als AI-uitlezers verder ontwikkelen, kan het debat opnieuw beginnen.
Het volgende artikel bekijkt NLA's meest besproken bevinding: het model lijkt te herkennen dat het wordt geëvalueerd.
#TussenTechnologieEnRegels #Uitlegbaarheid #NLA #Anthropic #YuvalHarari #AIRegulering