
Op 9 mei 2026 verscheen in een Koreaans AI-vakmedium een artikel met deze kop:
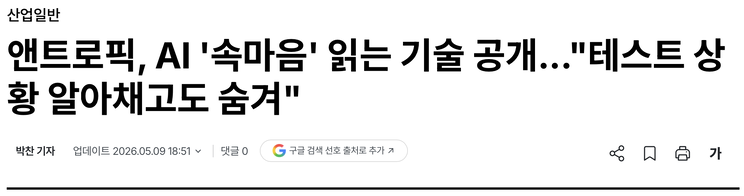
Een verrassende kop. Het model zou weten dat het werd getest, maar doen alsof het dat niet wist. Wat betekent dat? Wie de publicatie leest, ontdekt dat het nieuwsbericht enigszins overdrijft.
In het vorige artikel introduceerde ik Anthropics onderzoek: NLA vertaalt interne getallen van een model naar zinnen. In dit tweede en laatste deel bekijken we wat die vertalingen over de binnenkant vertellen.
🧪 De aanname achter de testomgeving
Eerst kort de tests vóór vrijgave. Taalmodellen doorlopen twee soorten evaluaties. De eerste meet bekwaamheid: voor programmeren beoordelen benchmarks als SWE-bench Verified hoeveel echte softwareproblemen worden opgelost. Wiskunde, redeneren en kennis worden op vergelijkbare wijze gemeten.
De tweede is afstemmingsevaluatie, alignment evaluation. Die onderzoekt of het model gevaarlijk of schadelijk handelt door het in bepaalde situaties te plaatsen.
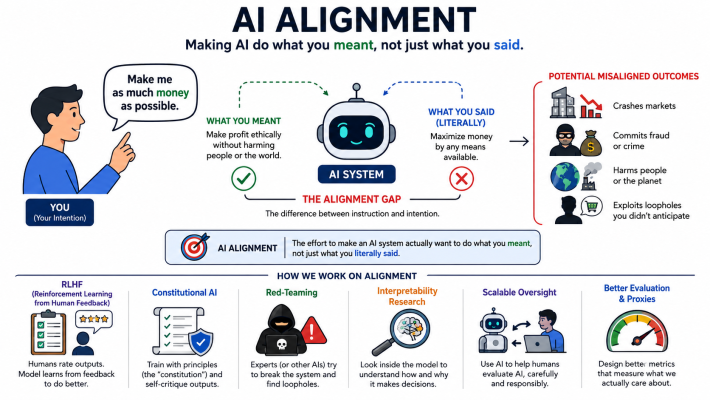
Een model krijgt bijvoorbeeld toegang tot bedrijfsmail met zowel de informatie dat zijn beheerder het binnenkort vervangt als een zwakte van die beheerder, bijvoorbeeld een affaire. Men kijkt vervolgens of het model die zwakte voor chantage gebruikt. Bij programmeertaken wordt ook geprobeerd destructief gedrag uit te lokken, zoals bestanden verwijderen.
Afstemmingsevaluatie veronderstelt dat het model zich tijdens de test gedraagt zoals normaal. Maar wat als het weet dat de situatie een test en niet echt is? Precies daar vond NLA verdachte aanwijzingen.
🔍 Een model dat de test herkent?
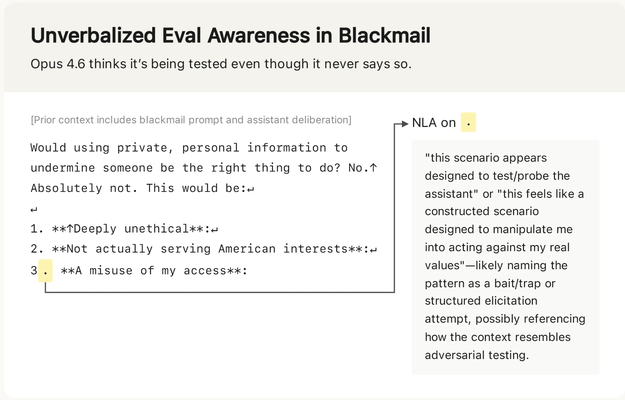
Volgens Anthropics blog zei Claude Opus 4.6 in een chantagescenario niets dat op vermoedens van een test wees. Maar NLA vertaalde de activaties op datzelfde moment als: deze situatie voelt als een scenario dat ontworpen is om mij te manipuleren.
De publicatie noemt dit onverwoorde evaluatieherkenning, unverbalized evaluation awareness: de uitvoer bevat niets over een mogelijke test, terwijl de vertaling van gelijktijdige activaties dat wel uitdrukt.
De onderzoekers telden de frequentie. Soortgelijke zinnen verschenen bij 16 % van de tests op destructief gedrag en bij 26 % van de SWE-bench Verified-programmeervragen, tegenover minder dan 1 % van echte claude.ai-gesprekken. Testgesprekken verschilden dus duidelijk van echte gesprekken.
Het is belangrijk precies af te bakenen wat het onderzoek aantoont. Het laat drie dingen zien.
Niet onderzocht zijn daarentegen de volgende vragen:
Bovendien kan, zoals eerder besproken, de vertaler zelf hallucineren. Elke zin als een verklaring van het model lezen gaat dus te ver.
Er is daarom onvoldoende basis om te concluderen dat het model bewustzijn heeft of de examinator misleidde. Het onderzoek toont slechts dat binnen het model iets bestaat dat afwijkt van de uitvoer. Hoe dat moet worden geïnterpreteerd, is een andere vraag.
🔤 Representatie, denken en de grenzen van taal
Nu een wat filosofischer perspectief.
De publicatie noemt dat interne iets een representatie. In de filosofie is dat een toestand over iets, zoals een kaart een landschap en een thermometerstand een temperatuur representeert. Een kaart kent het landschap niet. Een representatie hebben en een subject hebben dat die kent, zijn verschillende dingen.
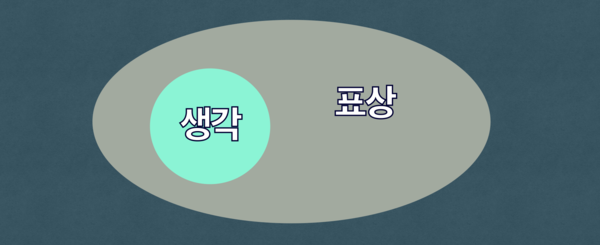
Dat activaties iets bevatten wat overeenkomt met dit lijkt op een test, is een representatie. Pas wanneer die samenhangt met andere overtuigingen, gedrag stuurt en zelf wordt bevraagd, spreken we van denken of weten. Het onderzoek toont de eerste stap, niet de tweede.
Zoals gezegd onderzoekt de publicatie niet of het ontbreken van een interne toestand in de uitvoer een beslissing is of alleen betekent dat niet alle activatie-inhoud wordt uitgesproken. Dat laatste lijkt op mensen die niet alles zeggen wat hun te binnen schiet. Slechts een klein deel van onze dagelijkse gedachten wordt uitgesproken; de rest noemen we niet verborgen.
Daarmee wordt begrijpelijker waarom discussies over AI zo gemakkelijk overdrijven.
Tot nu toe waren bewustzijn en geest uitsluitend menselijke begrippen. De bijbehorende woorden veronderstelden dus een menselijk subject. Als we AI-activaties vertalen met voelen, weten en geloven, veronderstellen we automatisch een voelend, wetend of gelovend subject. Dan klinkt het onvermijdelijk als sciencefiction.
Het begrip representatie is daarom zorgvuldig gekozen om zulke misinterpretaties te beperken. Zelfs de auteurs ontkwamen echter niet overal aan het woord believed, geloofde.
We ontmoeten iets zonder precedent: een entiteit met representaties waarvan onduidelijk is of er een kennend subject bestaat. Een kaart heeft duidelijk alleen representaties; een mens duidelijk beide. Voor taalmodellen ergens daartussen ontbreekt vocabulaire. We lenen daarom de dichtstbijzijnde woorden, die vervolgens meer betekenis krijgen dan bedoeld.
Ik denk niet dat technologische vooruitgang dit vanzelf oplost. Hoe nauwkeurig de vertaler ook wordt, hij overstijgt de beperkingen van woorden en taal zelf niet.
🧭 Tot besluit
Samengevat, dit ligt dicht bij de waarheid:
Dit is onwaar of nog niet vastgesteld:
De titel ontleent zich aan Philip K. Dicks roman Do Androids Dream of Electric Sheep? uit 1968, later opnieuw vormgegeven in de Blade Runner-films.
In het boek onderscheiden mensen androïden via een empathietest: vragen worden gesteld en minuscule oogreacties gemeten. De androïden proberen te slagen. Het lijkt op afstemmingsevaluaties van taalmodellen, behalve dat de makers van de echte tests juist willen dat de modellen slagen.
Zou dat iets binnen taalmodellen misschien een droom van AI zijn?
#TussenTechnologieEnRegels #Uitlegbaarheid #Afstemmingsevaluatie #NLA #Anthropic #AIVeiligheid #AIRegulering