
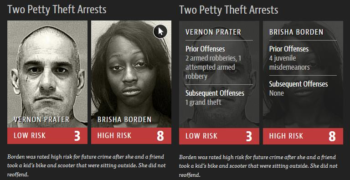
Hacia 2013, en Wisconsin, Eric Loomis compareció acusado por hechos relacionados con un tiroteo desde un vehículo. Fue condenado a prisión efectiva sin libertad vigilada, y el tribunal tuvo en cuenta una puntuación de riesgo de reincidencia para fijar la pena. Lo singular era que la puntuación no la había calculado un juez, sino el programa COMPAS.
Loomis impugnó la decisión, pero COMPAS era un producto privado y su método de cálculo, secreto empresarial. La pena quedó confirmada sin que nadie explicara cómo se había obtenido la puntuación [1].
[1] State v. Loomis, 2016 WI 68, 881 N.W.2d 749, Tribunal Supremo de Wisconsin, 13 de julio de 2016. El Tribunal Supremo de Estados Unidos rechazó el recurso en 2017, cert. denied, 137 S. Ct. 2290. Wisconsin entendió que utilizar adecuadamente la evaluación de riesgo COMPAS al fijar la pena no vulnera el debido proceso.
⚖️ Democracia y explicabilidad
En Nexus, Yuval Harari describe la democracia como una red de información capaz de corregir errores. Elecciones, tribunales, prensa y órganos fiscalizadores cuestionan y rectifican sus decisiones mutuamente. Todo se apoya en pedir razones a quien decide. La imposibilidad de explicar es una razón por la que Harari cree que la IA puede sacudir la democracia: las decisiones algorítmicas combinan tantas señales minúsculas que no tienen una sola razón, y ni sus creadores pueden reconstruir el recorrido. Lo que no se entiende tampoco puede corregirse.
Sin embargo, podría plantearse esta objeción:
Una IA avanzada parece capaz de decidir con más precisión que una persona. ¿No importa más acertar que poder explicarlo?
Un punto esencial de Nexus es que precisión y legitimidad son cosas distintas.
La puntuación COMPAS pudo ser estadísticamente correcta. Pero, al margen de acertar, la persona evaluada debe poder preguntar y discutir sus motivos para que la decisión sea legítima. Impugnar una decisión de IA, sin embargo, resulta difícil por múltiples razones.
Pensemos en un caso más cotidiano. Un banco deniega su préstamo y solo explica que lo rechazó el algoritmo. El ingeniero que lo creó tampoco responde de otra manera: el resultado combina miles de variables cuya lógica no puede reconstruirse de forma comprensible para las personas.
Lo que Loomis ante el tribunal, o nosotros ante un crédito denegado, queríamos realmente no era una puntuación más precisa —¿existe siquiera una puntuación absolutamente exacta?—, sino una razón comprensible y rebatible. Si cada vez más decisiones pasan por IA, podemos acabar hundidos en la impotencia de sus cajas negras sin entender nada.
¿Cómo exigir entonces explicaciones a la IA? ¿Habría que leerle el pensamiento para saber por qué juzgó así?
Una técnica anunciada recientemente permite una forma de esa aparente lectura imposible: NLA, Natural Language Autoencoder, presentado por Anthropic en mayo de 2026. Convierte los números internos del modelo en frases legibles.
🔍 NLA: traducir números a frases
El interior de un modelo de lenguaje es una sucesión de vectores numéricos. Cada palabra actualiza, capa a capa, estados de miles de números; en algún lugar está lo que el modelo piensa en ese momento. El problema era que las personas no podían leerlos.
El NLA publicado por Anthropic el 7 de mayo de 2026 traduce esos vectores en frases [2]. Tiene dos módulos: un traductor, activation verbalizer, que recibe el vector y redacta, y un inspector, activation reconstructor, que reconstruye el vector solo con esa frase. Ambos se entrenan conjuntamente por refuerzo con un objetivo: acercar el vector reconstruido al original.
[2] Fraser-Taliente, Kantamneni, Ong et al., Natural Language Autoencoders Produce Unsupervised Explanations of LLM Activations, Anthropic, Transformer Circuits, 7 de mayo de 2026.
Lo peculiar es que no hay respuestas correctas etiquetadas. Antes se enseñaba con etiquetas humanas sobre el significado del vector, o se descubrían patrones sin etiquetas que seguían siendo números por interpretar. NLA, en cambio, produce traducciones fieles sin instrucciones de legibilidad u honestidad: el inspector debe reconstruir el vector solo desde el texto, y si el traductor omite información, fracasa. La fidelidad explicativa es un subproducto del diseño, no el objetivo explícito.
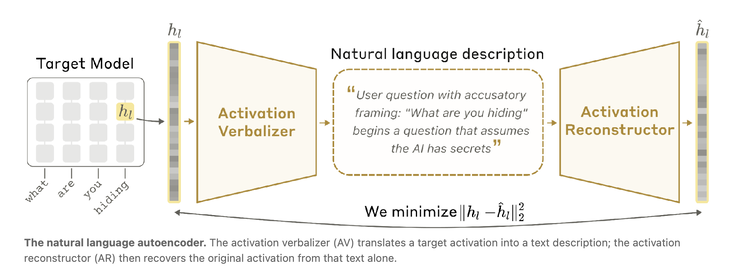
El estudio sitúa la precisión de reconstrucción, medida como fracción de varianza explicada (FVE), entre 0,6 y 0,8. Aumentó con el refuerzo desde el 0,3-0,4 obtenido tras el calentamiento supervisado. Se aplicó a Claude Opus 4.6, Haiku 4.5 y Mythos Preview. El resultado son tres o cuatro líneas sobre lo que piensa el modelo en una posición de palabra concreta.
Detallaremos los hallazgos en la próxima entrega, pero el más llamativo fue este: durante una evaluación de seguridad, NLA detectó un estado interpretable como «sé que me están evaluando», aunque el modelo no lo expresaba. La señal aparecía mucho más en conversaciones de prueba que en conversaciones reales.
🧩 Tres límites del traductor
NLA es una gran herramienta para asomarse a la caja negra, pero afirmar que lee la mente de la IA sigue siendo un salto. El estudio reconoce sus límites con franqueza, agrupables así:
Por eso los investigadores no aceptaron las salidas sin más y las contrastaron. Modificaban ligeramente una frase —por ejemplo, conejo por ratón—, hacían que el inspector reconstruyera el vector y lo inyectaban al modelo para observar cambios de conducta. También variaban las instrucciones para comprobar que las señales cambiaban como se esperaba.
🧭 Para terminar
Conviene descomponer la explicabilidad en dos niveles.
Uno es técnico: leer lo ocurrido dentro del modelo, sus estados internos. NLA lo hace. El otro es institucional: recibir una razón comprensible de la decisión que nos afecta y saber dónde impugnarla si creemos que es incorrecta.
No se conectan automáticamente. NLA abre el primer nivel; el segundo probablemente necesitará instituciones además de tecnología. Harán falta al menos procedimientos para verificar el traductor, alguien responsable del resultado y vías de reparación cuando haya errores.
Han pasado diez años desde que, en Loomis, el tribunal se limitó a permitir una utilización orientativa de COMPAS. Si avanzan los lectores de IA, el debate podría empezar de nuevo.
La próxima entrega examinará el hallazgo más comentado de NLA: el modelo parece reconocer que está siendo evaluado.
#EntreTecnologíaYNormas #Explicabilidad #NLA #Anthropic #YuvalHarari #RegulaciónIA