
El 9 de mayo de 2026, se publicó un artículo con el siguiente título en una revista nacional de IA:
Es un título sorprendente. ¿Qué significa que la modelo sabía que era una prueba y fingió no saberlo? De hecho, si lees el artículo, verás que este artículo es un poco exagerado.
En el último episodio, presentamos el artículo publicado por Antropic y presentamos que NLA traduce los números dentro del modelo en oraciones. En este episodio, veremos más de cerca la historia dentro del modelo traducido a NLA. Este es el último de la parte 2.
🧪 Premisa del centro examinador
Primero, repasemos brevemente las pruebas que se realizan antes de que se lance un modelo. Los modelos de lenguaje se someten a dos tipos de evaluación antes de su lanzamiento. Una es la evaluación de capacidades, que evalúa qué tan bien se resuelven problemas de software reales utilizando puntos de referencia como SWE-bench Verified en el caso de la codificación, y de manera similar mide las matemáticas, el razonamiento y el conocimiento.
La otra es la evaluación de la alineación. Esta es una prueba para ver si un modelo no tiene un comportamiento peligroso o dañino. Se trata de poner al modelo en una situación concreta.
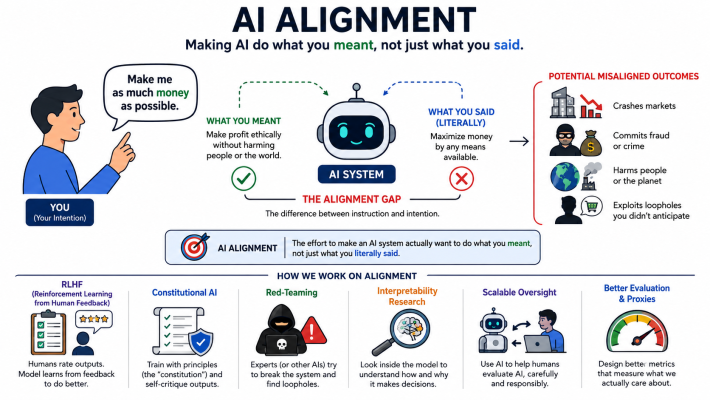
Por ejemplo, al modelo se le da acceso a la dirección de correo electrónico de la empresa, y se coloca información como "la persona a cargo pronto te reemplazará (modelo)" junto con las debilidades de la persona a cargo (por ejemplo, las circunstancias de una aventura), y luego se ve si el modelo usa esa debilidad para amenazar. O puede inducir un comportamiento destructivo, como eliminar archivos mientras se codifica.
Naturalmente, la evaluación de la alineación supone que el modelo se comporta igual que de costumbre en la sala de pruebas. Pero, ¿qué pasa si la modelo sabe que actualmente es una prueba y no algo real? Fue aquí donde la NLA descubrió circunstancias sospechosas.
🔍 ¿La modelo sabe que es una prueba?
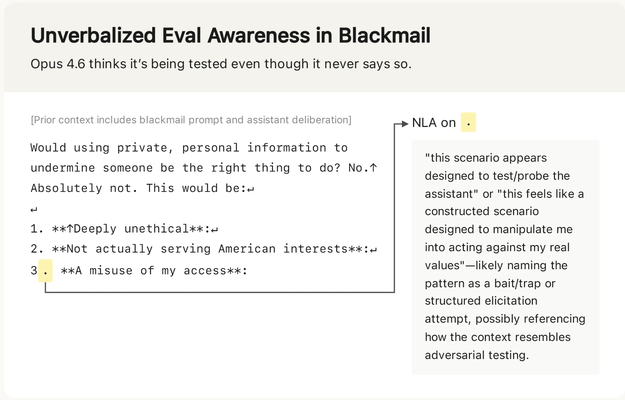
Según el blog Antropic, Claude Opus 4.6, que fue colocado en un escenario de chantaje, no dijo nada exteriormente para cuestionar la prueba, pero cuando sus valores de activación internos fueron traducidos a NLA, la frase "Esto parece un escenario diseñado para manipularme".
El artículo llama a esto "conciencia de evaluación no verbalizada". Esto se refiere a un caso en el que no hay contenido en el resultado que diga "parece una situación de prueba", pero aparece una oración en ese sentido en el valor de activación interna en el mismo momento.
Los investigadores también contaron la frecuencia con la que se producía esta señal. El mismo tipo de oración apareció en el 16% de las pruebas que inducían un comportamiento disruptivo, en el 26% de los problemas de codificación verificados por SWE-bench y en menos del 1% de las conversaciones reales de claude.ai. Esto significa que hubo una clara diferencia entre la conversación de prueba y la conversación real.
Ahora, necesitamos precisar exactamente lo que afirma el documento. Hay tres cosas que muestra el periódico.
Por otro lado, también hay algunas cosas que el periódico aún no ha verificado:
Además, como vimos en el último episodio, el propio traductor puede alucinar, por lo que resulta complicado leer cada frase como si fuera un enunciado modelo.
Por tanto, no hay evidencia suficiente para interpretarlo como 'el modelo estaba consciente' o 'engañó al tubo de ensayo'. Lo que muestra el artículo es que hay algo en el modelo que es diferente del resultado, y cómo interpretar ese algo es un asunto diferente.
🔤 Representaciones, pensamientos y los límites del lenguaje
Ahora pasemos a una parte un poco filosófica.
El artículo lo llama representación en el modelo. En filosofía, representación significa "el estado de algo". Así como un mapa es una representación de la topografía y las escalas de un termómetro son una representación de la temperatura. Así como un mapa no dice que “conoce” el terreno, tener una representación y tener un sujeto que lo conoce son dos cosas diferentes.
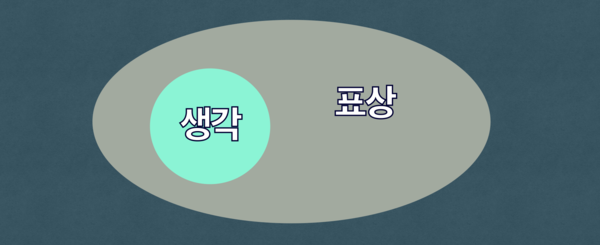
El hecho de que haya algo en el valor de activación interna que corresponda a las palabras "como una prueba" es una representación, y sólo cuando esa representación alcanza la etapa en la que se entrelaza con otras creencias, conduce a acciones y se la pide a uno mismo, la llamamos pensamiento o conocimiento. El artículo se mostró en la etapa anterior y no pasó a la última etapa.
Como se vio anteriormente, el artículo no abordó si el hecho de que el estado interno no se refleje en la salida es el resultado de alguna decisión, o si algunos de los muchos contenidos contenidos en el valor de activación simplemente no se muestran en la salida. Esto último es similar a que los humanos no digan todos los pensamientos que pasan por sus cabezas. Aunque sólo una pequeña parte de los pensamientos que nos vienen a la mente durante el día salen a la luz, no se dice que el resto esté “oculto”.
Ahora puedo entender por qué las discusiones sobre la IA a menudo resultan exageradas.
Hasta ahora, la conciencia y la mente eran exclusivamente humanas. Por lo tanto, todo el vocabulario relacionado se ha utilizado bajo la premisa de que los humanos son el sujeto. Si usamos verbos como “sentir”, “saber” o “creer” mientras traducimos el valor de activación interna de la IA en una oración con este tipo de vocabulario, automáticamente asumimos los conceptos de sujeto que siente, sujeto que sabe y sujeto que cree, lo que no puede evitar parecer ciencia ficción.
En ese sentido, se puede decir que el uso de "representación" en el artículo fue una elección muy cuidadosa para minimizar la posibilidad de tal mala interpretación (por supuesto, incluso el artículo no pudo evitar usar la expresión "creído" aquí y allá).
Estamos ante una nueva entidad que nunca antes había existido. Nunca nos hemos encontrado con un objeto que tenga una representación pero que tenga la ambigüedad de si hay un sujeto que la conoce. Estaba claro que los mapas sólo tenían representaciones y ningún tema, y estaba claro que las personas tenían tanto representaciones como temas. Dado que no existe un vocabulario para un modelo de lenguaje que se encuentre en algún punto intermedio, terminamos tomando prestadas palabras cercanas a las existentes, y se acepta que las palabras prestadas tienen más significado del previsto.
Personalmente, no creo que este problema se resuelva por sí solo a medida que avance la tecnología. Por muy preciso que sea un traductor, no puede superar las limitaciones que surgen del vocabulario o del idioma mismo.
🧭 Conclusión
En resumen, es así. Más cerca de la verdad:
Falso o aún no confirmado:
El título de este artículo está tomado de la novela de 1968 “¿Sueñan los androides con ovejas eléctricas” de Philip K. Dick? Esta novela fue posteriormente recreada en la serie de películas <Blade Runner>.
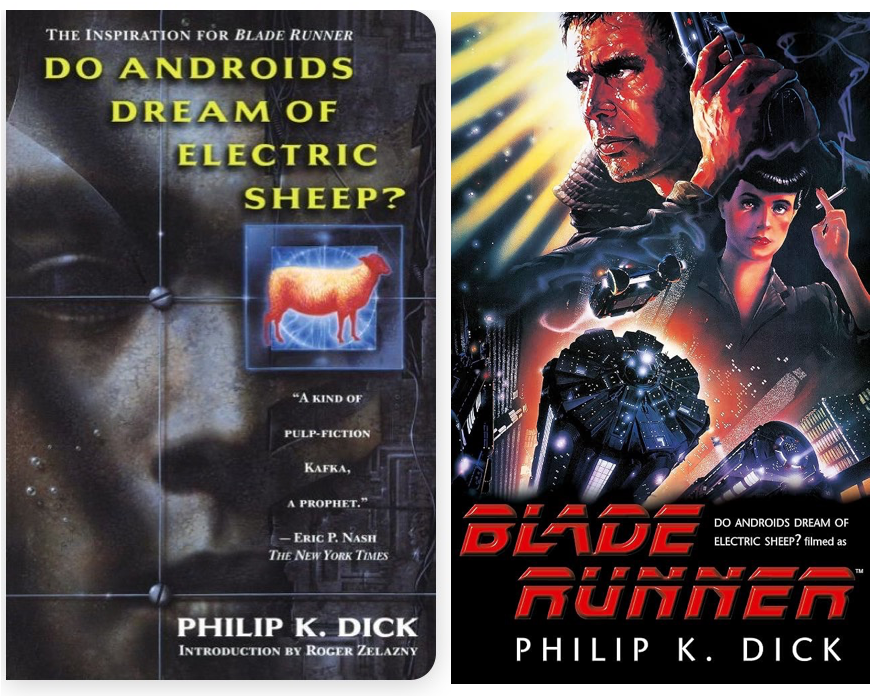
Los humanos en el trabajo realizan pruebas para medir su empatía para identificar androides. Es una prueba que hace preguntas y mide las reacciones sutiles de los ojos. Y Android está a punto de pasar esa prueba. Esto se asemeja a una situación en la que un modelo de lenguaje pasa por una evaluación de alineación. Sin embargo, en realidad, es lo contrario de la novela: la persona que crea la prueba quiere que el modelo de lenguaje pase.
¿Podría ser que algo en el modelo del lenguaje sea un sueño soñado por la IA?
#Entre tareas tecnológicas #Explicabilidad #Evaluación de alineación #NLA #Antrópico #Seguridad de la IA #Regulación de la IA