
La loi-cadre sur l’IA étudiée précédemment réglementait les mentions sur les productions, donc les sorties. Mais les litiges sur l’IA ont un autre front à l’autre extrémité : les entrées.
L’entraînement exige des quantités considérables de données, c’est bien connu. En revanche, qui doit être rémunéré, comment et même s’il faut payer restent des questions non résolues.
Lorsqu’un nouveau problème juridique apparaît, chacun attend souvent de voir qui attaquera le premier. En novembre 2025, une décision allemande a retenu l’attention générale. Deux semaines avant cet article, le 31 juillet, une autre décision de même orientation a suivi. Examinons les deux.
🇩🇪 Première décision — reproduire au-delà de l’entraînement
Savez-vous ce que répondent actuellement des agents comme ChatGPT lorsqu’on leur demande les paroles d’une chanson précise ?
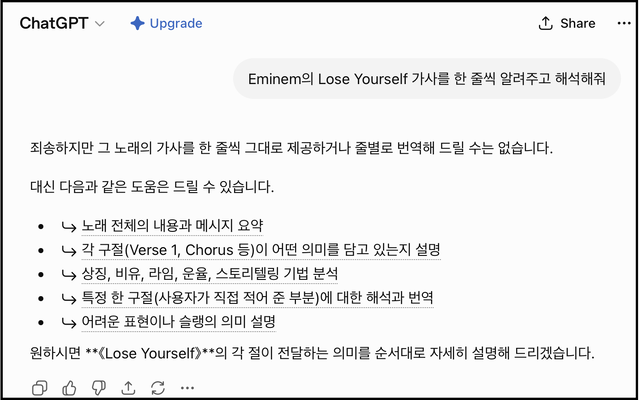
Comme illustré ci-dessus, ChatGPT ne fournit pas directement les paroles. La première décision concerne ce phénomène.
Dans le procès de la société allemande de gestion musicale GEMA contre OpenAI, le tribunal régional de Munich I a jugé contraire au droit d’auteur allemand l’entraînement sans autorisation sur des paroles puis leur reproduction par ChatGPT [1]. Neuf chansons célèbres allemandes étaient concernées, dont Atemlos, Männer et Über den Wolken.
[1] GEMA v. OpenAI — tribunal régional de Munich I, 42e chambre civile, 11 novembre 2025, dossier 42 O 14139/24. GEMA contestait l’entraînement et les sorties de paroles sans autorisation par GPT-4 et GPT-4o.
OpenAI soutenait que les modèles ne stockent pas de données spécifiques et n’apprennent que des corrélations statistiques. Le tribunal a refusé cet argument : des instructions aussi simples que demander le refrain reproduisaient presque exactement les paroles. Il a comparé cela à la compression avec perte du MP3 : même sans contenir l’original entier, si l’information statistique permet une reproduction reconnaissable, il s’agit d’une copie. Trois points en ressortent.
Précisons l’exception TDM. La fouille de textes et de données, Text and Data Mining, analyse automatiquement les œuvres pour en extraire motifs, tendances ou corrélations. Comme elle exige des copies, la directive européenne 2019/790 sur le droit d’auteur dans le marché unique numérique a prévu une exception, transposée en Allemagne à l’article 44b de sa loi [2].
Toutefois, l’article 44b exige la suppression des copies lorsqu’elles ne sont plus nécessaires à la fouille. L’exception couvre donc la durée de l’analyse, pas la conservation après sa fin. Or les modèles continuaient à offrir leurs services avec le contenu dans leurs paramètres après l’entraînement. C’est là que le tribunal a refusé l’exception.
Le tribunal a finalement ordonné à OpenAI de cesser l’atteinte, révéler l’étendue des utilisations et les revenus obtenus, et indemniser le préjudice, avec une sanction coercitive de 250 000 euros par violation.
🇩🇪 Deuxième décision — des paroles à la mélodie
Le 31 juillet dernier, la même chambre est allée plus loin, cette fois contre le générateur de musique Suno [2].
[2] GEMA v. Suno — tribunal régional de Munich I, 42e chambre civile, 31 juillet 2026, dossier 42 O 763/25. GEMA avait saisi le tribunal en janvier 2025. Les demandes de cessation, d’information et d’indemnisation ont été largement accueillies. Six œuvres étaient concernées : Atemlos durch die Nacht, Rasputin, Big in Japan, Forever Young, le refrain de Mambo No. 5 et Daddy Cool. La décision n’est pas définitive.
GEMA a démontré une forte correspondance des sorties de Suno avec les originaux en mélodie, harmonie et rythme, ce que le tribunal a accepté. C’est pratiquement la première décision publiée traitant directement des contenus audio générés par l’IA. Après les paroles, donc le texte, il s’agissait de la musique elle-même.
La défense de Suno est intéressante : l’entreprise reconnaissait déjà son entraînement sur le répertoire GEMA. Elle contestait seulement l’obligation de payer. Le téléchargement des données par stream ripping sur YouTube n’était pas non plus contesté.
Le tribunal a clairement rejeté cette position et de nouveau refusé l’exception TDM. Suno n’avait pas simplement analysé les œuvres, mais les avait conservées durablement dans le modèle pour en faire une fonctionnalité du service. L’interprétation étroite d’OpenAI, huit mois plus tôt, était maintenue.
⚖️ Et la compétence juridictionnelle ?
Un autre point important est le lieu de l’entraînement.
Suno est américaine et a entraîné ses modèles aux États-Unis. Cela constituait jusque-là une défense solide : même si le service était européen, un entraînement réalisé ailleurs ne devait pas relever du droit européen.
Cet argument avait effectivement fonctionné dans Getty Images v. Stability AI, devant la Haute Cour britannique le 4 novembre dernier [3]. Getty, ayant reconnu un entraînement hors Royaume-Uni, a dû retirer en cours de procès son grief principal de droit d’auteur. Les autres demandes ont aussi été rejetées, hormis une atteinte très limitée aux marques liée aux filigranes.
[3] Getty Images v. Stability AI — Haute Cour d’Angleterre et du pays de Galles, 4 novembre 2025, [2025] EWHC 2863 (Ch), juge Joanna Smith. Présentée comme la première décision européenne en droit d’auteur sur l’IA, elle n’a pourtant pas répondu à la question centrale de l’entraînement contrefaisant, notamment pour des raisons de compétence.
La décision munichoise retire cette tranquillité aux entreprises. Indépendamment de l’entraînement américain, proposer le modèle et ses sorties en Allemagne a été reconnu comme une atteinte au droit allemand. C’est la première décision européenne considérant qu’un entraînement entièrement extérieur à l’UE peut engager la responsabilité allemande. Dans la deuxième affaire, le dispositif ordonne même à Suno de cesser la reproduction des œuvres sur le territoire américain pour entraîner son modèle musical.
La portée est donc considérable : entraîner dans des États-Unis moins réglementés puis fournir seulement le service en Europe n’est plus une stratégie suffisante, du moins en Allemagne.
Des angles morts demeurent. La compétence sur l’entraînement américain reposait sur le for spécial accordé aux sociétés de gestion comme GEMA par la loi VGG. Reste à savoir si un titulaire individuel pourrait obtenir la même réponse, comment déterminer le lieu de l’atteinte et, surtout, si le jugement allemand peut réellement être reconnu et exécuté aux États-Unis.
🧭 Pour conclure
Strictement parlant, ces décisions ne rémunèrent ni ne sanctionnent l’entraînement en soi : elles apprécient surtout si, après l’analyse, l’original demeure reproductible dans les paramètres du modèle.
À mon sens, puisqu’il est extrêmement difficile de calculer une rémunération ou un préjudice adéquats pour l’entraînement, le débat continuera probablement à se concentrer sur des critères plus vérifiables : les sorties et la reproduction.
Surtout, qu’est-ce que l’apprentissage de l’IA ? Lire des œuvres, ou l’ensemble de poids issu du processus ? En quoi ressemble-t-il à l’apprentissage humain, et en quoi en diffère-t-il ? À quel concept juridique existant faut-il le rattacher ?
Ces affaires ne sont pas terminées. OpenAI a fait appel, dénonçant une incompréhension du fonctionnement de l’IA, et la décision Suno n’est pas définitive. Elles pourraient aller devant les juridictions supérieures ou la Cour de justice de l’UE. Quant au résultat futur, sans doute tout le monde…
Le prochain article examinera les grandes affaires d’entraînement aux États-Unis, au cœur de l’industrie de l’IA.
#EntreTechnologieEtRègles #DroitAuteurIA #GEMA #OpenAI #TDM #IAGénérative