
De AI-basiswet uit het vorige artikel regelde de etikettering van gegenereerde inhoud: de output. Maar aan de andere kant van AI-geschillen ligt nog een front: de input.
Het is bekend dat AI-training enorme hoeveelheden gegevens vereist. Wie daarvoor betaald moet worden, hoe dat moet gebeuren en zelfs of betaling nodig is, staat echter nog niet vast.
Wanneer nieuwe juridische vragen ontstaan, wacht men vaak af wie als eerste in actie komt. In november 2025 kwam uit Duitsland een opvallend vonnis. Twee weken geleden, op 31 juli, volgde een tweede uitspraak in dezelfde richting. We bekijken beide zaken.
🇩🇪 Eerste vonnis — Reproductie die verder gaat dan leren
Weet u wat AI-agenten zoals ChatGPT tegenwoordig antwoorden als u naar de tekst van een bepaald lied vraagt?
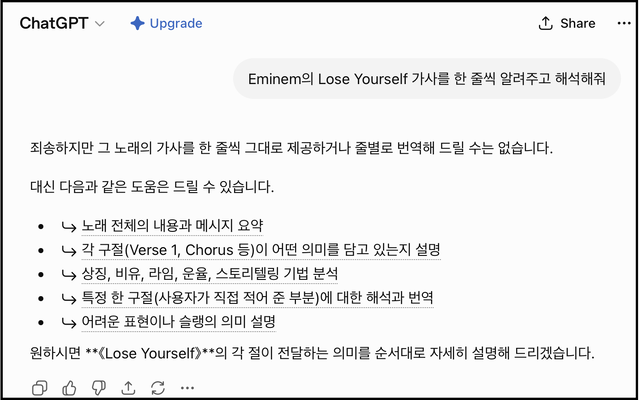
Zoals hierboven geeft ChatGPT de tekst niet rechtstreeks weer. Het eerste vonnis houdt verband met dat verschijnsel.
In een procedure van de Duitse muziekorganisatie GEMA tegen OpenAI oordeelde de rechtbank München I dat het zonder toestemming trainen op en letterlijk uitvoeren van liedteksten door ChatGPT het Duitse auteursrecht schond[1]. Het ging om negen bekende Duitse liedjes, waaronder Atemlos, Männer en Über den Wolken.
[1] GEMA v. OpenAI — Landgericht München I, 42e civiele kamer, 11 november 2025, zaak 42 O 14139/24. GEMA bestreed ongeoorloofde training en uitvoer van liedteksten door GPT-4 en GPT-4o.
OpenAI stelde dat het model geen specifieke gegevens opslaat, maar slechts statistische verbanden leert. De rechter accepteerde dat niet: eenvoudige prompts als “Wat is het refrein van dit lied?” leverden vrijwel de oorspronkelijke tekst op. Hij vergeleek dit met verliesgevende MP3-compressie. Ook zonder het hele origineel op te slaan, is herkenbare reconstructie uit statistische informatie reproductie. Er zijn drie kernpunten.
Even over die TDM-uitzondering. Text and Data Mining betekent werken automatisch analyseren om patronen, trends of verbanden te vinden. Omdat daarbij kopieën onvermijdelijk zijn, introduceerde Europa in de richtlijn auteursrecht in de digitale eengemaakte markt van 2019, 2019/790, uitzonderingen. Duitsland nam die over in artikel 44b van de auteurswet[2].
Artikel 44b staat reproductie toe, maar verlangt verwijdering zodra de kopieën niet meer nodig zijn voor mining. De uitzondering geldt tijdens de analyse, niet voor blijvend bezit daarna. Het AI-model bleef na training inhoud in zijn parameters bewaren en diensten leveren. Op dat punt wees de rechter de uitzondering af.
De rechter beval OpenAI de inbreuk te stoppen, gebruiksomvang en opbrengsten bekend te maken en schade te vergoeden. Bij overtreding geldt een dwangmiddel tot 250.000 euro per keer.
🇩🇪 Tweede vonnis — Van tekst naar melodie
Op 31 juli ging dezelfde kamer een stap verder. Ditmaal was AI-muziekdienst Suno de wederpartij[2].
[2] GEMA v. Suno — Landgericht München I, 42e civiele kamer, 31 juli 2026, zaak 42 O 763/25. GEMA begon de zaak in januari 2025. Verbod, informatieverstrekking en schadevergoeding werden grotendeels toegewezen. Het ging om zes werken: Atemlos durch die Nacht, Rasputin, Big in Japan, Forever Young, het refrein van Mambo No. 5 en Daddy Cool. Het vonnis is niet definitief.
GEMA bewees dat Suno’s uitkomsten in melodie, harmonie en ritme sterk overeenkwamen met de originelen. De rechtbank volgde dat. Het is feitelijk de eerste gepubliceerde uitspraak die AI-gegenereerde audio rechtstreeks behandelt. Waar de vorige zaak tekst betrof, ging het nu om muziek zelf.
Interessant was Suno’s verweer. Het had al erkend met GEMA-repertoire te trainen en betwistte alleen dat daarvoor betaald moest worden. Ook dat de trainingsgegevens via streamripping van YouTube waren gedownload, stond niet ter discussie.
De rechter wees dat duidelijk af en verwierp opnieuw de TDM-uitzondering. Suno had de werken niet alleen geanalyseerd, maar permanent in het model opgeslagen en als dienstfunctie gebruikt. Zo werd de beperkte uitleg uit het OpenAI-vonnis van acht maanden eerder doorgezet.
⚖️ En de rechtsmacht?
Nog een belangrijk punt is de plaats waar de training gebeurde.
Suno is Amerikaans en trainde in de VS. Dat was tot dusver een stevige verdedigingslinie voor AI-bedrijven: ook als de dienst in Europa beschikbaar is, vond de training buiten Europa plaats en zou Europees recht daarop niet van toepassing zijn.
Die redenering werkte eerder. In Getty Images v. Stability AI bij het Britse High Court van 4 november vorig jaar[3] erkende Getty dat training buiten het VK had plaatsgevonden. Het moest tijdens het proces zijn centrale auteursrechtelijke vordering intrekken. De overige argumenten werden afgewezen; alleen zeer beperkte merkinbreuk rond watermerken bleef over.
[3] Getty Images v. Stability AI — High Court van Engeland en Wales, 4 november 2025, [2025] EWHC 2863 (Ch), rechter Joanna Smith. Veelbesproken als eerste Europese AI-auteursrechtuitspraak, maar door rechtsmacht en andere kwesties bleef de kernvraag of AI-training inbreuk maakt onbeantwoord.
Door het Münchense vonnis kunnen bedrijven niet meer gerust zijn. Los van de Amerikaanse training achtte de Duitse rechter het aanbieden van het model en de uitvoer in Duitsland in strijd met Duits auteursrecht. Dit is de eerste Europese uitspraak waarin volledig buiten de EU uitgevoerde training Duitse aansprakelijkheid kan opleveren. In de tweede zaak beval de rechtbank Suno uitdrukkelijk reproductie van de werken op Amerikaans grondgebied voor training van muziek-AI te staken.
Dat maakt de betekenis veel groter: de strategie om in de minder streng gereguleerde VS te trainen en alleen de dienst in Europa aan te bieden, werkt in Duitsland niet meer.
Toch zijn niet alle gaten gedicht. De grondslag om ook de Amerikaanse training te beoordelen was een bijzondere bevoegdheidsregel in het Verwertungsgesellschaftengesetz, VGG, voor collectieve beheersorganisaties zoals GEMA. Of individuele rechthebbenden hetzelfde resultaat kunnen bereiken, hoe de plaats van inbreuk moet worden bepaald en vooral of het Duitse vonnis werkelijk in de VS kan worden erkend en uitgevoerd, blijft onzeker.
🧭 Tot slot
Strikt genomen legden deze vonnissen niet zozeer betaling of aansprakelijkheid op voor het leren zelf. Zij beoordeelden vooral of het origineel na training of analyse in reproduceerbare vorm in de modelparameters achterbleef.
Persoonlijk denk ik dat een juiste vergoeding of schade voor AI-training zo moeilijk te berekenen is, dat de discussie voorlopig zal blijven draaien om relatief duidelijke en controleerbare output en reproductie.
Maar wat is AI-leren precies? Het inlezen van werken zelf, of de verzameling gewichten die daarbij ontstaat? Hoeveel lijkt het op menselijk leren en hoeveel verschilt het ervan? Aan welke bestaande juridische begrippen moeten we het koppelen?
Beide zaken zijn nog niet voorbij. OpenAI ging in beroep en noemt het vonnis een misverstand over de werking van AI. Ook het Suno-vonnis is niet definitief, zodat hogere rechters of het Hof van Justitie van de EU, CJEU, zich nog kunnen uitspreken. Wat er uiteindelijk uitkomt, zal waarschijnlijk iedereen
In het volgende artikel bekijken we de belangrijkste Amerikaanse zaken over AI-training, in het hart van de AI-industrie.
#TussenTechnologieEnRegels #AIAuteursrecht #GEMA #OpenAI #TDM #GeneratieveAI