Er bestaat een beroep dat digitale begrafenisondernemer wordt genoemd.
Deze dienstverleners zoeken op internet naar teksten, foto’s en video’s die hun cliënten willen laten verwijderen en wissen die. Lukt dat niet, dan zorgen ze er ten minste voor dat de inhoud niet meer in zoekresultaten verschijnt. De verzoeken lopen uiteen van deepfake-montages tot een verleden dat men liever verborgen houdt. De prijs begint bij ongeveer 50.000 won per bericht. Maar doordat steeds meer websites verwijdering bemoeilijken, geldt tegenwoordig naar verluidt: ‘De prijs is wat men ervoor vraagt.’
We zijn het internet zozeer als een ‘plek van eeuwige vastlegging’ gaan zien dat verwijderen een beroep is geworden.
Maar het rapport ‘When Online Content Disappears’, dat het Pew Research Center in mei 2024 publiceerde, belichtte een onverwachte kant van internet: 38% van de webpagina’s die in 2013 bestonden, was tien jaar later niet meer bereikbaar.
Aan de ene kant betalen mensen anderen om inhoud te wissen, terwijl aan de andere kant vier van de tien pagina’s verdwijnen zonder dat iemand ze aanraakt. Hoe kan dat?
🧹 Het ontstaan van het ‘recht om vergeten te worden’
Op het huis van de Spaanse advocaat Mario Costeja González werd in 1998 beslag gelegd wegens socialezekerheidsschulden, waarna het ter veiling werd aangeboden. Het dagblad La Vanguardia publiceerde de aankondiging.
Costeja betaalde zijn schulden kort daarna af, maar nog ruim tien jaar later verscheen die aankondiging bovenaan als hij zijn naam op Google intypte. Daarom diende hij in 2010 bij de Spaanse privacytoezichthouder AEPD een klacht in tegen de krant en Google. De toezichthouder liet de krantenadvertentie staan, omdat die volgens de wet was gepubliceerd, maar droeg Google op de link uit de zoekresultaten te verwijderen.
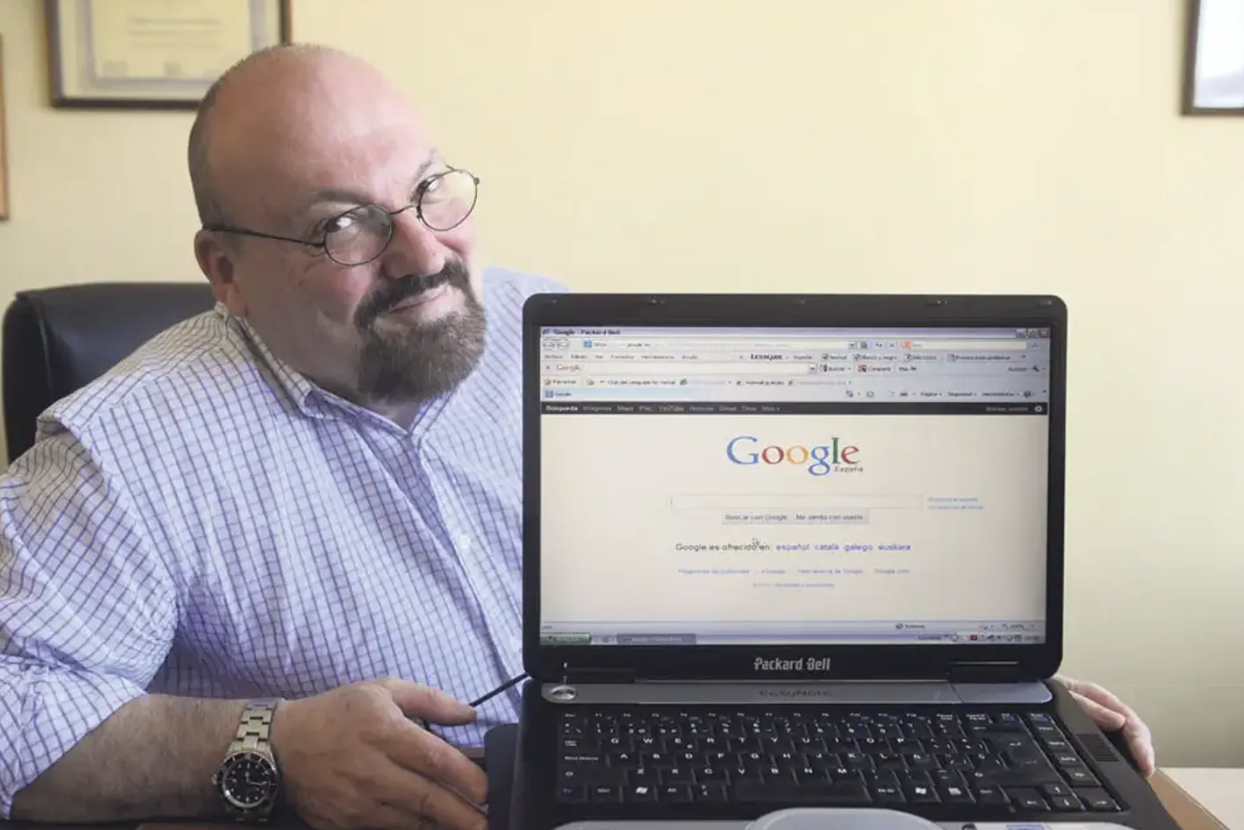
Google vocht het besluit aan bij de rechter. De Spaanse rechtbank oordeelde dat de kwestie afhing van de uitleg van EU-recht en vroeg het Hof van Justitie van de Europese Unie om een uitspraak. Op 13 mei 2014 bepaalde het Hof dat ook zoekmachines verplicht waren dergelijke zoekresultaten te verwijderen. Door dat arrest raakte de term ‘recht om vergeten te worden’ wereldwijd bekend[1].
[1] Google Spain SL, Google Inc. v. AEPD, Mario Costeja González — Hof van Justitie van de Europese Unie (HvJ-EU), Grote kamer, arrest van 13 mei 2014, zaak C-131/12. Het Hof beschouwde de zoekmachine-exploitant als verwerkingsverantwoordelijke voor persoonsgegevens en oordeelde dat verwijdering van ‘ontoereikende, niet langer relevante of bovenmatige’ zoekresultaten kan worden verlangd, ook als het oorspronkelijke artikel rechtmatig beschikbaar blijft. Artikel 17 van de Algemene verordening gegevensbescherming van de EU (AVG), die sinds 2018 geldt, legde dit wettelijk vast als het ‘recht op gegevenswissing (recht op vergetelheid)’.
Ook in Korea leefde dezelfde bezorgdheid. In juni 2016 voerde de Korea Communications Commission de ‘Richtsnoeren voor het recht om toegangsbeperking tot eigen internetberichten te verzoeken’ in, door de media het ‘Koreaanse recht om vergeten te worden’ genoemd. Deze vrijwillige regels maken het mogelijk om portalen en andere aanbieders te vragen eigen berichten voor anderen af te schermen wanneer men die niet meer zelf kan verwijderen.
Sinds april 2023 biedt de Personal Information Protection Commission ook de zogenoemde ‘gumdienst’ aan: een regeling die namens mensen verwijdering verzoekt van eigen berichten die zij als minderjarige hebben geplaatst.
Zo hebben we ons de afgelopen tien jaar afgevraagd: ‘Wat als het niet kan worden verwijderd?’ Bijna niemand vroeg zich af: ‘Wat als het niet bewaard blijft?’
📉 In tien jaar verdwijnt 38%
Het Pew Research Center selecteerde uit het non-profitwebarchief Common Crawl voor ieder jaar van 2013 tot en met 2023 willekeurig ongeveer 90.000 webpagina’s, in totaal bijna een miljoen. In oktober 2023 probeerde het vervolgens elk adres opnieuw te openen.
Wat bleek? In totaal kon 25% niet meer worden geopend. Hoe ouder de pagina’s, hoe groter het verlies: van de pagina’s die in 2013 bestonden was 38% ontoegankelijk, van de pagina’s uit 2021 na slechts twee jaar ongeveer 20%, en van die uit 2023 al 8%.
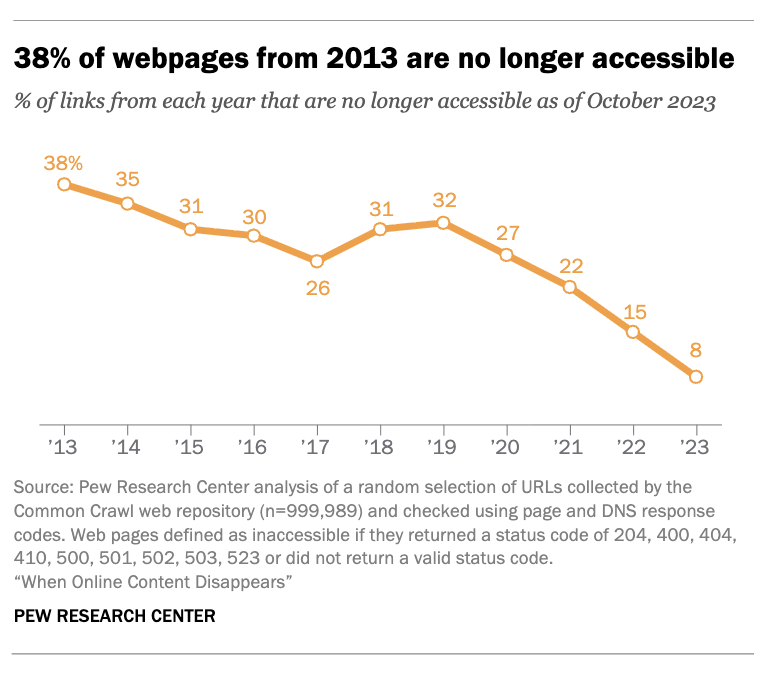
Dit is een voorzichtige schatting. Het Pew Research Center telde alleen fouten die duidelijk aangaven dat een server of pagina niet bestond als ‘niet toegankelijk’. Adressen waarvan de inhoud was veranderd en pagina’s die door een botblokkade niet konden worden geopend, werden allemaal als ‘toegankelijk’ geteld. Het aantal pagina’s dat niet meer goed op het oorspronkelijke adres kan worden geopend, zal dus hoger liggen.
🔨 Hoe pagina’s sterven
Pagina’s verdwijnen om uiteenlopende redenen. Soms verdwijnt het hele domein. Meestal gebeurt dat wanneer een bedrijf sluit of niemand meer de jaarlijkse domeinverlenging en serverkosten betaalt.
Binnen de genoemde 25% kwam het echter vaker voor dat alleen een pagina verdween van een website die nog gewoon een eigenaar had (16%) dan dat pagina’s om die eerdere redenen verdwenen (9%). Dat gebeurt meestal wanneer de eigenaar de website aanpast.
Wanneer een website opnieuw wordt ingericht of de forumsoftware wordt vervangen, kan de adresstructuur veranderen, ook als alle berichten ongewijzigd worden overgezet. Als men dan vergeet een doorverwijzing van oude naar nieuwe adressen in te stellen, breken alle links die elders naar de website verwijzen. Voor de partij die de vernieuwing uitvoert, heeft die instelling vaak veel minder prioriteit dan het lanceren van de nieuwe site.
Pagina’s verdwijnen ook door het opruimen van diensten, zonder dat er sprake is van een herontwerp. Google beheerde sinds 2009 de linkverkorter goo.gl, die lange webadressen bijvoorbeeld omzet in goo.gl/ABC12x. In juli 2024 kondigde Google aan vanaf 25 augustus van het volgende jaar alle links uit te schakelen. De reden was dat 99% van de links gedurende heel juni 2024 geen enkele activiteit had vertoond.
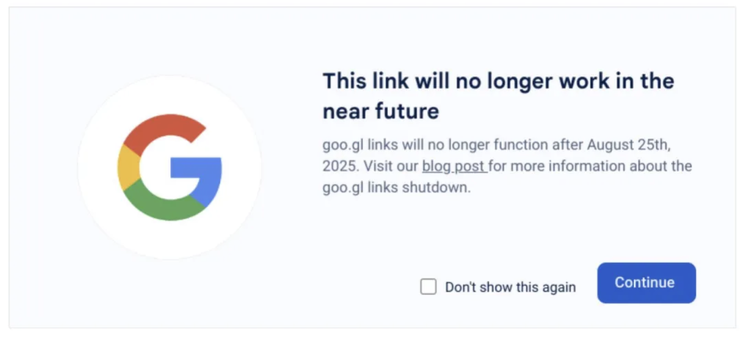
Toen protest ontstond over wat er moest gebeuren met links die overal in documenten, video’s en berichten waren opgenomen, wijzigde Google zijn beleid ruim drie weken voor de sluiting: ‘Sommige links blijven bestaan.’ Alleen links waarop eind 2024 niemand had geklikt, zouden worden uitgeschakeld. Daarom werkt het domein goo.gl nog altijd en verwijzen de overgebleven links naar de oorspronkelijke pagina. De overige links zijn echter verbroken en tonen alleen een foutmelding.
Kortom, webpagina’s verdwijnen vaak niet omdat iemand ze bewust wil wissen, maar tijdens het vernieuwen van websites en het verlagen van kosten.
🏚️ Een bibliotheek met alleen nog adressen
Jonathan Zittrain van Harvard Law School vergeleek het web in zijn artikel ‘The Internet Is Rotting’ uit 2021 in The Atlantic met een ‘systeem zonder bibliotheek, waarin iedereen boeken thuis bewaart en alleen de adressen deelt’. Wie in 2021 naar een adres gaat dat in 2015 is geregistreerd, hoeft er dus niet van op te kijken als het boek er niet meer is.
Dat komt door de manier waarop internet is ontstaan. De wetenschappers die het ontwierpen, hadden niet het geld om zelf één enorm netwerk aan te leggen, zoals een telefoon- of bezorgnetwerk. Ze waren ook niet van plan er geld mee te verdienen. Daarom stelden ze alleen regels op om bestaande netwerken met elkaar te verbinden. Het internet kreeg daardoor geen exploitatiebedrijf en geen beheerorganisatie. Ook Tim Berners-Lee, die daarop het web bouwde, stelde de protocollen gratis beschikbaar.
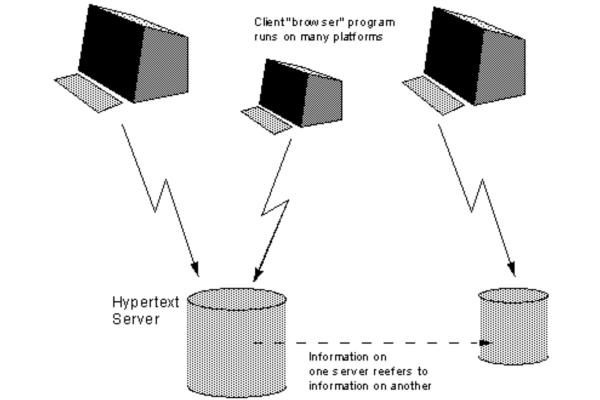
Er werden geen tarieven gerekend, dus er was geen bedrijf nodig dat bijhield wie wat gebruikte, en evenmin een centraal punt met overzicht over het hele web. Een link was niets meer dan het noteren van het adres van een andere pagina en kon dus naar een server overal ter wereld verwijzen. Maar de eigenaar van die server wist niet eens wie naar zijn pagina linkte.
Berners-Lee was zich daarvan bewust en drong er in zijn tekst ‘Cool URIs don’t change’ uit 1998 op aan adressen niet te wijzigen. Hij bouwde echter geen mechanisme in om adreswijzigingen tegen te houden.
Er waren wel degelijk andere ontwerpen. Xanadu, dat Ted Nelson tientallen jaren vóór het web bedacht, voorzag zelfs in ‘tweerichtingslinks’, waarbij ook de gelinkte partij over de link werd geïnformeerd. Het doel was dus vanaf het begin links te maken die niet zouden breken.
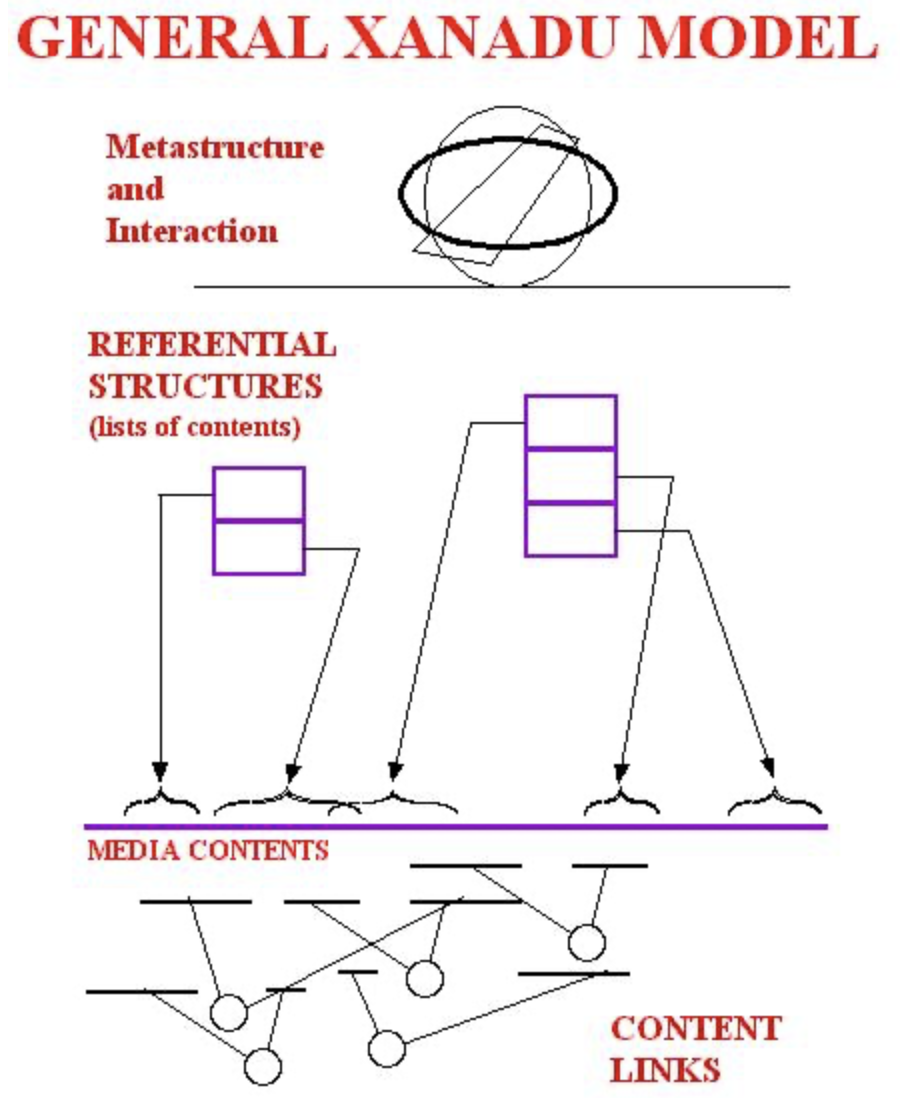
Maar doordat Xanadu vanaf het begin ook versiebeheer en de afrekening van auteursrechtvergoedingen volledig wilde regelen, was het zelfs tientallen jaren later nog niet goed af. Nelson bekritiseerde later dat het web hypertekst had gedegradeerd met ‘eenrichtingslinks die voortdurend breken’. Toch was het het onvolmaakte maar werkende web dat overeind bleef.
Zittrain noemt deze ontwerpbenadering van internet en het web het ‘uitstelprincipe (Procrastination Principle)’. In plaats van het ontwerp zwaar te maken door vooraf alle mogelijke toekomstige problemen op te lossen, worden problemen aangepakt wanneer ze zich voordoen. Dat websites ontstaan en verdwijnen en pagina’s verhuizen, was daarom geen gebrek maar een bedoeld kenmerk.
🫥 Een leemte in verantwoordelijkheid
Het uitstelprincipe werkte. Het web, waarvoor toestemming noch een beheerder nodig was, groeide sneller dan welk ander netwerk ook. De prijs was echter een ‘leemte in de verantwoordelijkheid om inhoud te onderhouden waarop anderen vertrouwen’. Iedere huiseigenaar hoeft immers alleen op zijn eigen boeken te letten, en niemand is verplicht te voorkomen dat de boeken in andermans huis verdwijnen.
Die leemte valt normaal niet op, maar wordt zichtbaar zodra een beheerder ermee ophoudt. Paramount hief in mei 2023 de afdeling MTV News op en haalde ruim een jaar later, in juni 2024, ook de website offline. Alle artikeladressen die sinds 1996 waren opgebouwd, verwezen van de ene op de andere dag alleen nog naar de MTV-homepage. Paramount verklaarde dat de artikelen intern bewaard werden, maar van buitenaf waren ze niet meer toegankelijk.
In januari van hetzelfde jaar maakte ook de nieuwsstart-up The Messenger, die al acht maanden na de oprichting ophield, zijn website leeg binnen enkele uren na de aankondiging van de sluiting. Alleen de naam en een e-mailadres bleven over.
Opmerkelijk genoeg doen nieuwsorganisaties niet bijzonder veel moeite om hun artikelen te bewaren. Toen het Tow Center van Columbia University in 2019 onderzoek deed bij 21 nieuwsorganisaties, bleken er 19 geen enkele maatregel te nemen om hun eigen webartikelen te behouden. Ze hadden niet alleen geen schriftelijk bewaarbeleid, maar zelfs geen informele werkwijze. Feitelijk lieten ze dit werk over aan externe organisaties zoals het Internet Archive of Google. Voor media die steeds achter ‘wat er nu gebeurt’ aan zitten, kwam het bewaren van reeds gepubliceerde artikelen op de tweede plaats.
Vroeger zouden bibliotheken deze leemte hebben gevuld. Maar toen publicaties digitaal werden, gingen ook bibliotheken in plaats van tijdschriften en e-boeken te bezitten alleen nog het recht kopen om ze gedurende een bepaalde periode in te zien. Zodra het abonnement stopt, zijn ook de eerder ontvangen publicaties niet meer toegankelijk. Zelfs bibliotheken hebben zo als het ware alleen nog huisadressen in plaats van boeken.
🧾 Bewaren kost geld
Onderzoeker op het gebied van digitale bewaring David Rosenthal begon in 1998 bij Stanford Libraries het bewaarprogramma LOCKSS en leidde het tot zijn pensionering in 2017. LOCKSS staat voor ‘Lots Of Copies Keep Stuff Safe’: veel kopieën houden materiaal veilig. Verschillende bibliotheken moesten zelf kopieën van elektronische tijdschriften bewaren. Het was een poging bibliotheken weer boeken te geven in plaats van alleen adressen.
Na het verschijnen van het Pew-rapport uitte Rosenthal enkele punten van kritiek. Een daarvan was dat het Pew Research Center niet had gecontroleerd of van de ontoegankelijke pagina’s nog kopieën in webarchieven bestonden. Niet te openen is immers iets anders dan verdwenen. Toen het Internet Archive in april 2026 de adressen van het Pew Research Center vergeleek met zijn Wayback Machine, daalde het aandeel ‘niet te openen pagina’s’ door ook daar te zoeken van ongeveer één op vier naar ongeveer één op tien.
Maar kopieën ontstaan niet vanzelf. Rosenthal benadrukt al ruim twintig jaar dat niet technologie maar geld de grootste bedreiging voor digitale bewaring vormt. Geen geld hebben om iets te bewaren is een veel grotere bedreiging dan beschadigde of verouderde bestanden. In 2017 schatte hij dat er wereldwijd jaarlijks minder dan 30 miljoen dollar werd uitgegeven aan het archiveren van het web, terwijl de productie van die inhoud honderden miljarden dollars had gekost. Zijn waarschuwing luidt dat op deze manier meer dan de helft van wat toekomstige lezers zouden moeten kunnen zien, niet bewaard zal blijven.
Volgens Rosenthals vuistregel gaat de helft van de kosten van digitale bewaring naar de eerste opname van het materiaal. Een derde gaat naar opslag en het resterende zesde naar het beschikbaar stellen voor inzage. Wat verdwenen is, kan niet meer worden opgenomen. Wat bewaard blijft, hangt dus uiteindelijk af van wie die eerste kosten betaalt zolang de pagina nog bestaat.
Hoe worden de gegevens die nu op het web staan dan beheerd? En hoeveel moeite moeten we doen om ze te bewaren?
In het volgende deel bekijken we welke gaten verdwenen pagina’s in onze kennis slaan en welke inspanningen worden geleverd om dat verdwijnen tegen te gaan.
#TussenTechnologieEnRegels #Linkrot #DigitaalVerdwijnen #RechtOmVergetenTeWorden #PewResearch #Archief