Es gibt einen Beruf, der als digitaler Bestatter bezeichnet wird.
Diese Dienstleister suchen im Internet nach Texten, Fotos und Videos, die ihre Auftraggeber entfernen lassen möchten, und löschen sie. Gelingt das nicht, sorgen sie zumindest dafür, dass die Inhalte nicht mehr in Suchergebnissen erscheinen. Die Anfragen reichen von Deepfake-Montagen bis zu einer Vergangenheit, die man lieber verbergen möchte. Die Preise beginnen bei etwa 50.000 Won pro Beitrag. Weil jedoch immer mehr Websites eine Löschung erschweren, heißt es inzwischen: „Der Preis ist, was der Anbieter verlangt.“
Wir haben das Internet so sehr als einen „Ort ewiger Konservierung“ betrachtet, dass das Löschen zu einem Beruf geworden ist.
Der im Mai 2024 veröffentlichte Bericht „When Online Content Disappears“ des Pew Research Center beleuchtete jedoch eine unerwartete Seite des Internets: 38 % der Webseiten, die 2013 existierten, waren zehn Jahre später nicht mehr erreichbar.
Auf der einen Seite bezahlt man Menschen dafür, Inhalte zu löschen, während auf der anderen vier von zehn Seiten verschwinden, ohne dass jemand sie anfasst. Wie lässt sich das erklären?
🧹 Die Geburt des „Rechts auf Vergessenwerden“
Das Haus des spanischen Rechtsanwalts Mario Costeja González wurde 1998 wegen Sozialversicherungsschulden gepfändet und zur Versteigerung angeboten. Die Tageszeitung La Vanguardia veröffentlichte die entsprechende Bekanntmachung.
Costeja beglich die Schulden zwar bald darauf. Doch noch über zehn Jahre später erschien diese Bekanntmachung ganz oben, wenn er seinen Namen bei Google eingab. Deshalb legte er 2010 bei der spanischen Datenschutzbehörde AEPD Beschwerde gegen die Zeitung und Google ein. Die Behörde ließ die Zeitungsbekanntmachung bestehen, weil sie gesetzmäßig veröffentlicht worden war, ordnete Google jedoch an, den Link aus den Suchergebnissen zu entfernen.
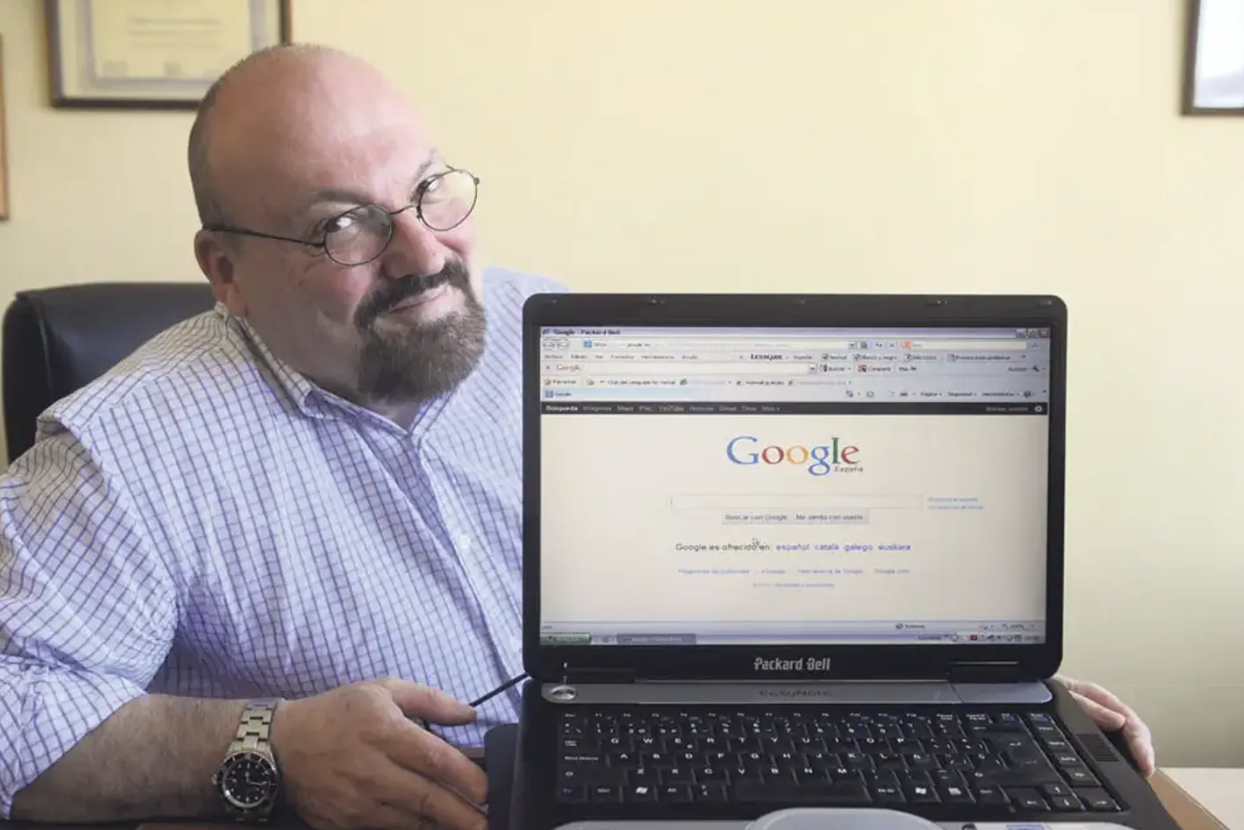
Google focht diese Entscheidung gerichtlich an. Das spanische Gericht sah die Auslegung des EU-Rechts als entscheidend an und ersuchte den Gerichtshof der Europäischen Union um eine Entscheidung. Am 13. Mai 2014 urteilte dieser, dass auch Suchmaschinen zur Entfernung solcher Suchergebnisse verpflichtet seien. Durch dieses Urteil verbreitete sich der Ausdruck „Recht auf Vergessenwerden“ weltweit[1].
[1] Google Spain SL, Google Inc. v. AEPD, Mario Costeja González — Gerichtshof der Europäischen Union (EuGH), Große Kammer, Urteil vom 13. Mai 2014, Rechtssache C-131/12. Das Gericht betrachtete den Suchmaschinenbetreiber als Verantwortlichen für die Verarbeitung personenbezogener Daten und entschied, dass die Entfernung „unangemessener, nicht mehr relevanter oder übermäßiger“ Suchergebnisse verlangt werden kann, selbst wenn der ursprüngliche Artikel rechtmäßig bestehen bleibt. Artikel 17 der seit 2018 geltenden Datenschutz-Grundverordnung der EU (DSGVO) verankerte dies als „Recht auf Löschung (Recht auf Vergessenwerden)“ im Gesetz.
Auch in Korea bestand ein ähnliches Problembewusstsein. Im Juni 2016 setzte die Korea Communications Commission die „Leitlinien zum Recht, die Zugangsbeschränkung für eigene Internetbeiträge zu verlangen“ in Kraft, die Medien als „koreanische Version des Rechts auf Vergessenwerden“ bezeichneten. Diese freiwilligen Regeln ermöglichen es, Portalbetreiber und andere Anbieter darum zu bitten, eigene Beiträge für andere unsichtbar zu machen, wenn man sie nicht mehr selbst löschen kann.
Seit April 2023 betreibt die Personal Information Protection Commission außerdem den sogenannten „Radiergummi-Dienst“, der stellvertretend die Löschung eigener Beiträge beantragt, die man als Minderjähriger veröffentlicht hat.
So haben wir uns in den vergangenen zehn Jahren gefragt: „Was, wenn es sich nicht löschen lässt?“ Kaum jemand fragte sich: „Was, wenn nichts davon erhalten bleibt?“
📉 In zehn Jahren verschwinden 38 %
Das Pew Research Center wählte aus dem gemeinnützigen Webarchiv Common Crawl für jedes Jahr von 2013 bis 2023 zufällig rund 90.000 Webseiten aus, insgesamt fast eine Million. Im Oktober 2023 rief es anschließend jede dieser Adressen erneut auf.
Was kam dabei heraus? 25 % aller Seiten ließen sich nicht öffnen. Je älter die Seiten, desto mehr waren verschwunden: Von den 2013 vorhandenen Seiten waren 38 % nicht erreichbar, von den Seiten aus dem Jahr 2021 nach nur zwei Jahren etwa 20 % und von den Seiten aus dem Jahr 2023 bereits 8 %.
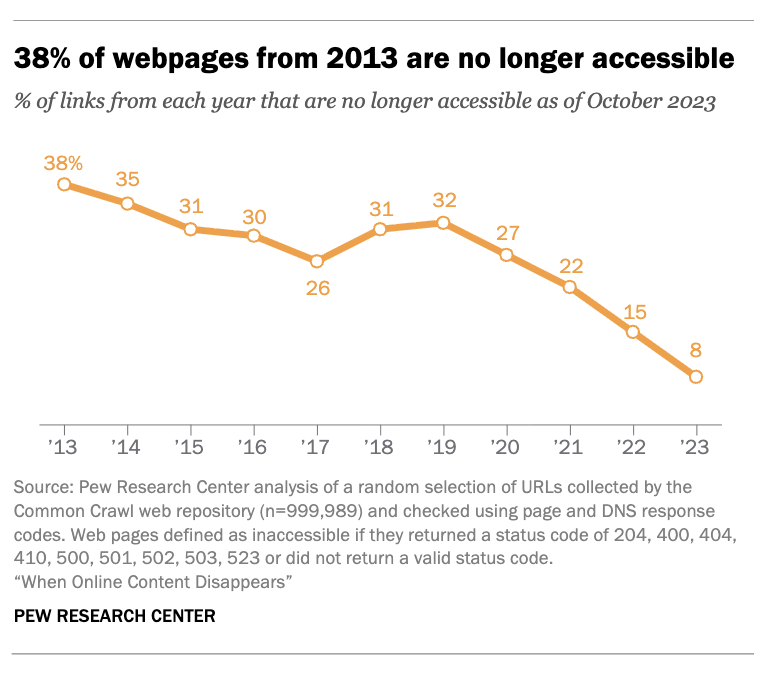
Diese Zahlen sind konservativ angesetzt. Das Pew Research Center zählte nur Fehler, die eindeutig auf einen nicht vorhandenen Server oder eine nicht vorhandene Seite hinwiesen, als „nicht erreichbar“. Adressen, deren Inhalte sich geändert hatten, sowie Seiten, die wegen einer Bot-Sperre nicht geöffnet werden konnten, wurden hingegen sämtlich als „erreichbar“ gezählt. Die Zahl der Seiten, die sich unter ihrer ursprünglichen Adresse nicht mehr ordnungsgemäß öffnen lassen, dürfte also höher liegen.
🔨 Wie Webseiten sterben
Webseiten verschwinden aus unterschiedlichen Gründen. Manchmal verschwindet gleich die gesamte Domain. Meist schließt dann ein Unternehmen, oder niemand bezahlt mehr die jährlich anfallenden Domainverlängerungs- und Serverkosten.
Unter den genannten 25 % gab es jedoch mehr Fälle, in denen nur die Seite auf einer ansonsten weiterbetriebenen Website verschwand (16 %), als Seiten, die aus diesen Gründen verschwanden (9 %). Das geschieht meist, wenn die Betreiber ihre Website überarbeiten.
Wird eine Website neu gestaltet oder die Forensoftware ausgetauscht, kann sich die Adressstruktur ändern, selbst wenn die Beiträge unverändert übernommen werden. Vergisst man dann die Weiterleitung von den alten auf die neuen Adressen, brechen sämtliche von außen gesetzten Links ab. Für die mit der Überarbeitung Beauftragten hat diese Einstellung oft eine deutlich geringere Priorität als der Start der neuen Website.
Seiten verschwinden auch durch das Einstellen von Diensten statt durch einen Umbau. Google betrieb seit 2009 den Kurzlinkdienst goo.gl, der lange Webadressen beispielsweise in goo.gl/ABC12x umwandelte. Im Juli 2024 kündigte Google dann an, ab dem 25. August des folgenden Jahres sämtliche Links abzuschalten. Als Begründung hieß es, dass bei 99 % der Links im gesamten Juni 2024 keinerlei Aktivität verzeichnet worden sei.
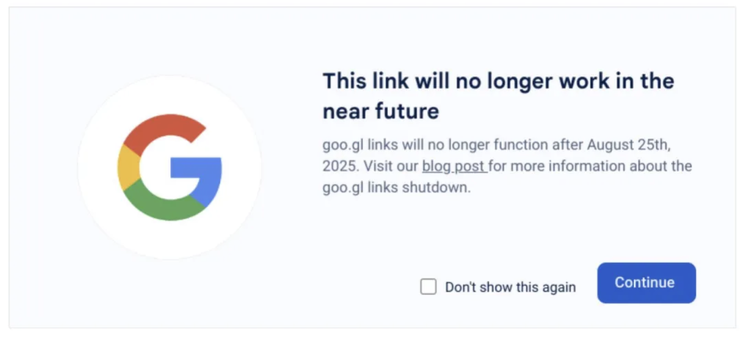
Als Kritik laut wurde, was mit den überall in Dokumenten, Videos und Beiträgen eingebetteten Links geschehen solle, änderte Google seine Entscheidung gut drei Wochen vor dem Abschalttermin: „Einige Links sollen erhalten bleiben.“ Nur Links, die Ende 2024 niemand angeklickt hatte, sollten abgeschaltet werden. Deshalb funktioniert die Domain goo.gl weiterhin, und die erhaltenen Links führen zur ursprünglichen Seite. Die übrigen sind jedoch unterbrochen und zeigen nur noch eine Fehlerseite.
Zusammengefasst verschwinden Webseiten häufig nicht, weil jemand sie gezielt löschen möchte, sondern im Zuge von Websiteüberarbeitungen und Kostensenkungen.
🏚️ Eine Bibliothek, der nur Adressen geblieben sind
Jonathan Zittrain von der Harvard Law School verglich das Web in seinem 2021 in The Atlantic erschienenen Artikel „The Internet Is Rotting“ mit einem „System ohne Bibliothek, in dem jeder seine Bücher zu Hause aufbewahrt und nur die Adressen teilt“. Wenn man 2021 eine 2015 eingetragene Adresse aufsuche, sei es demnach nicht überraschend, wenn das Buch nicht mehr da sei.
Der Grund liegt darin, wie das Internet entstand. Die Wissenschaftler, die es entwarfen, hatten weder das Geld, selbst ein einziges riesiges Netz wie ein Telefon- oder Zustellnetz aufzubauen, noch die Absicht, damit Geld zu verdienen. Sie legten daher lediglich Regeln fest, um bereits vorhandene Netzwerke miteinander zu verbinden. So erhielt das Internet weder eine Betreibergesellschaft noch eine Verwaltungsorganisation. Auch Tim Berners-Lee, der darauf das Web aufbaute, stellte dessen Protokolle kostenlos zur Verfügung.
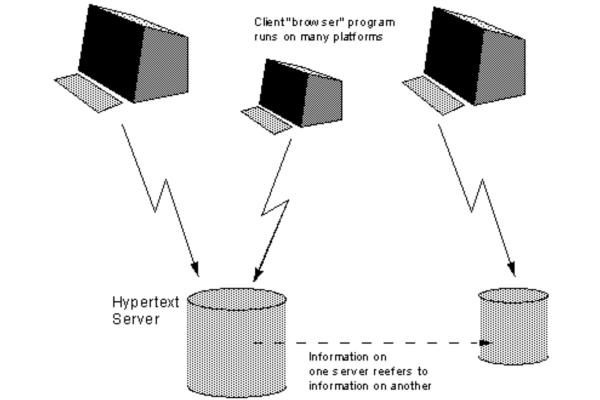
Weil keine Gebühren erhoben wurden, brauchte es weder ein Unternehmen, das festhielt, wer was nutzte, noch eine Zentrale mit Überblick über das gesamte Web. Ein Link bestand lediglich darin, die Adresse einer anderen Seite anzugeben. Er konnte daher auf einen Server irgendwo auf der Welt verweisen, doch dessen Betreiber wusste nicht einmal, wer auf seine Seite verlinkte.
Berners-Lee war sich dessen bewusst und mahnte 1998 in seinem Text „Cool URIs don’t change“ dazu, Adressen nicht zu ändern. Einen Mechanismus, der Adressänderungen verhindern würde, baute er jedoch nicht ein.
Andere Entwürfe gab es durchaus. Xanadu, das Ted Nelson Jahrzehnte vor dem Web konzipierte, sah sogar „bidirektionale Links“ vor, bei denen auch die verlinkte Seite über die Verknüpfung informiert wird. Von Anfang an sollten also Links entstehen, die nicht abbrechen.
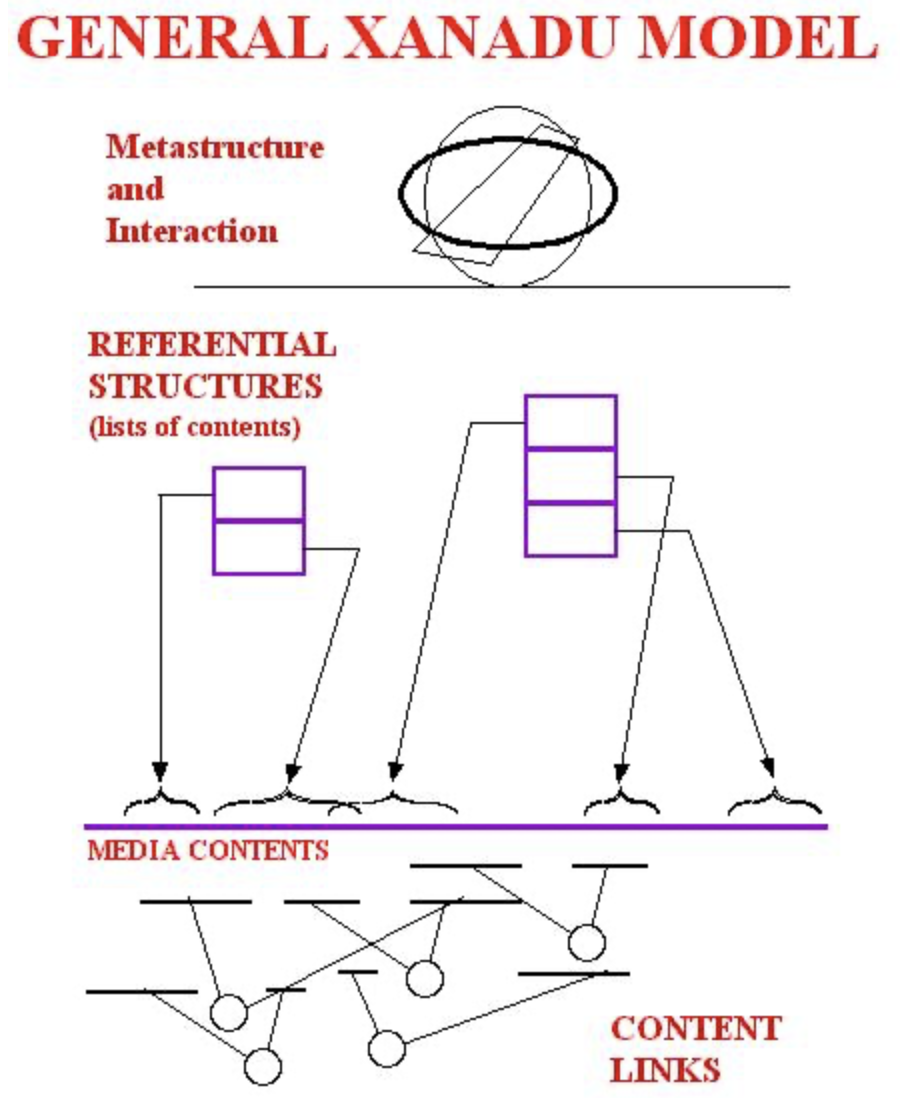
Weil Xanadu jedoch von Beginn an auch Versionsverwaltung und die Abrechnung von Urheberrechtsvergütungen vollständig berücksichtigen wollte, wurde es selbst nach Jahrzehnten nicht richtig fertiggestellt. Nelson kritisierte später, das Web habe Hypertext mit seinen „einseitigen, ständig abbrechenden Links“ entwertet. Durchgesetzt hat sich jedoch das Web, das trotz seiner Unvollkommenheit zunächst einmal funktionierte.
Zittrain bezeichnet diese Entwurfshaltung von Internet und Web als „Aufschiebeprinzip (Procrastination Principle)“. Statt den Entwurf mit vorweggenommenen Lösungen für alle möglicherweise auftretenden Probleme zu überladen, werden Probleme erst gelöst, wenn sie auftreten. Dass Websites entstehen und verschwinden und Seiten ihren Standort wechseln, war daher kein Fehler, sondern ein beabsichtigtes Merkmal.
🫥 Eine Lücke in der Verantwortung
Das Aufschiebeprinzip war erfolgreich. Das Web, das weder Erlaubnis noch einen Verwalter benötigte, wuchs schneller als jedes andere Netzwerk. Der Preis dafür war jedoch eine „Lücke in der Verantwortung, Inhalte zu erhalten, auf die andere angewiesen sind“. Jeder Hausbesitzer braucht sich nur um seine eigenen Bücher zu kümmern, und niemand ist verpflichtet, das Verschwinden der Bücher in fremden Häusern zu verhindern.
Diese Lücke fällt gewöhnlich nicht auf, zeigt sich aber, sobald die Betreiber die Betreuung einstellen. Paramount löste im Mai 2023 die Abteilung MTV News auf und nahm gut ein Jahr später, im Juni 2024, auch deren Website vom Netz. Sämtliche seit 1996 angesammelten Artikeladressen führten über Nacht nur noch auf die MTV-Startseite. Paramount erklärte zwar, die Artikel intern aufzubewahren, von außen waren sie jedoch nicht mehr zugänglich.
Im Januar desselben Jahres leerte auch das Nachrichten-Start-up The Messenger, das bereits acht Monate nach seinem Start schloss, seine Website nur wenige Stunden nach Bekanntgabe der Einstellung. Übrig blieben lediglich der Name und eine E-Mail-Adresse.
Überraschenderweise investieren Medienunternehmen nicht besonders viel Aufwand darin, ihre Artikel zu bewahren. Eine Untersuchung des Tow Center der Columbia University aus dem Jahr 2019 unter 21 Nachrichtenorganisationen ergab, dass 19 keinerlei Maßnahmen zur Erhaltung ihrer Webartikel trafen. Es gab weder schriftliche Archivierungsrichtlinien noch auch nur informelle Praktiken. Faktisch überließen sie diese Arbeit externen Einrichtungen wie dem Internet Archive oder Google. Für Medien, die stets den „neuesten Ereignissen“ folgen, stand die Erhaltung bereits veröffentlichter Artikel hinten an.
Früher hätten Bibliotheken diese Lücke gefüllt. Mit der Digitalisierung des Verlagswesens kauften jedoch auch sie anstelle von Zeitschriften und E-Books nur noch zeitlich begrenzte Zugangsrechte. Endet das Abonnement, lassen sich selbst die zuvor bezogenen Inhalte nicht mehr öffnen. Damit besitzen sogar Bibliotheken gewissermaßen nur noch Hausadressen statt Bücher.
🧾 Erhalten kostet Geld
Der Forscher für digitale Langzeitarchivierung David Rosenthal startete 1998 an den Stanford Libraries das Archivierungsprogramm LOCKSS und leitete es bis zu seinem Ruhestand 2017. LOCKSS steht für „Lots Of Copies Keep Stuff Safe“, also: Viele Kopien sorgen für Sicherheit. Verschiedene Bibliotheken sollten selbst Kopien elektronischer Zeitschriften aufbewahren — ein Versuch, ihnen wieder Bücher statt bloßer Adressen zu geben.
Nach dem Erscheinen des Pew-Berichts äußerte Rosenthal mehrere Kritikpunkte. Einer davon war, dass das Pew Research Center nicht geprüft hatte, ob von den nicht erreichbaren Seiten noch Kopien in Webarchiven existierten. Nicht erreichbar und verschwunden sind schließlich zwei verschiedene Dinge. Tatsächlich verglich das Internet Archive im April 2026 die Adressen des Pew Research Center mit seiner Wayback Machine. Durch die zusätzliche Suche dort sank der Anteil der „nicht erreichbaren Seiten“ von etwa einem Viertel auf rund ein Zehntel.
Aber Kopien entstehen nicht von allein. Seit über zwanzig Jahren betont Rosenthal, dass die größte Gefahr für die digitale Erhaltung nicht die Technik, sondern das Geld ist. Fehlendes Geld für die Bewahrung stellt eine weit größere Bedrohung dar als beschädigte oder veraltete Dateien. 2017 schätzte er die weltweiten Ausgaben für die Webarchivierung auf weniger als 30 Millionen Dollar im Jahr — obwohl die Herstellung dieser Inhalte Hunderte Milliarden Dollar gekostet hatte. Seine Warnung lautet: Geht es so weiter, wird mehr als die Hälfte dessen, was künftigen Lesern zugänglich sein sollte, nicht erhalten bleiben.
Nach Rosenthals Faustregel entfällt die Hälfte der Kosten digitaler Erhaltung auf die anfängliche Erfassung. Ein Drittel geht auf die Speicherung und das verbleibende Sechstel auf die Bereitstellung für die Nutzung. Was einmal verschwunden ist, lässt sich nicht mehr erfassen. Was erhalten bleibt, hängt daher letztlich davon ab, wer diese ersten Kosten übernimmt, solange die Seite noch existiert.
Wie werden also die Aufzeichnungen verwaltet, die sich heute im Web befinden? Und wie viel Aufwand sollten wir für ihre Erhaltung betreiben?
Im nächsten Teil untersuchen wir, welche Lücken verschwundene Seiten im Wissen hinterlassen und welche Anstrengungen gegen dieses Verschwinden unternommen werden.
#ZwischenTechnikUndRegeln #Linkverfall #DigitalesVerschwinden #RechtAufVergessenwerden #PewResearch #Aufzeichnungen