Existe una profesión llamada «sepulturero digital».
Cuando un cliente les pide que eliminen textos, fotografías y vídeos, estos profesionales los localizan en internet y los borran; si no pueden, al menos intentan que dejen de aparecer en las búsquedas. Las solicitudes abarcan desde montajes deepfake hasta un pasado que se quiere ocultar. Los precios parten de unos 50.000 wones por publicación, pero, a medida que aumentan los sitios de los que resulta difícil borrar contenido, se dice que hoy «el precio es el que pidan».
Hemos creído que internet es un «espacio de exposición permanente», hasta el punto de que borrar se ha convertido en una profesión.
Sin embargo, el informe «When Online Content Disappears», publicado por el Pew Research Center en mayo de 2024, señaló una faceta inesperada de internet: el 38 % de las páginas web que existían en 2013 ya no podían abrirse diez años después.
Por un lado, se paga a alguien para que borre contenido; por otro, cuatro de cada diez páginas desaparecen sin que nadie las toque. ¿Cómo se explica?
🧹 El nacimiento del «derecho al olvido»
En 1998, la vivienda del abogado español Mario Costeja González fue embargada y sacada a subasta por deudas con la Seguridad Social, y el diario La Vanguardia publicó el anuncio.
Costeja saldó la deuda poco después, pero durante más de diez años, al buscar su nombre en Google, aquel anuncio aparecía en los primeros resultados. En 2010 presentó una reclamación ante la Agencia Española de Protección de Datos (AEPD) contra el periódico y Google. La Agencia mantuvo el anuncio del periódico porque se había publicado conforme a la ley, pero ordenó a Google eliminar el enlace de sus resultados de búsqueda.
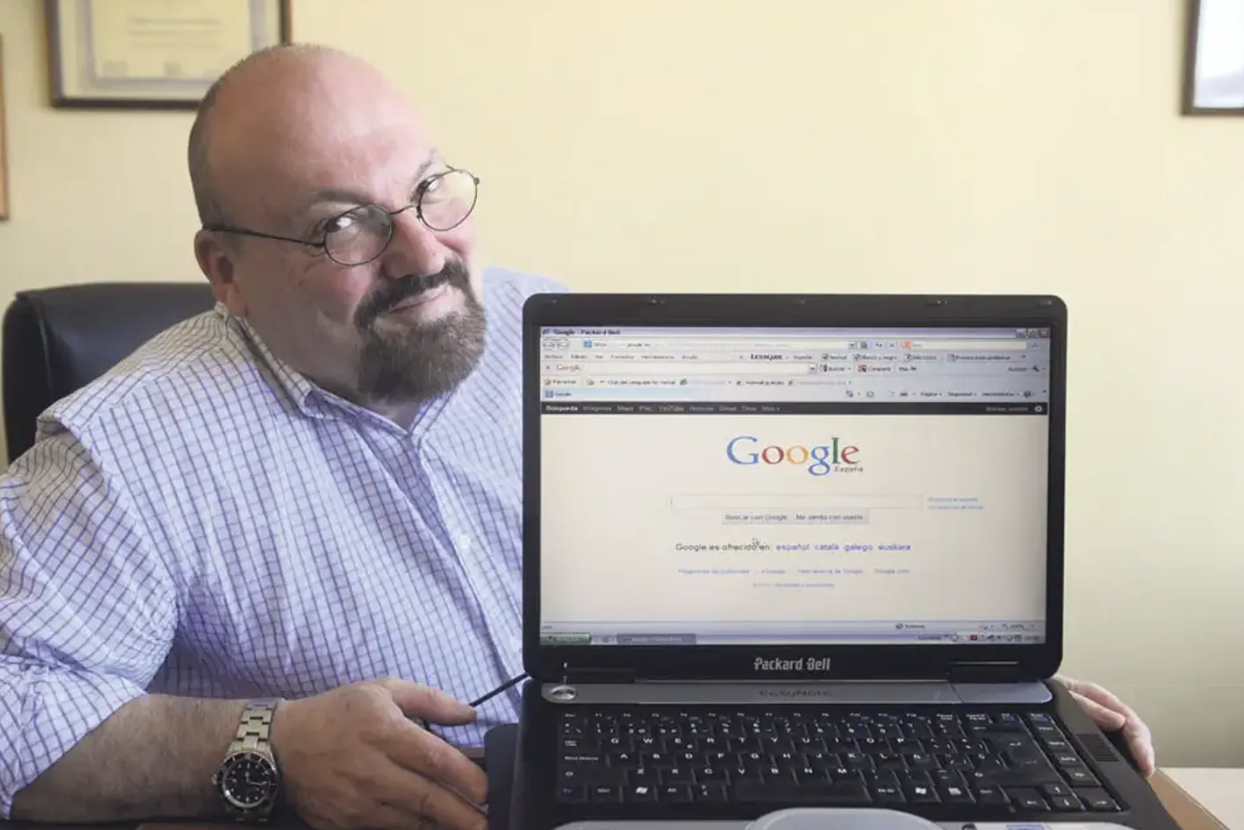
Google recurrió la decisión y el tribunal español, al considerar que la cuestión dependía de la interpretación del Derecho de la UE, solicitó un pronunciamiento al Tribunal de Justicia de la Unión Europea. El 13 de mayo de 2014, este declaró que los motores de búsqueda también tenían la obligación de eliminar este tipo de resultados. Con aquella sentencia, la expresión «derecho al olvido» se extendió por todo el mundo[1].
[1] Google Spain SL, Google Inc. v. AEPD, Mario Costeja González — Tribunal de Justicia de la Unión Europea (TJUE), Gran Sala, sentencia de 13 de mayo de 2014, asunto C-131/12. El Tribunal consideró al operador del motor de búsqueda responsable del tratamiento de datos personales y declaró que podía exigirse la supresión de resultados «inadecuados, ya no pertinentes o excesivos», aunque el artículo original siguiera publicado legalmente. El artículo 17 del Reglamento General de Protección de Datos de la UE (RGPD), aplicable desde 2018, lo recogió como «derecho de supresión (derecho al olvido)».
Corea compartía esta misma preocupación. En junio de 2016, la Comisión de Comunicaciones de Corea puso en vigor las «Directrices sobre el derecho a solicitar la exclusión del acceso a las publicaciones propias en internet», que la prensa denominó la «versión coreana del derecho al olvido». Son unas normas de autorregulación que permiten solicitar a operadores como los portales que oculten una publicación propia a terceros cuando uno ya no puede borrarla directamente.
Desde abril de 2023, la Comisión de Protección de Datos Personales también ofrece el llamado «servicio Borrador», un sistema que solicita en nombre del interesado la eliminación de publicaciones propias realizadas cuando era menor de edad.
Así, durante los últimos diez años nos hemos preocupado por «¿y si no se puede borrar?». Casi nadie se preguntaba: «¿y si no se conserva?».
📉 En diez años desaparece el 38 %
El Pew Research Center seleccionó al azar unas 90.000 páginas web de cada año entre 2013 y 2023 —casi un millón en total— del repositorio web sin ánimo de lucro Common Crawl. Después, en octubre de 2023, intentó acceder de nuevo a cada una de esas direcciones.
¿Cuál fue el resultado? El 25 % del total no se podía abrir. Cuanto más antiguas eran las páginas, mayor era la proporción desaparecida: eran inaccesibles el 38 % de las que existían en 2013, alrededor del 20 % de las de 2021, en solo dos años, y el 8 % de las de 2023.
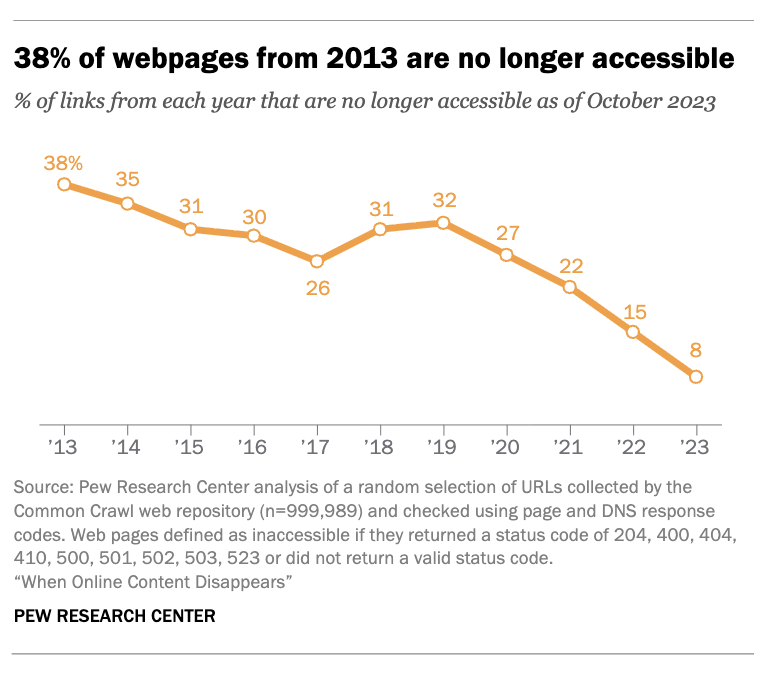
Estas cifras son conservadoras. El Pew Research Center solo clasificó como «inaccesibles» los errores que indicaban claramente que no existía el servidor o la página. Tanto las direcciones aún activas cuyo contenido había cambiado como las páginas que no se abrían por bloquear los bots se contaron como «accesibles». Por tanto, el número de páginas que no se abren correctamente en su dirección original debe de ser mayor.
🔨 Cómo muere una página
Las páginas desaparecen por muchos motivos. A veces desaparece el dominio entero, normalmente porque la empresa cierra o porque nadie paga la renovación anual del dominio y los costes del servidor.
Sin embargo, dentro de aquel 25 %, eran más frecuentes las páginas desaparecidas de sitios que seguían teniendo un propietario activo (16 %) que las desaparecidas por las razones anteriores (9 %). Esto suele ocurrir cuando el propietario modifica el sitio.
Al rediseñar una web o cambiar el programa del foro, la estructura de las direcciones puede cambiar aunque los textos se trasladen sin alteraciones. Si se omite la configuración que envía las direcciones antiguas a las nuevas —la redirección—, todos los enlaces externos se rompen. Y, para quienes se encargan del rediseño, esta configuración suele quedar muy por detrás de la puesta en marcha del nuevo sitio en la lista de prioridades.
Otras veces, el contenido desaparece por una limpieza, no por un rediseño. Desde 2009, Google ofrecía el servicio de direcciones abreviadas goo.gl, que convertía direcciones web largas en otras cortas como goo.gl/ABC12x. En julio de 2024 anunció que rompería todos los enlaces a partir del 25 de agosto del año siguiente. Alegó que el 99 % de ellos no había registrado actividad durante junio de 2024.
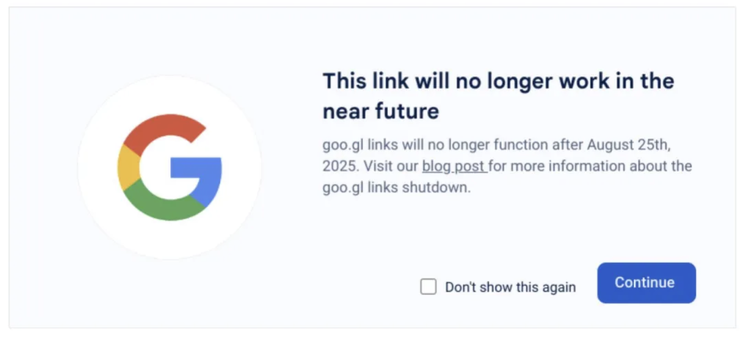
Ante las protestas por lo que ocurriría con los enlaces insertados en documentos, vídeos y publicaciones, Google cambió de postura poco más de tres semanas antes del cierre y decidió «mantener algunos enlaces». Solo desactivaría los que nadie hubiera pulsado a finales de 2024. Por eso, el dominio goo.gl sigue funcionando y los enlaces que sobrevivieron llevan a la página original, mientras que los demás están rotos y solo muestran una pantalla de error.
En definitiva, en muchos casos las páginas web desaparecen durante un rediseño o una reducción de costes, sin que nadie tenga la intención de borrarlas.
🏚️ Una biblioteca de la que solo quedan las direcciones
En su artículo «The Internet Is Rotting», publicado en The Atlantic en 2021, Jonathan Zittrain, de la Facultad de Derecho de Harvard, comparó la web con «un sistema sin biblioteca en el que cada persona guarda los libros en su casa y solo comparte la dirección». No tendría nada de extraño que, al visitar en 2021 una dirección registrada en 2015, el libro ya no estuviera.
La razón se encuentra en cómo se creó internet. Los investigadores que lo diseñaron no tenían dinero para construir por su cuenta una red gigantesca como la telefónica o la de distribución, ni pretendían ganar dinero con ella. Así que se limitaron a establecer reglas para conectar las redes existentes, sin que surgiera una empresa operadora ni un organismo gestor de internet. Tim Berners-Lee, que creó la web sobre esa infraestructura, también puso sus protocolos a disposición de todos gratuitamente.
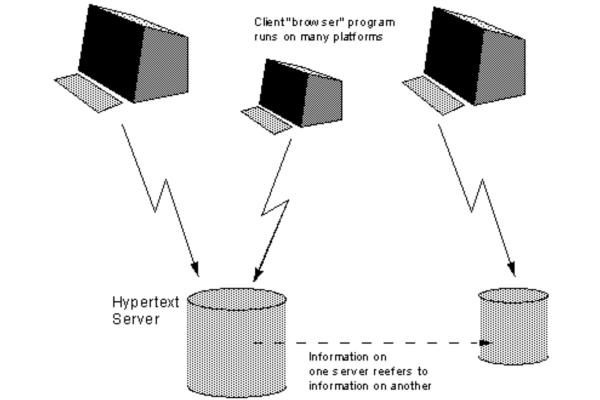
Al no cobrarse por el uso, tampoco se necesitaba una empresa que registrara quién utilizaba qué, ni un centro desde el que supervisar toda la web. Un enlace no era más que la dirección de otra página: podía apuntar a cualquier servidor del mundo, pero el propietario de ese servidor ni siquiera sabía quién había enlazado su página.
Berners-Lee era consciente de ello y, en 1998, pidió que no se cambiaran las direcciones en su texto «Cool URIs don’t change» («Las buenas direcciones no cambian»). Sin embargo, no incorporó ningún mecanismo que impidiera cambiarlas.
No es que no hubiera otros diseños. Xanadu, concebido por Ted Nelson décadas antes de la web, llegó a prever «enlaces bidireccionales» que notificaban también a la parte enlazada que se había creado un enlace. Desde el principio pretendía crear enlaces que no se rompieran.
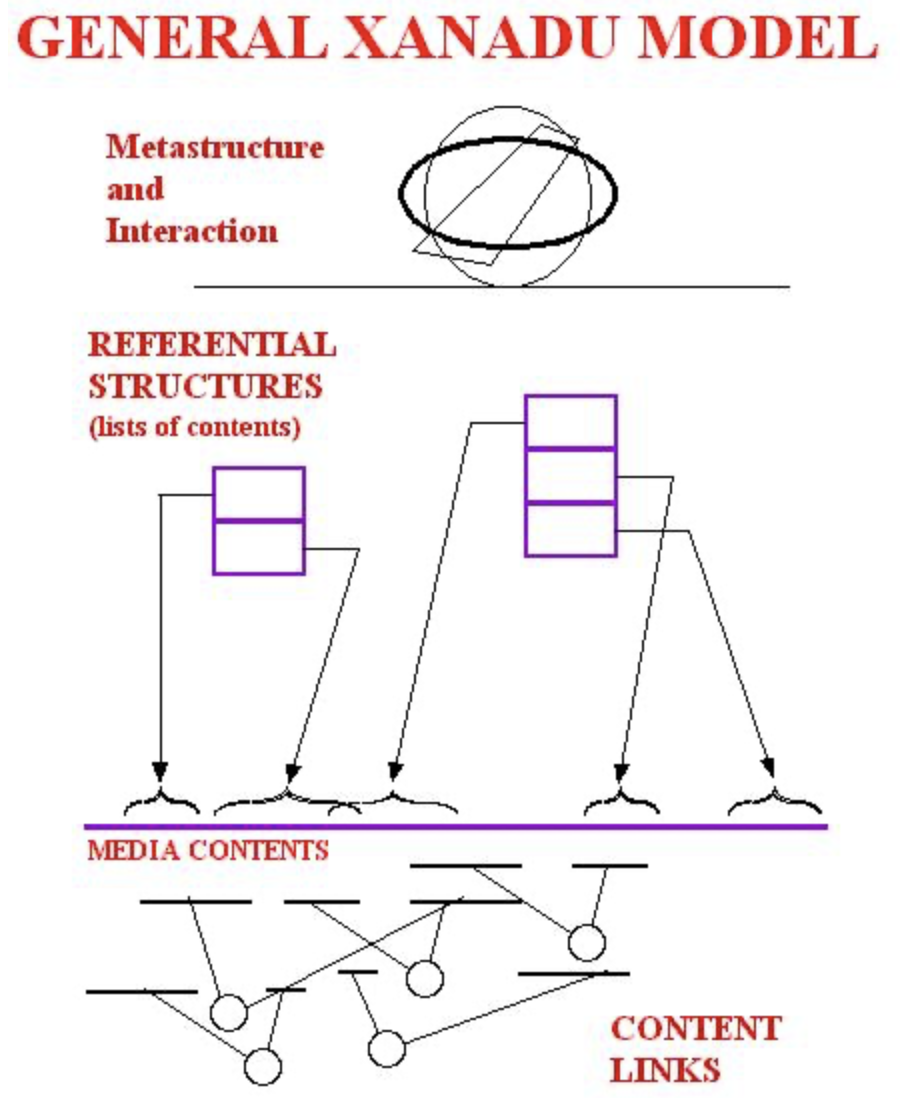
Pero Xanadu intentó resolver desde el principio tanto el control de versiones como la liquidación de derechos de autor y, pasadas varias décadas, seguía sin completarse adecuadamente. Más adelante, Nelson criticó a la web por haber trivializado el hipertexto con sus «enlaces unidireccionales que siempre se rompen». Sin embargo, lo que sobrevivió fue la web: imperfecta, pero capaz de funcionar desde el primer momento.
Zittrain denomina a esta actitud de diseño de internet y la web el «principio de procrastinación» (Procrastination Principle): en lugar de hacer más pesado el diseño intentando resolver de antemano todos los problemas que quizá surjan, se resuelven cuando aparecen. Por eso, que los sitios nacieran y desaparecieran y que las páginas cambiaran de lugar no era un defecto, sino una característica deliberada.
🫥 Un vacío de responsabilidad
El principio de procrastinación tuvo éxito, y la web, que no necesitaba permiso ni administrador, creció más deprisa que cualquier otra red. Pero, a cambio, dejó «un vacío de responsabilidad a la hora de mantener el contenido del que dependen otros». Al dueño de una casa le basta con cuidar sus propios libros y nadie está obligado a impedir que desaparezcan los libros de las casas ajenas.
Este vacío suele pasar inadvertido, pero se hace visible en cuanto el operador deja de ocuparse del sitio. Paramount cerró la división de MTV News en mayo de 2023 y, poco más de un año después, en junio de 2024, retiró también su web. De la noche a la mañana, todas las direcciones de los artículos acumulados desde 1996 pasaron a redirigir a la página principal de MTV. Paramount afirmó que conservaba los artículos internamente, pero desde fuera no se podían consultar.
En enero de ese mismo año, la startup informativa The Messenger, que cerró solo ocho meses después de su lanzamiento, vació su sitio pocas horas después de anunciar el cierre. Solo quedaron su nombre y una dirección de correo electrónico.
Sorprendentemente, los medios de comunicación no dedican demasiado esfuerzo a conservar sus artículos. Cuando el Tow Center de la Universidad de Columbia investigó 21 medios en 2019, constató que 19 no tomaban ninguna medida para preservar sus artículos web. No tenían ni siquiera prácticas informales, mucho menos una política de conservación por escrito. En la práctica, habían dejado esa tarea a entidades externas como Internet Archive o Google. Para unos medios siempre pendientes de «lo que está ocurriendo ahora», conservar los artículos ya publicados quedaba en segundo plano.
Antes, las bibliotecas habrían cubierto este vacío, pero, con el paso de la edición al entorno digital, también ellas han empezado a comprar el derecho de acceso durante un periodo determinado, en lugar de poseer revistas académicas y libros electrónicos. Cuando termina la suscripción, ni siquiera se puede abrir lo recibido hasta entonces. En cierto modo, hasta las bibliotecas han acabado teniendo solo las direcciones de las casas, no los libros.
🧾 Conservar cuesta dinero
El investigador en preservación digital David Rosenthal puso en marcha el programa de conservación LOCKSS en la Biblioteca de Stanford en 1998 y lo dirigió hasta jubilarse en 2017. LOCKSS significa «Lots Of Copies Keep Stuff Safe»: muchas copias mantienen las cosas a salvo. La idea era que varias bibliotecas se repartieran copias propias de las revistas electrónicas, para que volvieran a tener libros y no solo direcciones.
Cuando se publicó el informe del Pew Research Center, Rosenthal formuló varias críticas. Una de ellas era que no se había comprobado si las páginas que no se abrían seguían existiendo como copias en archivos web. No poder abrir algo no es lo mismo que haberlo perdido. De hecho, en abril de 2026, Internet Archive cotejó las direcciones del Pew Research Center con su Wayback Machine. Al buscar también allí, las «páginas que no se abrían» pasaron de ser una de cada cuatro a aproximadamente una de cada diez.
Pero las copias no se crean solas. Rosenthal lleva más de veinte años repitiendo que la mayor amenaza para la preservación digital no es la tecnología, sino el dinero. Carecer de fondos para conservar los archivos supone una amenaza mucho mayor que su deterioro u obsolescencia. En 2017 estimó que el gasto mundial en archivar la web no llegaba a 30 millones de dólares al año, pese a que crear ese contenido había costado cientos de miles de millones. Su advertencia es que, de seguir así, no se conservará más de la mitad de lo que los lectores del futuro deberían poder consultar.
Según la regla empírica de Rosenthal, la mitad del coste de la preservación digital se incurre en la captura inicial. El almacenamiento supone un tercio y facilitar el acceso, el sexto restante. Puesto que no se puede capturar una página una vez desaparecida, lo que se conserve dependerá, en última instancia, de quién pague ese primer coste mientras siga existiendo.
Entonces, ¿cómo se están gestionando los registros que hay actualmente en la web? ¿Y cuánto esfuerzo debemos dedicar a conservarlos?
En la próxima entrega veremos qué lagunas dejan en el conocimiento las páginas desaparecidas y qué esfuerzos se están realizando para hacer frente a su desaparición.
#EntreTecnologíaYReglas #DeterioroDeEnlaces #DesapariciónDigital #DerechoAlOlvido #PewResearch #Registros