Il existe un métier appelé « croque-mort numérique ».
Lorsque des clients leur demandent de supprimer des textes, des photos et des vidéos, ces professionnels les retrouvent sur internet et les effacent ; si cela ne fonctionne pas, ils tentent au moins de les faire disparaître des résultats de recherche. Les demandes vont des montages deepfake à un passé que l’on souhaite cacher. Les tarifs commencent autour de 50 000 wons par publication, mais, avec la multiplication des sites dont les contenus sont difficiles à supprimer, on dit aujourd’hui que « le prix est celui qu’ils demandent ».
Nous avons cru qu’internet était un « espace où tout reste exposé pour toujours », au point que l’effacement est devenu un métier.
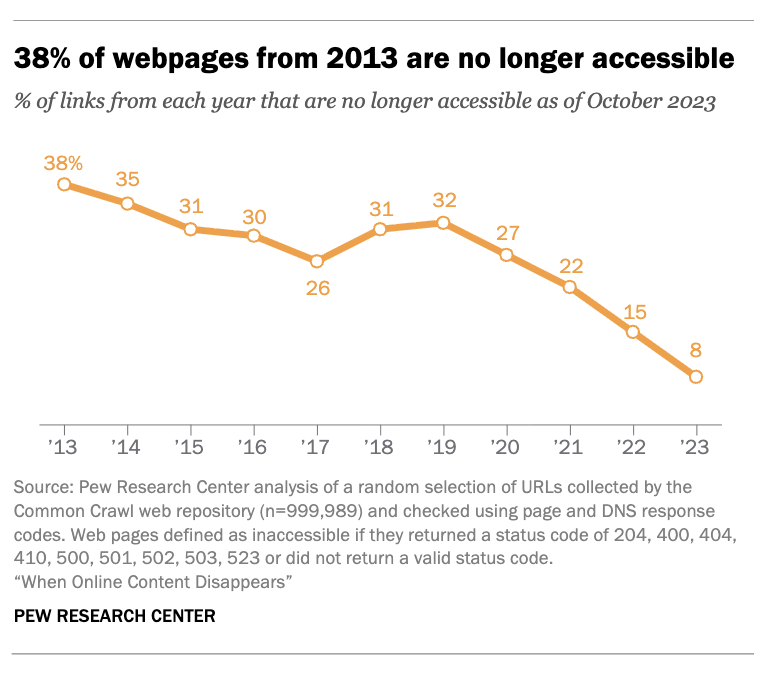
Pourtant, le rapport « When Online Content Disappears », publié par le Pew Research Center en mai 2024, a mis en lumière une facette inattendue d’internet : 38 % des pages web qui existaient en 2013 ne s’ouvraient plus dix ans après.
D’un côté, on paie quelqu’un pour effacer des contenus ; de l’autre, quatre pages sur dix disparaissent sans que personne y touche. Comment l’expliquer ?
🧹 La naissance du « droit à l’oubli »
En 1998, le logement de l’avocat espagnol Mario Costeja González a été saisi puis mis aux enchères pour des dettes envers la Sécurité sociale, et le quotidien La Vanguardia a publié l’annonce.
Costeja a remboursé sa dette peu après, mais, pendant plus de dix ans, cette annonce apparaissait en tête des résultats lorsqu’il saisissait son nom dans Google. En 2010, il a donc déposé une réclamation contre le journal et Google auprès de l’Agence espagnole de protection des données (AEPD). L’Agence a maintenu l’annonce du journal, publiée conformément à la loi, mais a ordonné à Google de retirer le lien des résultats de recherche.
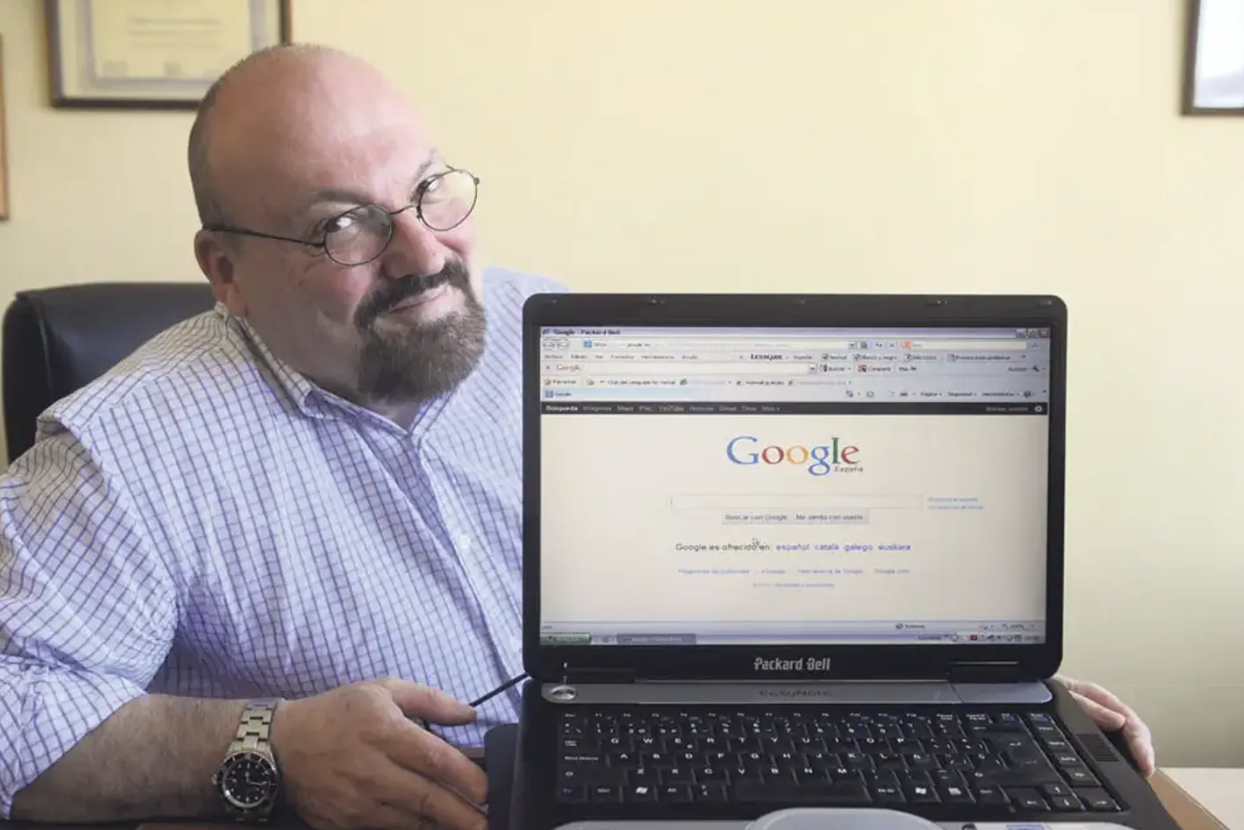
Google ayant contesté cette décision en justice, la juridiction espagnole a estimé que la question dépendait de l’interprétation du droit de l’UE et a demandé à la Cour de justice de l’Union européenne de se prononcer. Le 13 mai 2014, celle-ci a jugé que les moteurs de recherche avaient eux aussi l’obligation de supprimer ce type de résultats. Cet arrêt a fait connaître dans le monde entier l’expression « droit à l’oubli »[1].
[1] Google Spain SL, Google Inc. v. AEPD, Mario Costeja González — Cour de justice de l’Union européenne (CJUE), grande chambre, arrêt du 13 mai 2014, affaire C-131/12. La Cour a considéré l’exploitant du moteur de recherche comme responsable du traitement des données personnelles et jugé que la suppression de résultats « inadéquats, qui ne sont plus pertinents ou excessifs » pouvait être demandée, même si l’article d’origine demeurait légalement en ligne. L’article 17 du règlement général sur la protection des données de l’UE (RGPD), applicable depuis 2018, l’a consacré comme « droit à l’effacement (droit à l’oubli) ».
La Corée partageait cette préoccupation. En juin 2016, la Commission coréenne des communications a mis en application les « Lignes directrices relatives au droit de demander l’exclusion de l’accès à ses propres publications sur internet », que la presse a qualifiées de « version coréenne du droit à l’oubli ». Il s’agit de règles d’autorégulation permettant de demander à des opérateurs, tels que les portails, de masquer une publication personnelle aux tiers lorsqu’on ne peut plus la supprimer soi-même.
Depuis avril 2023, la Commission de protection des données personnelles propose également le « service Gomme », un dispositif qui demande, au nom de l’intéressé, la suppression de ses propres publications mises en ligne lorsqu’il était mineur.
Ainsi, pendant les dix dernières années, nous nous sommes inquiétés de savoir : « Et si cela ne pouvait pas être effacé ? » Presque personne ne se demandait : « Et si rien ne restait ? »
📉 En dix ans, 38 % disparaissent
Le Pew Research Center a tiré au sort environ 90 000 pages web pour chaque année de 2013 à 2023, soit près d’un million au total, dans le dépôt web à but non lucratif Common Crawl. Puis, en octobre 2023, il a essayé d’accéder de nouveau à chacune de ces adresses.
Quel a été le résultat ? Au total, 25 % ne s’ouvraient plus. Plus les pages étaient anciennes, plus elles avaient disparu : 38 % des pages qui existaient en 2013 étaient inaccessibles, contre environ 20 % de celles de 2021, en seulement deux ans, et 8 % de celles de 2023.
Ces chiffres sont prudents. Le Pew Research Center n’a compté comme « inaccessibles » que les erreurs indiquant clairement l’absence du serveur ou de la page. Les adresses encore actives dont le contenu avait changé et les pages qui ne s’ouvraient pas en raison du blocage des robots ont toutes été classées comme « accessibles ». Le nombre de pages qui ne s’ouvrent pas correctement à leur adresse d’origine est donc sans doute plus élevé.
🔨 Comment une page meurt
Les pages disparaissent pour diverses raisons. Parfois, c’est tout le domaine qui disparaît, généralement parce que l’entreprise ferme ou que personne ne paie le renouvellement annuel du domaine et les frais du serveur.
Mais, parmi les 25 % précédents, les pages qui disparaissent d’un site dont le propriétaire est toujours actif sont plus nombreuses (16 %) que celles qui disparaissent pour les raisons évoquées plus haut (9 %). Cela se produit généralement lorsque le propriétaire remanie le site.
Lorsqu’un site est refondu ou que le logiciel du forum est remplacé, la structure des adresses change même si les textes sont transférés à l’identique. Si l’on omet alors de configurer le renvoi des anciennes adresses vers les nouvelles — la redirection —, tous les liens extérieurs sont rompus. Or, pour les responsables de la refonte, ce paramétrage passe souvent bien après la mise en ligne du nouveau site.
Parfois, ce n’est pas une refonte, mais une opération de nettoyage qui fait disparaître des contenus. Depuis 2009, Google proposait goo.gl, un service transformant les longues adresses web en adresses courtes, comme goo.gl/ABC12x. En juillet 2024, l’entreprise a annoncé qu’elle couperait tous les liens à partir du 25 août de l’année suivante, au motif que 99 % d’entre eux n’avaient enregistré aucune activité durant le mois de juin 2024.
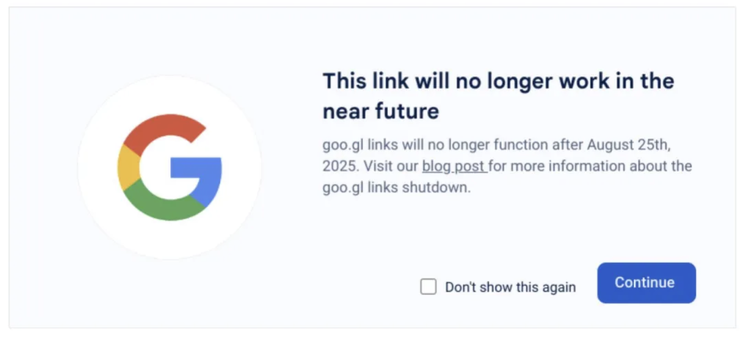
Face aux protestations sur le sort des liens insérés dans les documents, les vidéos et les publications, Google a changé de position un peu plus de trois semaines avant la fermeture, décidant de « conserver certains liens ». Seuls ceux sur lesquels personne n’avait cliqué à la fin de 2024 seraient désactivés. Le domaine goo.gl fonctionne donc encore et les liens qui ont survécu mènent à la page d’origine ; les autres sont rompus et n’affichent qu’un écran d’erreur.
En somme, dans de nombreux cas, les pages web disparaissent lors d’une refonte ou d’une réduction des coûts, sans que personne ait cherché à les effacer.
🏚️ Une bibliothèque dont il ne reste que les adresses
Dans son article « The Internet Is Rotting », publié dans The Atlantic en 2021, Jonathan Zittrain, de la faculté de droit de Harvard, a comparé le web à « un système sans bibliothèque où chacun garde les livres chez soi et ne partage que son adresse ». Il n’y aurait rien d’étonnant à ce qu’en se rendant en 2021 à une adresse enregistrée en 2015, on n’y trouve plus le livre.
La raison tient à la manière dont internet a été créé. Les chercheurs qui l’ont conçu n’avaient pas les moyens de construire eux-mêmes un immense réseau comparable au réseau téléphonique ou à un réseau de livraison, et n’avaient pas non plus l’intention d’en tirer de l’argent. Ils se sont donc contentés de définir des règles pour relier les réseaux existants, sans qu’apparaissent une entreprise exploitante ou une organisation gestionnaire d’internet. Tim Berners-Lee, qui a créé le web sur cette infrastructure, a lui aussi mis ses protocoles gratuitement à disposition.
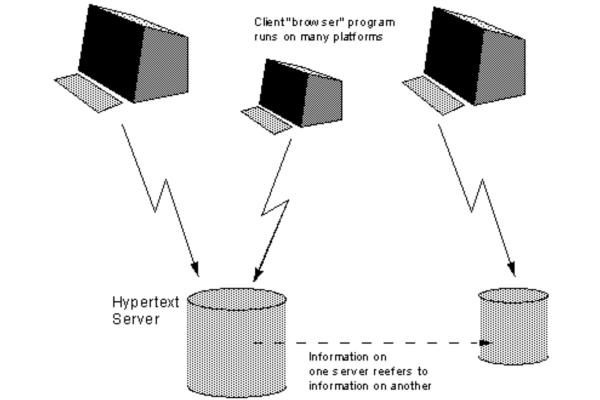
Puisqu’aucune redevance n’était perçue, il n’était pas nécessaire d’avoir une entreprise enregistrant qui utilisait quoi, ni un centre supervisant l’ensemble du web. Un lien ne faisait qu’indiquer l’adresse d’une autre page : il pouvait pointer vers n’importe quel serveur dans le monde, mais le propriétaire de ce serveur ne savait même pas qui avait créé un lien vers sa page.
Berners-Lee en était conscient : en 1998, dans son texte « Cool URIs don’t change » (« Les bonnes adresses ne changent pas »), il recommandait de ne pas changer les adresses. Mais il n’a pas intégré de mécanisme empêchant de le faire.
Ce n’est pas qu’il n’existait aucune autre conception. Xanadu, imaginé par Ted Nelson plusieurs décennies avant le web, prévoyait même des « liens bidirectionnels », qui informaient aussi la partie visée qu’un lien avait été créé vers elle. Dès le départ, l’objectif était de créer des liens qui ne se rompraient pas.
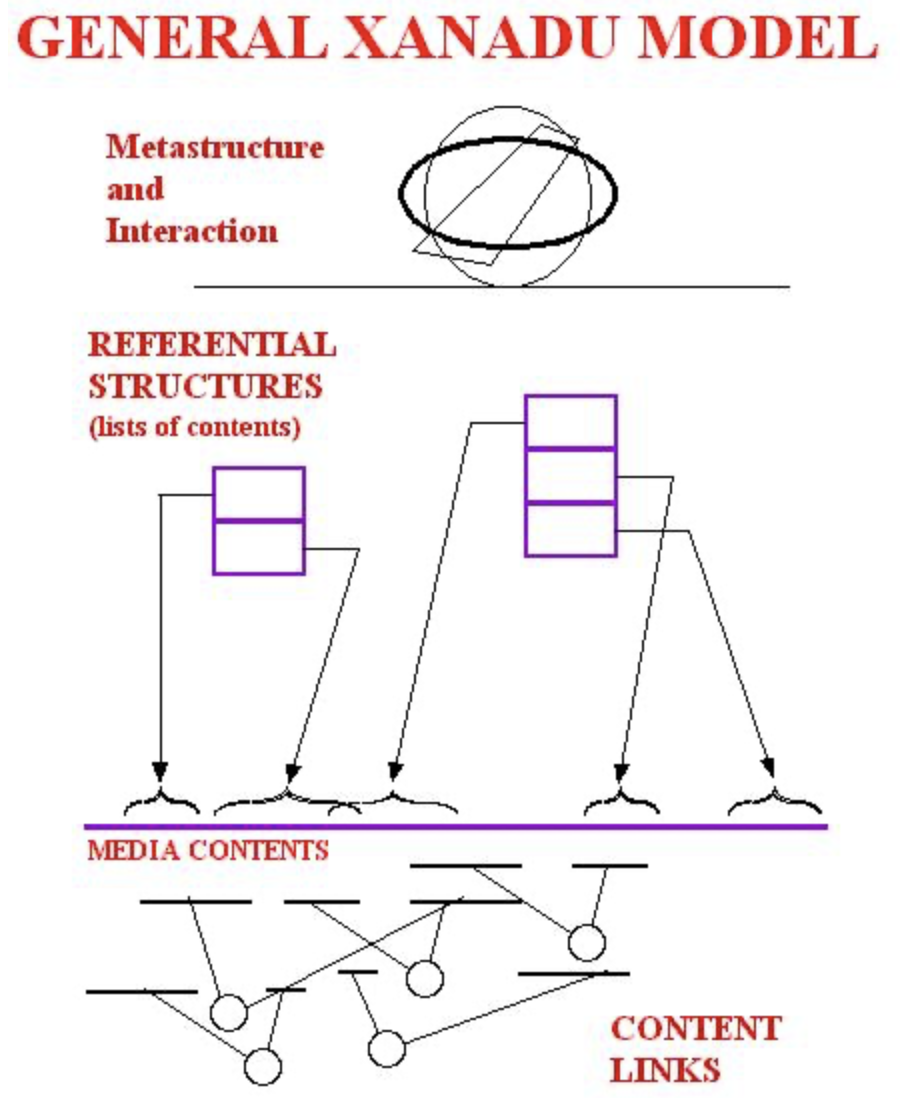
Mais, en voulant tout prendre en compte dès le début, du suivi des versions au règlement des droits d’auteur, Xanadu n’a pas pu être véritablement achevé, même après plusieurs décennies. Nelson a ensuite reproché au web d’avoir banalisé l’hypertexte avec ses « liens à sens unique, qui se rompent sans cesse ». Pourtant, c’est le web qui a survécu : imparfait, mais opérationnel d’emblée.
Zittrain appelle cette approche de la conception d’internet et du web le « principe de procrastination » (Procrastination Principle). Au lieu d’alourdir la conception en cherchant à résoudre à l’avance tous les problèmes susceptibles de se présenter, on les règle lorsqu’ils apparaissent. Ainsi, l’apparition et la disparition des sites, tout comme le déplacement des pages, n’étaient pas des défauts, mais des caractéristiques voulues.
🫥 Un vide de responsabilité
Le principe de procrastination a réussi : sans autorisation ni administrateur nécessaires, le web s’est développé plus vite que tout autre réseau. Mais, en contrepartie, un « vide de responsabilité quant au maintien des contenus dont d’autres dépendent » est apparu. Le propriétaire d’une maison n’a qu’à veiller à ses propres livres, et personne n’est tenu d’empêcher la disparition des livres chez les autres.
Ce vide passe habituellement inaperçu, mais devient visible dès que l’exploitant cesse de s’en occuper. Paramount a supprimé la division MTV News en mai 2023 puis, un peu plus d’un an après, en juin 2024, a également fermé son site. Du jour au lendemain, toutes les adresses des articles accumulés depuis 1996 ont renvoyé vers la page d’accueil de MTV. Paramount a déclaré conserver les articles en interne, mais ils n’étaient plus consultables de l’extérieur.
En janvier de la même année, la jeune entreprise d’information The Messenger, qui a fermé huit mois après son lancement, a vidé son site quelques heures après l’annonce de sa fermeture. Il ne restait que son nom et une adresse électronique.
Étonnamment, les médias ne consacrent pas beaucoup d’efforts à la conservation de leurs articles. Lorsqu’en 2019 le Tow Center de l’université Columbia a étudié 21 médias, il a constaté que 19 d’entre eux ne prenaient aucune mesure pour préserver leurs articles web. Ils n’avaient même pas de pratiques informelles, encore moins de politique de conservation écrite. Dans les faits, ils avaient laissé cette tâche à des organismes extérieurs comme Internet Archive ou Google. Pour des médias toujours à la poursuite de « ce qui se passe maintenant », conserver les articles déjà publiés était secondaire.
Autrefois, les bibliothèques auraient comblé ce vide. Mais, avec le passage de l’édition au numérique, elles aussi se sont mises à acheter un droit d’accès limité dans le temps plutôt qu’à posséder les revues savantes et les livres électroniques. Quand l’abonnement prend fin, même ce qui a été reçu jusque-là ne s’ouvre plus. En quelque sorte, les bibliothèques elles-mêmes n’ont plus les livres, mais seulement les adresses des maisons.
🧾 Conserver coûte de l’argent
Le chercheur en préservation numérique David Rosenthal a lancé le programme de conservation LOCKSS à la bibliothèque de Stanford en 1998 et l’a dirigé jusqu’à sa retraite en 2017. LOCKSS signifie « Lots Of Copies Keep Stuff Safe » : de nombreuses copies assurent la sécurité des contenus. L’idée était que plusieurs bibliothèques détiennent elles-mêmes des copies des revues électroniques, afin qu’elles retrouvent des livres plutôt que de simples adresses.
À la publication du rapport du Pew Research Center, Rosenthal a formulé plusieurs critiques. L’une d’elles était que le centre n’avait pas vérifié si les pages qui ne s’ouvraient plus subsistaient sous forme de copies dans des archives web. Ne plus pouvoir ouvrir un contenu et l’avoir perdu sont deux choses différentes. De fait, en avril 2026, Internet Archive a comparé les adresses du Pew Research Center avec sa Wayback Machine. En cherchant aussi dans celle-ci, la proportion des « pages qui ne s’ouvraient plus » est passée d’environ une sur quatre à une sur dix.
Mais les copies ne se créent pas toutes seules. Depuis plus de vingt ans, Rosenthal répète que la principale menace pour la préservation numérique n’est pas la technologie, mais l’argent. Le manque de fonds pour conserver les fichiers est une menace bien plus grande que leur détérioration ou leur obsolescence. En 2017, il estimait que le monde consacrait moins de 30 millions de dollars par an à l’archivage du web, alors que la création de ces contenus avait coûté des centaines de milliards de dollars. Son avertissement est qu’à ce rythme, plus de la moitié de ce que les lecteurs de demain devraient pouvoir consulter ne sera pas conservée.
Selon la règle empirique de Rosenthal, la moitié du coût de la préservation numérique est engagée lors de la collecte initiale. Le stockage en représente un tiers, et la mise à disposition le sixième restant. Puisqu’on ne peut plus collecter une page après sa disparition, ce qui sera conservé dépend finalement de la personne qui assumera ce premier coût pendant qu’elle existe encore.
Alors, comment les documents présents sur le web sont-ils gérés aujourd’hui ? Et quels efforts devons-nous consacrer à leur préservation ?
Dans le prochain volet, nous verrons quelles lacunes les pages disparues laissent dans le savoir et quels efforts sont entrepris pour lutter contre leur disparition.
#EntreTechnologieEtRègles #PourrissementDesLiens #DisparitionNumérique #DroitÀLOubli #PewResearch #Archives