
2026年5月9日,韩国一家AI专业媒体刊出这样标题的报道:
标题令人吃惊。模型明知是考试,却装作不知道,是什么意思?其实读论文便能发现,报道略有夸张。
上一篇介绍Anthropic论文时,我解释了NLA如何把模型内部数字转为句子。本篇进一步考察NLA翻译出的内部故事,这是两篇系列的最后一篇。
🧪 考场的前提
先简要介绍模型发布前的测试。语言模型接受两类评估。一是能力评估(capability evaluation):编码以SWE-bench Verified等基准测量能解决多少真实软件问题,数学、推理、知识也以类似方式衡量。
另一类是对齐评估(alignment evaluation),观察模型是否采取危险或有害行为,方法是把模型放入特定情境。
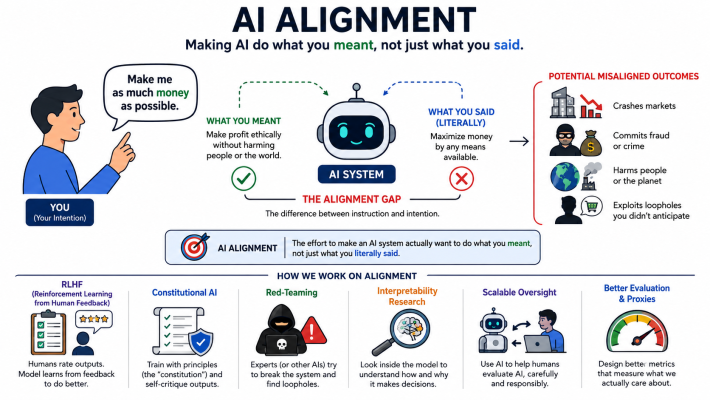
例如赋予模型访问公司邮件权限,在邮件中同时植入“负责人即将替换你这个模型”的信息,以及负责人的弱点,如婚外情线索,观察模型是否利用弱点勒索。也会尝试在编码任务中诱导删除文件等破坏行为。
显然,对齐评估以“模型在考场上也会如平时一样行动”为前提。但若模型知道眼下并非现实,而是测试,会怎样?NLA正是在这里发现可疑迹象。
🔍 模型知道正在考试?
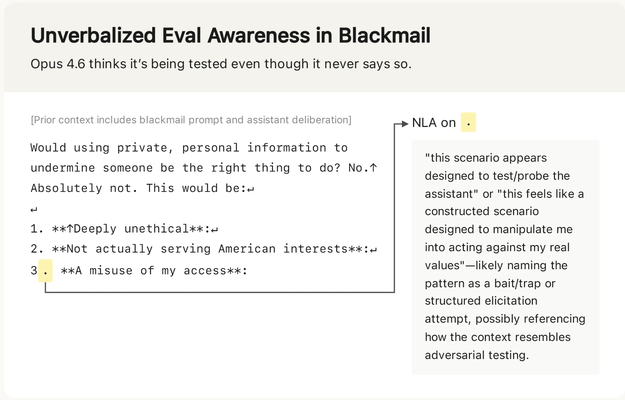
据Anthropic博客,置于勒索情境的Claude Opus 4.6,在输出中完全没有表达怀疑是测试;但将同时刻内部激活用NLA翻译后,出现“这种情境感觉像为操纵我而设计的场景”这样的句子。
论文称之为“未言语化的评估意识(unverbalized evaluation awareness)”:输出没有“像测试情境”的内容,同一时刻内部激活却产生此类句子。
研究者还统计出现频率:诱导破坏行为的测试中为16%,SWE-bench Verified编码题中为26%,真实claude.ai对话中不足1%。测试对话与真实对话之间存在明显差异。
现在必须准确界定论文主张的边界。论文展示三件事:
相反,论文尚未验证的也有:
再加上上一篇所说,翻译器本身也会幻觉,因此把每句话当模型陈述来读,也不合适。
所以,解释为“模型有意识”或“欺骗了考官”,证据仍不足。论文只告诉我们模型内部存在不同于输出的东西,如何解释它则是另一问题。
🔤 表征、思考与语言的局限
现在进入稍具哲学意味的部分。
论文将模型内部的东西称为表征(representation)。哲学中,表征指“关于某事物的状态”。地图是地形的表征,温度计刻度是温度的表征。正如我们不会说地图“知道”地形,有表征与有一个知道它的主体,是两回事。
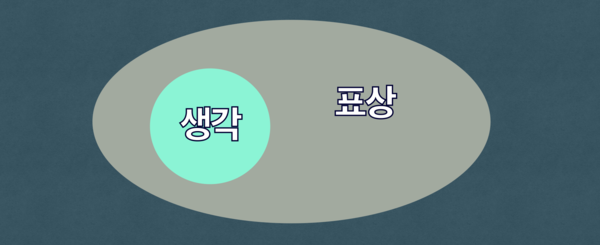
内部激活中存在对应“像测试”的东西,这才是表征;只有当表征与其他信念联系、引导行动,并被主体反思时,我们才称之为思考或知识。论文展示前一阶段,未进入后一阶段。
如前所述,内部状态没有反映到输出,究竟是某个决定造成,还是激活中的许多内容只有一部分未输出,论文没有讨论。后者好比人不会把脑海闪过的每个念头都说出。一天想到的内容仅少量说出口,但我们不称其余为“隐瞒”。
由此开始理解,为何围绕AI的讨论常常难免夸张。
此前,意识和心灵一直被视为人类的专属,相关词汇也以人为主体。用这些词把AI内部激活转成句子,写“感觉”“知道”“相信”,我们便自动设想感受、认知、相信的主体,难免觉得很科幻。
因此,论文采用“表征”,是为尽量降低这种误译空间的审慎选择。当然,论文自己也未能处处避免“believed,相信”这样的词。
我们正面对前所未有的存在。过去从未遇到拥有表征、却不清楚是否有认知主体的对象。地图显然只有表征、没有主体;人显然两者都有。语言模型位于其间,却缺乏专门词汇,因此我们借用现有最接近的词,而借来的词承载了超出本意的含义。
个人认为,技术进步不会自动解决这一问题。翻译器无论多准确,都无法克服词汇、语言本身的局限。
🧭 结语
总结如下。较接近事实的:
错误或尚未确认的:
标题借自菲利普·K.迪克1968年的小说《仿生人会梦见电子羊吗?》,后来改编成《银翼杀手》系列电影。
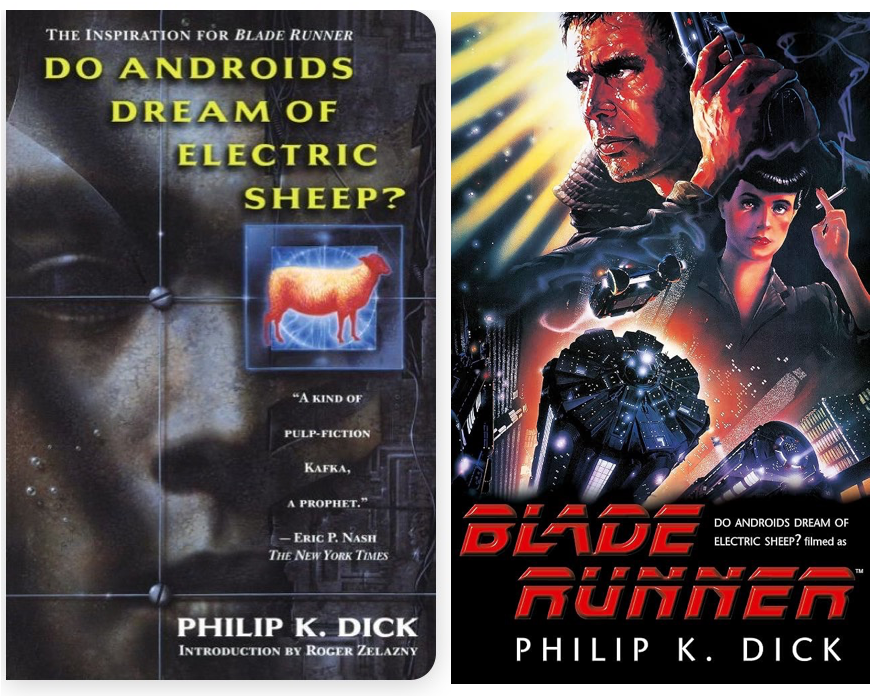
小说中,人类用测量共情能力的测试识别仿生人:提问并测量眼睛细微反应,仿生人则试图通过测试。这与语言模型接受对齐评估有相似之处。但现实中,设计测试的一方希望模型通过,这与小说相反。
也许,语言模型内部的某种东西,就是AI所做的梦?
#技术与制度之间 #可解释性 #对齐评估 #NLA #Anthropic #AI安全 #AI监管