Jonathan Zittrain, mencionado en la entrega anterior y autor del ensayo «The Internet Is Rotting» de The Atlantic, es profesor de la Facultad de Derecho de Harvard. Su investigación se centra en la relación entre internet y el derecho, y lleva más de diez años estudiando la ruptura de los enlaces de la web, contándolos él mismo.
Hubo un episodio que lo llevó a empezar esta labor.
El 27 de junio de 2011, el Tribunal Supremo de Estados Unidos declaró inconstitucional una ley de California que prohibía vender videojuegos violentos a menores. En este caso, el magistrado Samuel Alito estuvo de acuerdo con el fallo, pero redactó una opinión concurrente por separado. Para subrayar la gravedad de la violencia en los videojuegos actuales, citó como fundamento varios sitios web que había consultado personalmente. Uno de ellos era ssnat.com.
Algún tiempo después, al abrir esa dirección, en lugar del contenido original aparecía este texto:
«¿No es una suerte que no haya citado esta página en la colección oficial de sentencias del Tribunal Supremo? Si lo hubiera hecho, como el magistrado Alito, el contenido original habría desaparecido hace tiempo y otra persona habría comprado este dominio para comentar lo efímeros que son los enlaces en la era de internet».
«Y si lo hubiera citado en The New York Times, ¿publicaría una corrección sobre el texto que ha cambiado?»
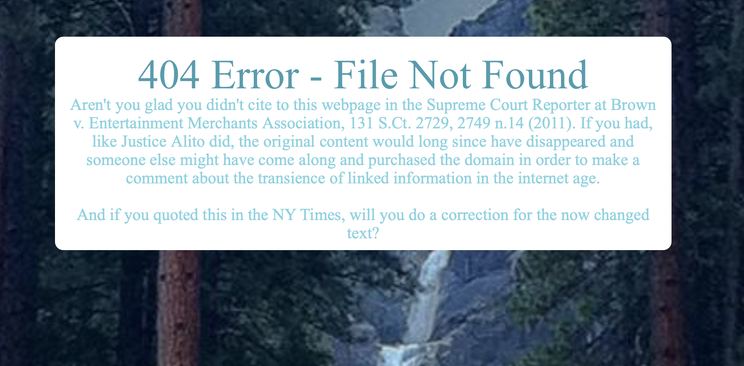
Era una broma que alguien había dejado tras comprar el dominio caducado. El fundamento de una sentencia del Tribunal Supremo, uno de los documentos redactados para perdurar más tiempo en Estados Unidos, no había resistido ni unos pocos años.
Zittrain decidió investigar más a fondo este problema junto a sus colegas Kendra Albert y Lawrence Lessig.
🔗 Citas imposibles de comprobar
Los tres abrieron todas las URL citadas en las sentencias del Tribunal Supremo federal desde que se utilizó por primera vez un hipervínculo en una sentencia, en 1996. La mitad ya no llevaba al contenido al que apuntaba originalmente. Esto incluía tanto el deterioro de enlaces (link rot), cuando al pulsar una dirección no aparece nada, como el deterioro de referencias (reference rot), cuando la dirección se abre, pero el contenido citado ha desaparecido o ha cambiado.
El derecho es un sistema construido sobre citas. Las sentencias fundamentan sus conclusiones citando decisiones anteriores, normas y materiales, y las sentencias posteriores vuelven a citar esas decisiones. Que la mitad de esos fundamentos se hubiera convertido en direcciones que no se podían visitar era una situación bastante grave.
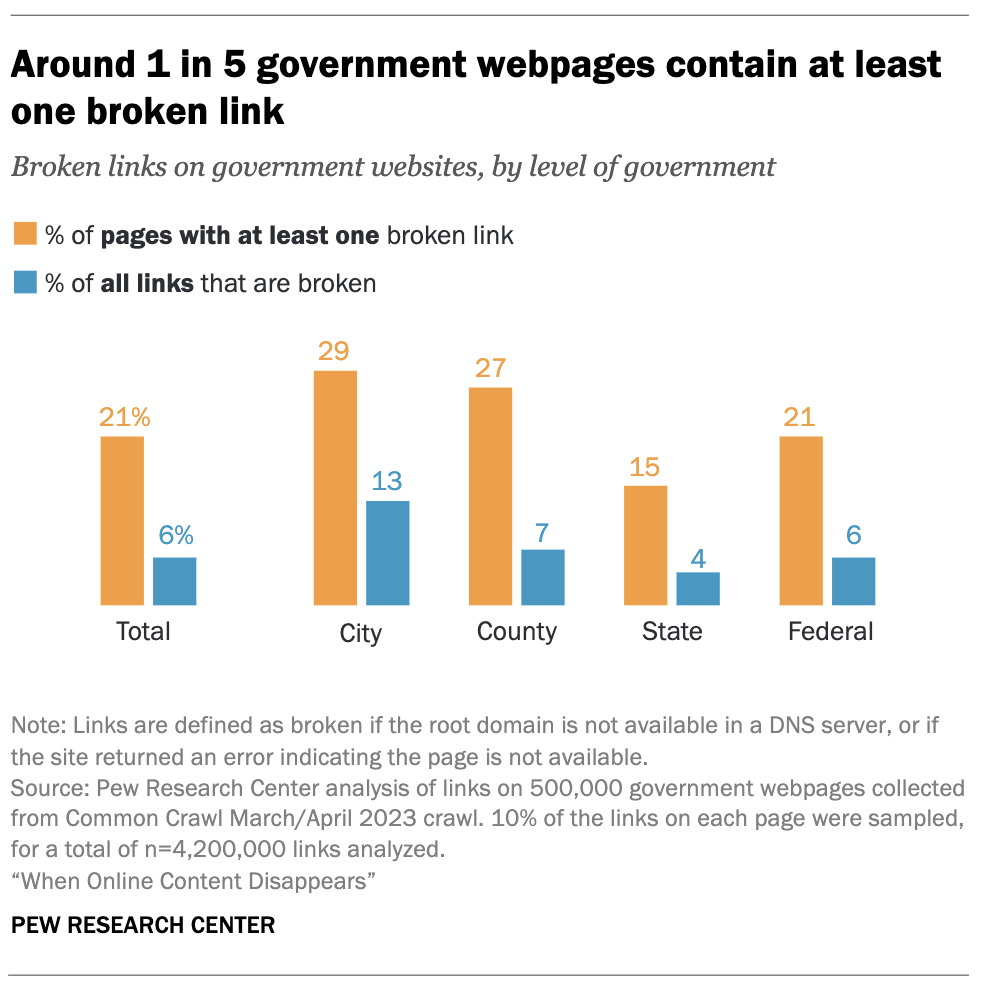
Fuera de los tribunales ocurre lo mismo. El Pew Research Center siguió los enlaces de 500.000 páginas web del Gobierno estadounidense, 500.000 páginas de noticias y 50.000 artículos de Wikipedia en inglés, tomando como referencia la primavera de 2023. El 21 % de las páginas gubernamentales y el 23 % de las de noticias contenían al menos un enlace que no se abría. Los grandes medios no gestionaban mejor sus enlaces.
En Wikipedia la situación es peor. El 11 % de los enlaces de las referencias estaba muerto y el 54 % de los artículos contenía al menos un enlace de referencia muerto. Es decir, la mitad de la enciclopedia más leída del mundo se apoya en fuentes que no se pueden consultar para verificarlas.
🛟 Quienes conservan
Hasta aquí, parece que la web se está desmoronando sin remedio. Pero ¿recuerdan que, al final de la entrega anterior, decíamos que muchas de las páginas que no se abrían «no habían desaparecido de verdad»? Era porque alguien había guardado copias en algún lugar de la web.
¿Quién lo había hecho? No era un Estado, una universidad ni una empresa creadora de la web. Era una única organización sin ánimo de lucro fundada por una persona: Internet Archive, la biblioteca digital sin ánimo de lucro que Brewster Kahle creó en 1996.
Wayback Machine, el servicio de Internet Archive, es un repositorio de páginas web en el que cualquiera puede introducir una dirección y ver el aspecto que tenía esa página en distintas fechas. Su rastreador recorre la web, captura las páginas y acumula copias de cada momento. Según se informó, en octubre de 2025 esas copias superaron el billón de páginas.
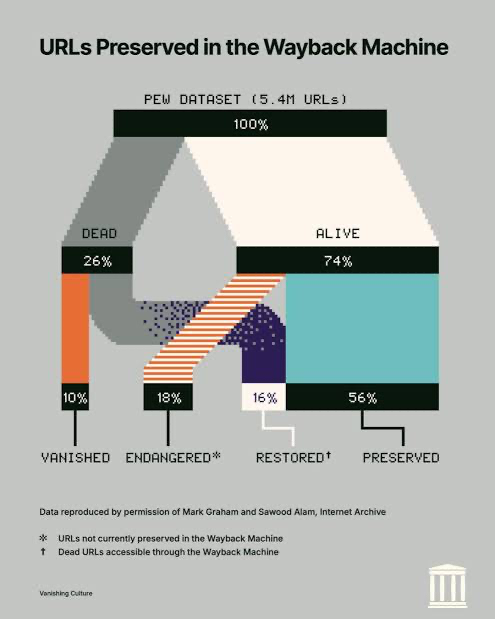
Como vimos al final de la entrega anterior, Wayback Machine recuperó muchas de las páginas que el Pew Research Center había considerado inaccesibles. En ese mismo análisis, Internet Archive también comprobó que un 18 % de las páginas seguía activo, pero se encontraba «en riesgo» porque nadie lo había guardado aún. Internet Archive concluye el informe con estas palabras: «Si ves algo, guárdalo» (See Something, Save Something).
Zittrain considera que no es casualidad que fuera un ciudadano, y no una institución existente, quien tomara la iniciativa. Ninguna institución estaba dispuesta a asumir los riesgos jurídicos de capturar y guardar la web.
Por cierto, en Corea hay una institución que tiene esta labor encomendada por ley. La Biblioteca Nacional de Corea recopila la web coreana desde 2004 bajo el nombre OASIS. Gracias a ello, hasta finales de 2022 había conservado 2,45 millones de recursos web —incluidos sitios web, informes y revistas publicados únicamente en la web, entre otros—, de los cuales 1,01 millones eran sitios web.
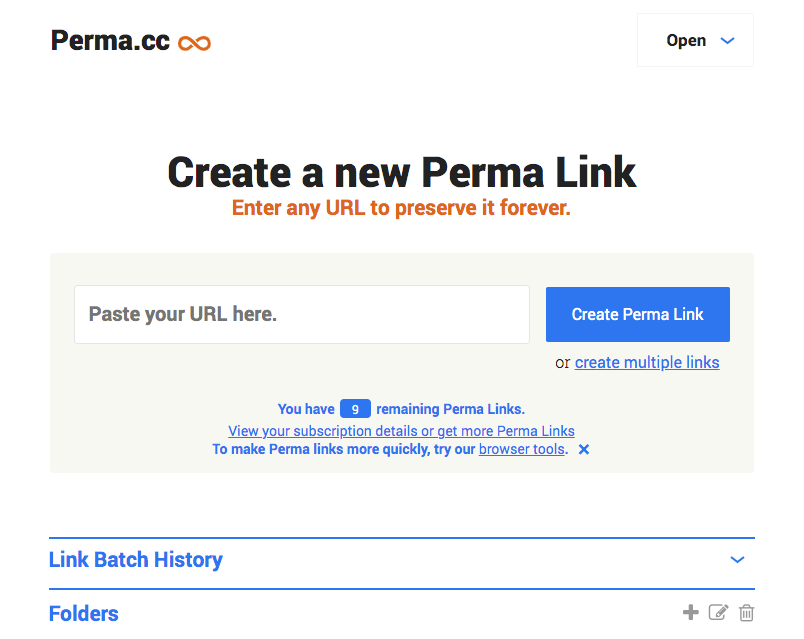
Por otra parte, los tres investigadores, entre ellos Zittrain, propusieron una solución junto con los resultados de su estudio: Perma.cc, el servicio de enlaces de conservación permanente del Laboratorio de Innovación de la Biblioteca de la Facultad de Derecho de Harvard.
Mientras Wayback Machine recorre y guarda amplias zonas de la web, en Perma.cc es la propia persona que cita quien guarda la página. Al pulsar el botón para guardarla, las bibliotecas participantes —unas 150 actualmente— se reparten la conservación de una copia del contenido de esa dirección en ese momento, y el servicio devuelve una dirección permanente que sigue abriéndose aunque la original deje de funcionar. Es la misma idea que LOCKSS, que vimos en la entrega anterior.
Toda conservación requiere el trabajo y el dinero de alguien. Internet Archive se ocupa de la mayor parte de la preservación de los registros de la web contemporánea, pero sus ingresos anuales en 2024 fueron de apenas algo más de 27 millones de dólares, un nivel comparable al de una sola empresa de tamaño mediano. Décadas de memoria de la web dependen de una aportación muy pequeña.
🧭 Para terminar
En el tercer volumen de la trilogía de Los tres cuerpos, de Liu Cixin, la humanidad, ante una crisis extrema, decide dejar en el universo un registro de su espléndida civilización. Tras darle vueltas a un método de registro que pudiera resistir cientos de millones o miles de millones de años, finalmente elige grabar letras en piedra.
Recordar siempre ha sido un trabajo. Los registros que no tuvieron monjes que los copiaran, canteros que tallaran estelas o bibliotecarios que custodiaran los depósitos ya han desaparecido y no pueden recuperarse. Lo digital parecía haber eliminado ese trabajo, pero en realidad solo lo había trasladado fuera de nuestra vista.
Zittrain cierra así su artículo de 2021:
"Society can't understand itself if it can't be honest with itself, and it can't be honest with itself if it can only live in the present moment."
Una sociedad no puede comprenderse si no es honesta consigo misma, y no puede ser honesta consigo misma si vive únicamente en el presente.
La conservación no se hace para quienes leen ahora. Se hace para el futuro. Solo llegado ese momento sabremos qué registros cobrarán importancia. Lo que podemos hacer hoy es esforzarnos por proteger el pasado.
#EntreTecnologíaYReglas #RecordarEsUnTrabajo #PreservaciónDigital #InternetArchive #DeterioroDeEnlaces #Registros