Jonathan Zittrain, évoqué dans le volet précédent et auteur de l’essai « The Internet Is Rotting » publié dans The Atlantic, est professeur à la faculté de droit de Harvard. Ses recherches portent principalement sur les rapports entre internet et le droit. Depuis plus de dix ans, il étudie les liens rompus du web en les comptant lui-même.
Un épisode l’a conduit à entreprendre ce travail.
Le 27 juin 2011, la Cour suprême des États-Unis a jugé inconstitutionnelle une loi californienne interdisant la vente de jeux vidéo violents aux mineurs. Dans cette affaire, le juge Samuel Alito a approuvé la conclusion, tout en rédigeant une opinion concordante distincte. Pour souligner la gravité de la violence dans les jeux contemporains, il a cité à l’appui plusieurs sites web qu’il avait lui-même consultés. L’un d’eux était ssnat.com.
Quelque temps plus tard, en ouvrant cette adresse, on trouvait ce texte à la place du contenu initial :
« N’est-il pas heureux que vous n’ayez pas cité cette page dans le recueil officiel des arrêts de la Cour suprême ? Si vous l’aviez fait, comme le juge Alito, le contenu d’origine aurait disparu depuis longtemps et quelqu’un d’autre aurait acheté ce domaine pour faire une remarque sur le caractère éphémère des liens à l’ère d’internet. »
« Et si vous l’aviez citée dans le New York Times, publieriez-vous un rectificatif au sujet du texte qui a changé ? »
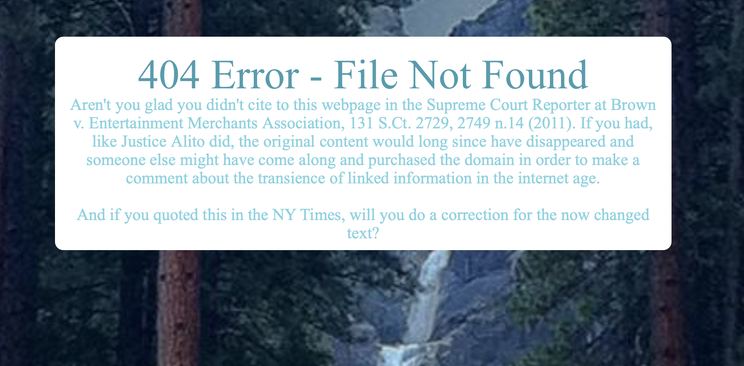
C’était une plaisanterie laissée par quelqu’un qui avait acheté le domaine arrivé à expiration. La source d’un arrêt de la Cour suprême, l’un des documents rédigés aux États-Unis pour durer le plus longtemps, n’avait même pas tenu quelques années.
Zittrain a décidé d’approfondir cette question avec ses collègues Kendra Albert et Lawrence Lessig.
🔗 Des citations impossibles à vérifier
Tous trois ont ouvert chacune des URL citées dans les arrêts de la Cour suprême fédérale depuis la première utilisation d’un hyperlien dans une décision, en 1996. La moitié ne menait plus au contenu initialement visé. Cela comprenait à la fois le pourrissement des liens (link rot), lorsque l’adresse ne donne plus accès à rien, et le pourrissement des références (reference rot), lorsque l’adresse s’ouvre, mais que le contenu cité a disparu ou a changé.
Le droit est un système construit sur des citations. Les décisions fondent leurs conclusions en citant des décisions antérieures, des textes et des documents, puis les décisions suivantes citent à leur tour ces décisions. Que la moitié de ces fondements soit devenue des adresses impossibles à consulter constituait donc une situation assez grave.
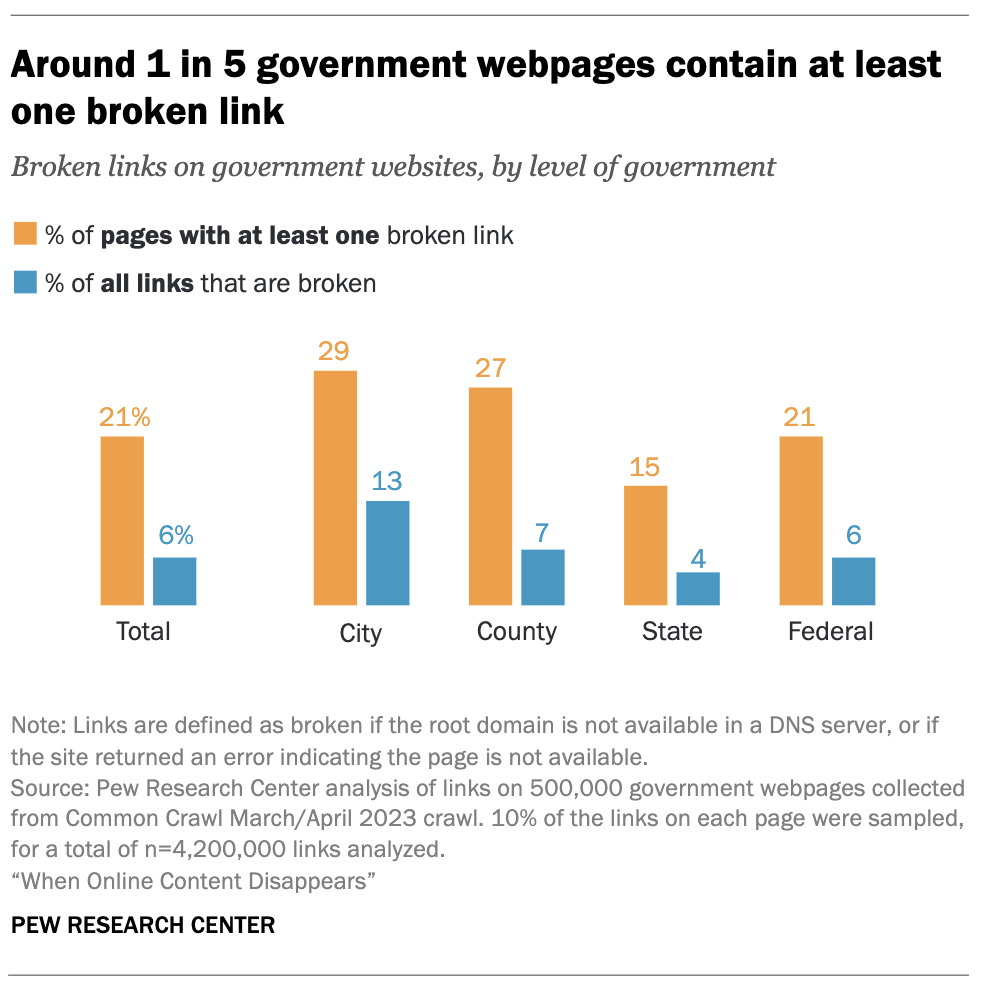
En dehors des tribunaux, la situation n’est pas différente. Le Pew Research Center a suivi les liens de 500 000 pages web du gouvernement américain, de 500 000 pages d’actualité et de 50 000 articles de Wikipédia en anglais, en prenant pour référence le printemps 2023. Au moins un lien ne s’ouvrait plus sur 21 % des pages gouvernementales et 23 % des pages d’actualité. Les grands médias ne géraient pas mieux leurs liens.
Sur Wikipédia, c’est pire encore. Parmi les liens des références, 11 % étaient morts, et 54 % des articles comportaient au moins un lien de référence mort. Autrement dit, la moitié de l’encyclopédie la plus lue au monde repose sur des sources que l’on ne peut pas consulter pour les vérifier.
🛟 Ceux qui préservent
À ce stade, le web semble s’effondrer sans remède. Mais vous souvenez-vous qu’à la fin du volet précédent, nous avions dit que bon nombre des pages qui ne s’ouvraient plus « n’avaient pas vraiment disparu » ? C’était parce que quelqu’un en avait conservé des copies quelque part sur le web.
Qui l’avait fait ? Ni un État, ni une université, ni une entreprise à l’origine du web. Il s’agissait d’une seule organisation à but non lucratif, fondée par une personne : Internet Archive, la bibliothèque numérique à but non lucratif créée par Brewster Kahle en 1996.
Wayback Machine, le service d’Internet Archive, est un dépôt de pages web : chacun peut y saisir une adresse pour consulter les versions passées d’une page, classées par date. Son robot parcourt le web, capture les pages et accumule des copies de leur état à un instant donné. En octobre 2025, ces copies auraient dépassé mille milliards de pages.
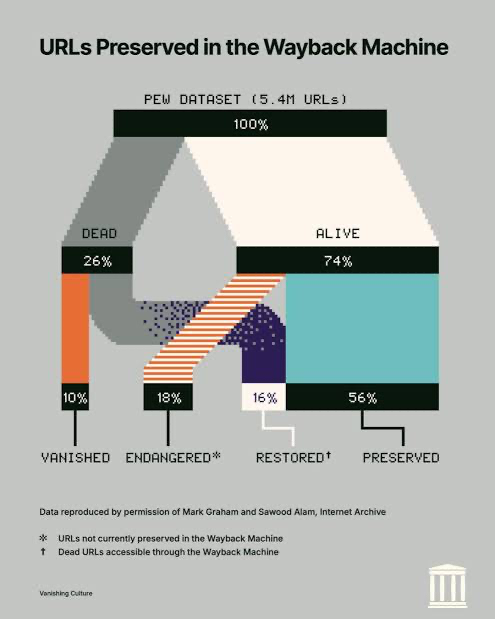
Comme nous l’avons vu à la fin du volet précédent, Wayback Machine a récupéré de nombreuses pages que le Pew Research Center avait déclarées inaccessibles. Dans la même analyse, Internet Archive a également constaté que 18 % des pages étaient encore actives, mais « à risque », car personne ne les avait encore sauvegardées. Internet Archive conclut son rapport par ces mots : « Si vous voyez quelque chose, sauvegardez-le » (See Something, Save Something).
Pour Zittrain, ce n’est pas un hasard si l’initiative est venue d’un citoyen plutôt que d’une institution existante. Aucune institution n’était prête à assumer les risques juridiques liés à la collecte et à la sauvegarde du web.
À noter qu’en Corée, une institution est chargée de cette mission par la loi. Depuis 2004, la Bibliothèque nationale de Corée collecte le web coréen sous le nom d’OASIS. Grâce à ce travail, elle avait conservé, à la fin de 2022, 2,45 millions de ressources web — comprenant des sites web ainsi que des rapports, des revues et d’autres documents publiés uniquement sur le web —, dont 1,01 million de sites web.
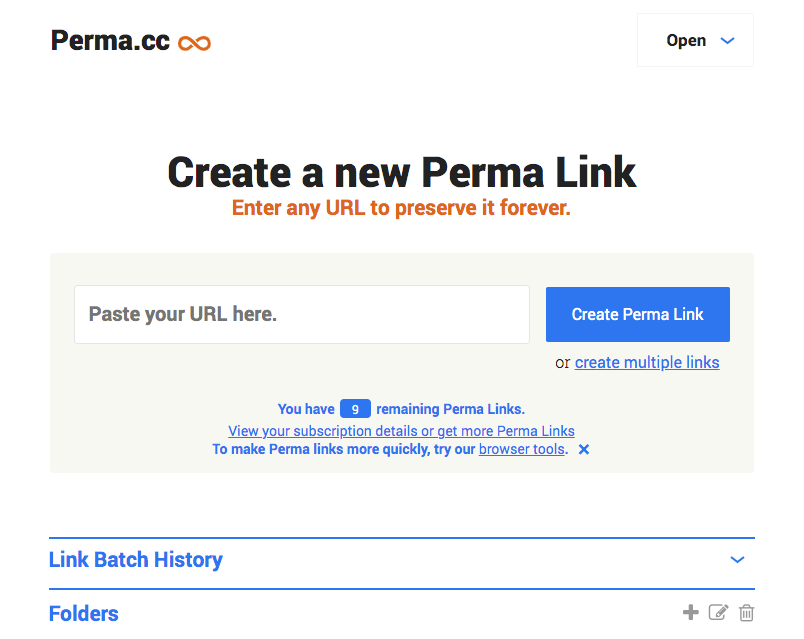
Par ailleurs, les trois chercheurs, dont Zittrain, ont proposé une solution en présentant les résultats de leur étude : Perma.cc, le service de liens de conservation permanente du laboratoire d’innovation de la bibliothèque de la faculté de droit de Harvard.
Alors que Wayback Machine parcourt et sauvegarde largement le web, avec Perma.cc, c’est la personne qui cite une page qui la sauvegarde elle-même. Lorsqu’elle appuie sur le bouton d’enregistrement, les bibliothèques participantes — environ 150 actuellement — se répartissent la conservation d’une copie de cette adresse à cet instant, et le service lui fournit une adresse permanente qui reste accessible même si l’adresse d’origine cesse de fonctionner. C’est la même idée que LOCKSS, présenté dans le volet précédent.
Toute conservation mobilise le travail et l’argent de quelqu’un. Internet Archive assume l’essentiel de la préservation des traces du web contemporain, mais ses recettes annuelles n’étaient, en 2024, que d’un peu plus de 27 millions de dollars, soit le niveau d’une seule entreprise de taille intermédiaire. Des décennies de mémoire du web reposent sur une contribution très modeste.
🧭 Pour conclure
Dans le troisième volume de la trilogie du Problème à trois corps de Liu Cixin, l’humanité, confrontée à une crise extrême, décide de laisser dans l’univers une trace de sa brillante civilisation. Après avoir longuement réfléchi à un mode d’enregistrement capable de résister à des centaines de millions, voire des milliards d’années, elle choisit finalement de graver des caractères dans la pierre.
Se souvenir a toujours été un travail. Les documents qui n’ont eu ni moines pour les recopier, ni tailleurs de pierre pour graver les stèles, ni bibliothécaires pour garder les réserves ont déjà disparu et sont introuvables. Le numérique semblait avoir supprimé ce travail ; en réalité, il l’avait simplement déplacé hors de notre vue.
Zittrain conclut ainsi son article de 2021 :
"Society can't understand itself if it can't be honest with itself, and it can't be honest with itself if it can only live in the present moment."
Une société ne peut pas se comprendre si elle n’est pas honnête envers elle-même, et elle ne peut pas être honnête envers elle-même si elle vit uniquement dans le présent.
La conservation ne se fait pas pour ceux qui lisent aujourd’hui. Elle se fait pour l’avenir. Ce n’est qu’alors que nous saurons quels documents auront pris de l’importance. Ce que nous pouvons faire aujourd’hui, c’est nous employer à protéger le passé.
#EntreTechnologieEtRègles #SeSouvenirEstUnTravail #PréservationNumérique #InternetArchive #PourrissementDesLiens #Archives