
지난번 글에서 알아본 AI 기본법은 생성물에 대한 표시 의무, 즉 '출력'에 대한 규제였습니다. 그런데 AI를 둘러싼 분쟁에는 정반대 끝에 전선이 하나 더 있죠. 바로 '입력' 쪽입니다.
AI를 학습시키는 데에 어마어마한 데이터가 필요하다는 것은 잘 알려진 사실입니다. 그런데 그 학습 데이터의 대가는 누구에게 어떻게 지불해야 하는지(혹은, 지불을 해야 하는지)에 대해서는 아직 교통정리가 되지 않았죠.
이렇게 새로운 법적 쟁점이 생길 때면, 누가 먼저 칼을 빼들지 눈치 싸움이 시작되곤 합니다. 지난 2025년 11월, 독일 법원에서 모두의 주목을 받는 판결이 나왔습니다. 그리고 2주 전인 지난 7월 31에 같은 취지의 또다른 판결이 이어졌죠. 이번 글에서는 이 두 사건을 들여다보겠습니다.
🇩🇪 첫 번째 판결 - "학습을 넘어선 재생산"
현재 ChatGPT 등의 AI 에이전트에게 특정 노래의 가사를 물어보면 어떤 대답이 나오는지 아시나요?
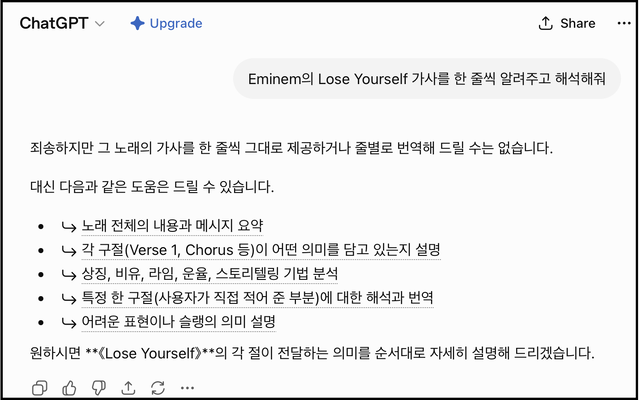
위와 같이, ChatGPT는 가사를 직접 출력해주지는 않습니다. 첫 번째 판결은 위와 같은 현상과 관련이 있습니다.
독일 음악저작권협회(GEMA)가 OpenAI를 상대로 낸 소송에서, 뮌헨 1지방법원은 챗GPT가 노래 가사를 무단으로 학습하고 그대로 출력한 행위를 독일 저작권법 위반으로 판단했습니다[1]. 다뤄진 것은 '아템로스(Atemlos)', '메너(Männer)', '구름 위에서(Über den Wolken)' 같은 독일 유명곡 아홉 곡이었습니다.
[1] GEMA v. OpenAI — 독일 뮌헨 1지방법원(LG München I) 제42민사부, 2025년 11월 11일 선고, 사건번호 42 O 14139/24. 독일 음악저작권협회(GEMA)가 GPT-4·4o의 가사 무단 학습·출력을 문제 삼은 사건.
OpenAI는 "모델은 특정 데이터를 저장하지 않고 통계적 상관관계만 학습할 뿐"이라고 항변했지만, 법원은 받아들이지 않았습니다. '○○ 노래의 후렴이 뭐야' 같은 아주 단순한 프롬프트만으로도 원곡 가사가 거의 그대로 재생산됐기 때문입니다. 법원은 이를 MP3의 손실 압축에 빗댔습니다. 원본을 통째로 담고 있지 않더라도 통계 정보만으로 원곡을 알아볼 수 있게 재현해낸다면, 그것은 복제라는 것입니다. 쟁점은 세 가지로 정리됩니다.
여기서 두 번째 쟁점의 'TDM 면책'을 잠깐 짚고 가겠습니다. TDM(Text and Data Mining, 텍스트·데이터 마이닝)이란 저작물을 자동으로 분석해 패턴이나 경향, 상관관계 같은 정보를 뽑아내는 것을 말합니다. 이 과정에서는 저작물을 복제할 수밖에 없기 때문에, 유럽은 2019년 디지털 단일시장 저작권 지침(2019/790)을 통해 이런 복제를 저작권 침해로 보지 않는 예외를 두었고, 독일은 이를 저작권법 제44b조로 받아들였습니다[2].
다만 제44b조는 복제를 허용하면서도, 단서에서는 그 복제물이 마이닝을 위해 더 이상 필요하지 않게 되면 삭제하도록 규정하고 있습니다. 즉 이 면책은 '분석하는 동안'을 위한 것이지 '분석이 끝난 뒤에도 계속 지니고 있는 것'까지 허용하지는 않는다는 뜻입니다. 그런데 AI 모델은 학습이 끝난 뒤에도 그 내용을 파라미터 안에 담은 채 서비스를 이어간 것이며, 법원은 이 지점에서 면책을 인정하지 않았습니다.
최종적으로, 법원은 OpenAI에 침해 행위의 중단과 함께, 그동안의 사용 범위와 그로 얻은 수익을 공개하고 손해를 배상하라고 명령했습니다(위반 시 1회당 25만 유로의 이행강제금).
🇩🇪 두 번째 판결 - 가사에서 멜로디로
그리고 지난 7월 31일, 같은 재판부가 한 걸음 더 나아갔습니다. 이번 상대는 AI 음악 생성 서비스인 수노(Suno)입니다[2].
[2] GEMA v. Suno — 독일 뮌헨 1지방법원 제42민사부, 2026년 7월 31일 선고, 사건번호 42 O 763/25. GEMA가 2025년 1월 제소한 사건으로, 법원은 금지·정보제공·손해배상 청구를 대부분 인용했다. 대상 저작물은 '아템로스 두르히 디 나흐트', '라스푸틴', '빅 인 재팬', '포에버 영', '맘보 넘버 5'의 후렴, '대디 쿨' 여섯 곡이다. 판결은 아직 확정되지 않았다.
GEMA는 수노의 결과물이 멜로디·화성·리듬에서 원곡과 상당 부분 일치한다는 점을 입증했고, 재판부는 이를 받아들였습니다. AI가 생성한 오디오 콘텐츠를 정면으로 다룬 사실상 최초의 (공개된) 판결입니다.앞선 사건이 '가사', 즉 텍스트를 다뤘다면 이번엔 '음악 그 자체'가 대상이었습니다.
흥미로운 건 수노의 방어 전략이었습니다. 수노는 GEMA 레퍼토리로 학습했다는 사실 자체는 이미 인정하고 있었습니다. 다만 그것이 대가를 지불해야 할 일은 아니라고 다퉜을 뿐이죠. 학습 데이터를 유튜브에서 이른바 '스트림 리핑'으로 내려받았다는 점도 다툼이 없었습니다.
법원은 이 주장에 분명히 선을 그었고, TDM 면책도 다시 한번 배척됐습니다. 수노가 저작물을 단순히 분석한 것이 아니라 모델에 영구히 저장해 서비스의 기능으로 활용했다는 이유였습니다. 8개월 전 OpenAI 판결에서 나온 좁은 해석이 그대로 이어진 셈입니다.
⚖️ 관할 문제는 어떻게?
이 판결에서 또다른 중요한 대목이 있습니다. 바로 '어디서 학습했는가'입니다.
수노는 미국 회사이고, 학습도 미국에서 이뤄졌습니다. 이것은 그동안 AI 기업들에게 이는 꽤 든든한 방어선이었습니다. 유럽에서 서비스를 하더라도 학습 자체는 유럽 밖에서 벌어진 일이니 유럽 법으로 따질 수 없다는 논리죠.
실제로 이 논리는 통한 적이 있습니다. 지난해 11월 4일 영국 고등법원의 게티이미지 대 스태빌리티 AI 판결이 그렇습니다[3]. 이 사건에서 게티이미지는 학습이 영국 밖에서 이뤄졌다는 점을 인정하면서 핵심이었던 저작권 침해 주장을 재판 도중 스스로 철회해야 했고, 남은 주장마저 기각되면서 워터마크와 관련된 극히 제한적인 상표권 침해만 인정받았습니다.
[3] Getty Images v. Stability AI — 영국 고등법원(잉글랜드·웨일스), 2025년 11월 4일 선고, [2025] EWHC 2863 (Ch), 조애나 스미스 판사. 유럽 최초의 AI 저작권 판결이라 주목받았지만, 관할 등의 문제로 정작 'AI 학습이 침해인가'라는 핵심 질문에는 답하지 못함.
하지만 이번 뮌헨 법원 판결로 인해 AI 기업들은 안심할 수 없게 되었습니다. 이 사건에서 독일 법원은 학습이 미국에서 이루어진 것과는 별개로, 독일에서 모델을 제공하고 그 산출물을 내보낸 부분에 대해서는 독일 저작권법 위반을 인정했기 때문입니다. 이는 EU 밖에서 전적으로 이뤄진 AI 학습이 독일에서의 저작권 책임을 낳을 수 있다고 본 첫 유럽 판결입니다. 실제로 두 번째 사건에서 판결 주문은 수노에게 '음악 생성 AI 모델의 학습을 목적으로 미국 영토 내에서 해당 저작물을 복제하는 행위'를 중단하라고 명시했습니다.
그래서 이 판결의 의미는 훨씬 큽니다. 학습은 규제가 느슨한 미국에서 하고 서비스 제공만 유럽에서 하면 된다는 전략이, 적어도 독일에서는 더 이상 통하지 않게 되었다는 뜻이니까요.
다만 맹점이 완전히 해소된 것은 아닙니다. 법원이 미국에서의 학습까지 판단할 수 있었던 근거는 저작권관리단체법(VGG)이 GEMA 같은 집중관리단체에 부여한 특별 재판적이었습니다. 개별 권리자가 같은 판단을 받을 수 있을지, 관할 결정의 주요 요소인 '침해지'를 어떻게 볼지, 그리고 무엇보다 독일 판결을 미국에서 실제로 승인·집행할 수 있을지의 문제는 여전히 남아 있습니다.
🧭 마무리
엄밀히 말하면, 위 판결들은 AI의 학습에 대가나 책임을 물었다기보다는, 학습이나 분석이 끝난 뒤에도 원본이 모델 파라미터 안에 재현 가능한 형태로 남아 있는가를 중심으로 침해를 판단한 것입니다.
다만 개인적인 생각으로는, AI 학습에 대한 적절한 대가 또는 그 피해액을 제대로 산정하는 것이란 너무나 어렵기 때문에, 앞으로도 논의는 상대적으로 명확하고 확인이 쉬운 출력과 재생산 여부를 중심으로 계속 이루어지지 않을까 합니다.
무엇보다, AI의 '학습'이라는 것은 정확히 무엇일까요? 저작물을 읽어들이는 행위그 자체일까요, 그 과정에서 만들어진 가중치의 묶음일까요? 이것은 인간의 학습과는 얼마나 같고 또 얼마나 다를까요? 이것을 우리가 지금까지 쌓아온 법적 개념들 가운데 어떤 것과 대응시켜야할까요?
소개한 위 두 사건은 아직 끝나지 않았습니다. OpenAI는 "AI의 작동 방식을 오해한 판단"이라며 항소했고 수노 판결도 아직 확정되지 않았기 때문에, 사안은 상급심이나 유럽사법재판소(CJEU)까지 이어질 수 있습니다. 앞으로 어떤 결과가 나올지는 아마 모두가
다음 편에서는, AI 산업의 중심에 있는 미국에서는 AI 학습과 관련해 어떤 주요 사건들이 있었는지 알아보겠습니다.
#기술과제도사이 #AI저작권 #GEMA #OpenAI #TDM #생성형AI