지난 편에 등장한 조너선 지트레인(애틀랜틱의 에세이 「The Internet Is Rotting」 저자)은 하버드 로스쿨 교수입니다. 인터넷과 법의 관계를 주로 연구하는 그는 10년 넘게 웹의 링크가 얼마나 끊겨 있는지를 직접 세며 조사를 해왔습니다.
그가 이 일을 시작한 계기가 된 사건이 하나 있습니다.
2011년 6월 27일, 미국 연방대법원은 폭력적인 비디오게임을 미성년자에게 팔지 못하게 한 캘리포니아 주법이 위헌이라고 판결했습니다. 이 사건에서 새뮤얼 알리토 대법관은 결론에는 동의하면서 따로 보충의견을 써냈습니다. 그는 요즘 게임 속 폭력이 얼마나 심한지 강조하며 직접 찾아본 웹사이트들을 근거로 달았는데, 그중 하나가 ssnat.com이었습니다.
얼마 뒤 이 주소를 열어보니, 원래 내용 대신 이런 글이 떠 있었습니다:
"이 페이지를 연방대법원 판례집에 인용하지 않으셨다니 얼마나 다행입니까? 알리토 대법관처럼 인용했다면, 원래 내용은 진작 사라지고 다른 누군가가 이 도메인을 사들여 인터넷 시대 링크의 덧없음에 대해 한마디 하고 있었을 테니까요."
"그리고 이걸 뉴욕타임스에 인용하셨다면, 바뀌어 버린 문구에 대해 정정 보도는 해 주실 건가요?"
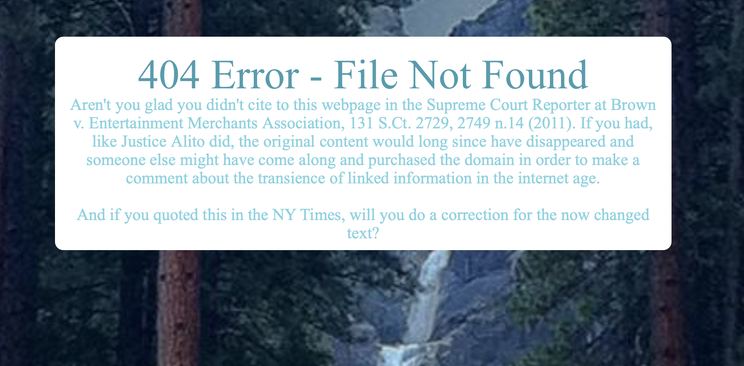
누군가 만료된 도메인을 사들여 남긴 장난이었습니다. 미국에서 가장 오래 남도록 쓰이는 문서 중 하나인 대법원 판결문의 근거가, 몇 년도 버티지 못한 것입니다.
지트레인은 동료 켄드라 앨버트, 로런스 레식과 함께 이 문제를 더 조사해보기로 했습니다.
🔗 확인할 수 없는 인용
세 사람은 1996년 판결문에 하이퍼링크가 처음 쓰인 이래, 연방대법원 판결문에 인용된 URL을 전부 눌러 봤습니다. 절반이 원래 가리키던 내용으로 연결되지 않았습니다. 여기에는 주소를 눌러도 아무것도 나오지 않는 경우를 의미하는 링크 부패(link rot)와, 주소는 열리는데 인용했던 내용이 사라졌거나 바뀐 경우를 의미하는 참조 부패(reference rot)가 모두 포함됩니다.
법은 인용 위에 쌓이는 체계입니다. 판결문은 앞선 판결과 법령과 자료를 인용해 결론의 근거를 대고, 다음 판결은 다시 그 판결문을 인용합니다. 그런데 그 근거의 절반이 가 볼 수 없는 주소가 되어 있으니, 이건 상당히 심각한 상황이었습니다.
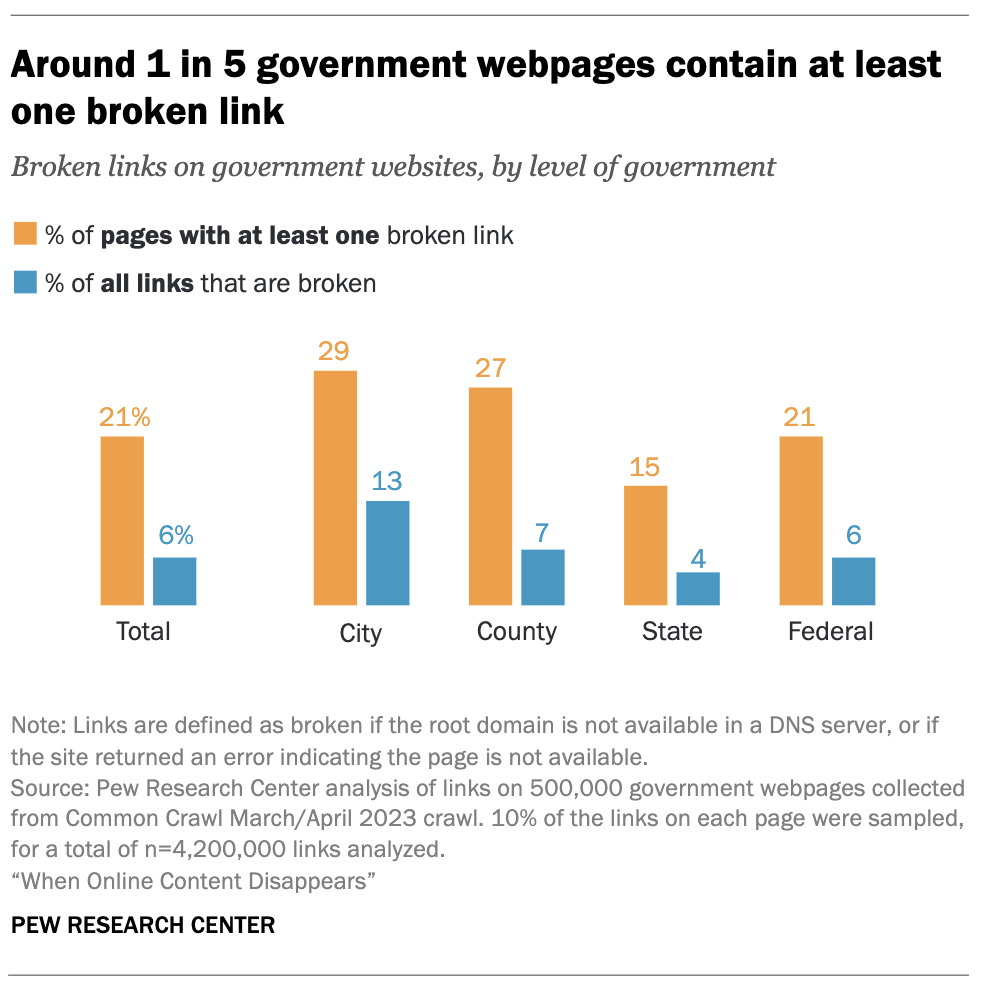
법원 밖도 다르지 않습니다. 퓨리서치센터는 2023년 봄 기준 미국 정부 웹페이지 50만 개와 뉴스 웹페이지 50만 개, 영어 위키백과 문서 5만 개의 링크를 따라가 봤습니다. 정부 페이지의 21%, 뉴스 페이지의 23%에 열리지 않는 링크가 하나 이상 있었습니다. 큰 매체라고 링크를 더 잘 관리하지는 않았습니다.
위키백과는 더 심합니다. 참고문헌 링크의 11%가 죽어 있었고, 문서의 54%에 죽은 참고 링크가 하나 이상 있었습니다. 세상에서 가장 많이 읽히는 백과사전의 절반이, 가서 확인할 수 없는 근거에 기대고 있는 셈입니다.
🛟 남기는 사람들
여기까지 보면 웹은 손쓸 수 없이 무너지는 중인 것 같습니다. 그런데 지난 편 끝에서, 열리지 않던 페이지 중 꽤 많은 수가 '진짜로 없어지진 않았다'고 했던 것 기억나시나요? 이것은 누군가 웹 어딘가에 그 사본을 저장해두고 있었기 때문입니다.
그 주체는 누구였을까요? 국가도, 대학도, 웹을 만든 회사도 아니었습니다. 한 사람이 세운 비영리 단체 한 곳이었습니다. 바로 1996년 브루스터 케일이 세운 비영리 디지털 도서관, 인터넷 아카이브(Internet Archive)입니다.
인터넷 아카이브의 웨이백 머신(Wayback Machine) 서비스는 웹페이지 저장소로, 누구든 주소를 넣으면 그 페이지의 지난 모습을 날짜별로 볼 수 있습니다. 웨이백 머신의 크롤러는 웹을 돌며 페이지를 긁어 그 시점의 사본을 쌓아 두고 있죠. 그렇게 쌓은 사본이 2025년 10월 1조 페이지를 넘었다고 합니다.
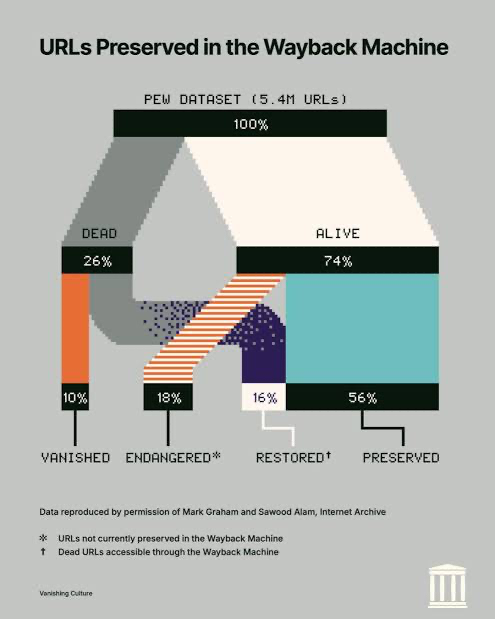
지난 편 끝에서 본 대로, 퓨리서치센터가 열리지 않는다고 한 페이지 중 다수를 웨이백 머신이 건져냈습니다. 같은 분석에서, 인터넷 아카이브는 살아 있지만 아직 아무도 저장하지 않은 '위험' 상태의 페이지도 18%임을 확인하였습니다. 인터넷 아카이브는 "보이면 저장하라(See Something, Save Something)"는 말로 보고서를 마무리합니다.
지트레인은 기존 기관이 아니라 시민 한 사람이 나선 것이 우연이 아니라고 봅니다. 웹을 긁어 저장하는 일의 법적 위험을 감수할 기관이 없었다는 것이죠.
참고로, 한국에는 이 일을 법으로 맡은 기관이 있습니다. 국립중앙도서관은 2004년부터 OASIS라는 이름으로 한국 웹을 수집해 왔습니다. 이로부터 국립중앙돋서관은 2022년 말까지 웹사이트 101만 건을 포함하여 웹자료(웹사이트 및 웹에만 올라온 보고서와 학술지 등 포함) 245만 건을 보존했습니다.
한편, 지트레인 등 세 사람이 조사 결과와 함께 제안한 해결책도 있습니다. 하버드 로스쿨 도서관 혁신연구소의 영구 보존 링크 서비스 Perma.cc입니다.
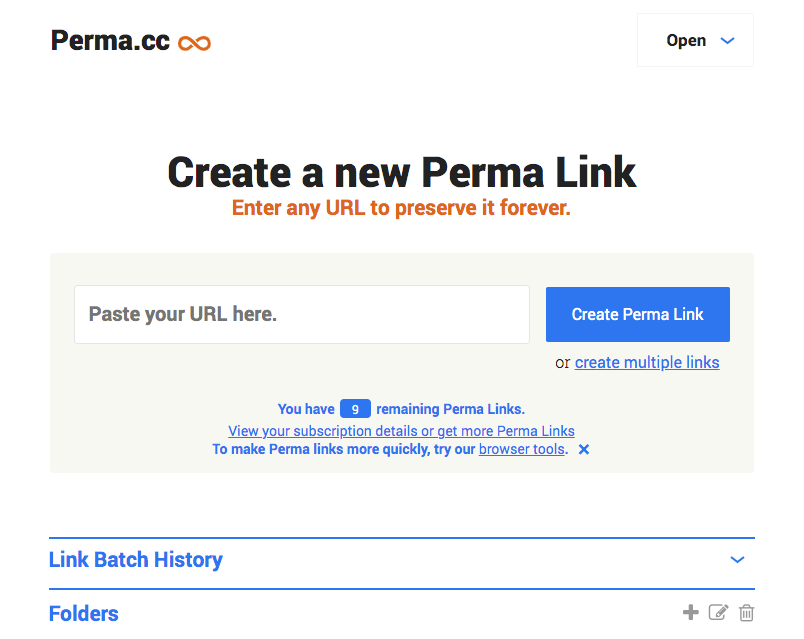
웨이백 머신이 웹을 넓게 훑으며 저장한다면, Perma.cc는 인용하는 사람이 직접 저장합니다. 인용하는 사람이 페이지 저장 버튼을 누르면, 해당 주소의 해당 시점의 사본을 참여 도서관(현재 약 150곳)들이 나누어 보관하고, 원래 주소가 죽어도 열리는 영구 주소를 돌려주는 방식입니다. 지난 편의 LOCKSS와 같은 발상입니다.
남기는 일은 전부 누군가의 손과 돈입니다. 인터넷 아카이브는 현대 웹 기록 보존의 대부분을 책임지고 있지만, 이들의 한 해 수입은 2024년 기준 2,700만 달러 남짓, 중견 기업 한 곳 수준에 불과합니다. 수십 년치 웹의 기억이 아주 작은 대가에 기대고 있는 것입니다.
🧭 마무리
류츠신의 『삼체』 3부에서, 절체절명의 위기를 마주한 인류는 찬란했던 인류 문명의 기록을 우주에 남기기로 합니다. 수억, 수십억 년을 버틸 수 있는 기록법을 두고 골몰하던 인류가 결국 택한 방법은, 돌에 글자를 새기는 것이었습니다.
기억은 원래 노동이었습니다. 필사하는 수도사, 비석을 깎는 석공, 서고를 지키는 사서가 없었던 기록들은 이미 사라져 찾을 수 없습니다. 디지털은 그 노동을 없앤 것처럼 보였지만 사실은 눈에 안 보이게 옮겨 두었을 뿐이었습니다.
지트레인은 2021년 글을 이렇게 맺습니다.
"Society can't understand itself if it can't be honest with itself, and it can't be honest with itself if it can only live in the present moment."
사회는 자신에게 정직하지 않으면 자신을 이해할 수 없고, 현재에만 산다면 자신에게 정직할 수 없다.
보존은 지금 읽는 사람을 위한 일이 아닙니다. 미래를 위한 일이죠. 어떤 기록이 중요해질지는 그때 가서야 알 수 있습니다. 지금 할 수 있는 것은, 열심히 과거를 지키는 것입니다.
#기술과제도사이 #기억은노동이다 #디지털보존 #인터넷아카이브 #링크부패 #기록