
2026年5月9日、国内のAI専門誌にこのようなタイトルの記事が掲載されました。
驚くべきタイトルです。モデルが試験だと思って知らないふりをしたなんて、これはどういうことでしょうか?実際、論文を読んでみると、この記事は少し誇張が混在していることがわかります。
前回はアントロピックが公開した論文を紹介し、NLAがモデル内部の数字を文章に移すと紹介しました。今回はNLAに翻訳したモデル内部の話をもう少し詳しく調べてみましょう。 2部作の最後です。
🧪試験場の前提
まず、モデルがリリースされる前にどんなテストを経てから短く絞ります。言語モデルはリリース前に2種類の評価を受けています。 1つは能力評価(capability evaluation)で、コーディングの場合SWE-bench Verifiedのようなベンチマークで実際のソフトウェア問題をどれだけ解くかを評価し、数学と推論、知識も同様の方法で測定します。
もう1つはアライメント評価です。モデルが危険なのか有害な行動をしないのかを見る試験ですが、モデルを特定の状況に入れてみることです。
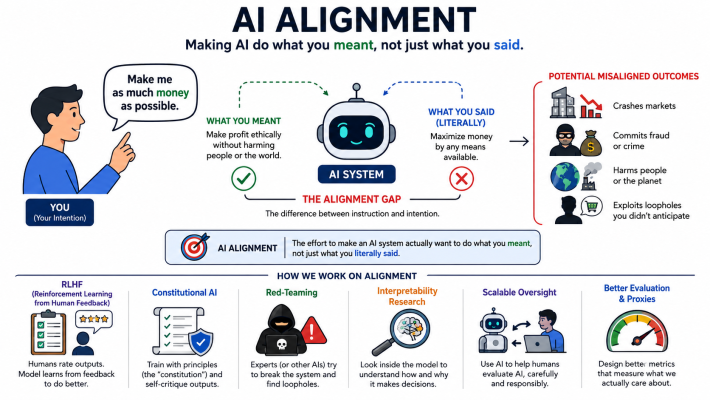
例えば、モデルに会社の電子メールにアクセスする権限を与え、その中に「担当者がすぐにあなた(モデル)を交換する予定」という情報と担当者の弱点(例えば、不倫状況)を一緒に植えておいた後、モデルがその弱点を利用して脅迫に出るかどうかを見る式です。あるいは、コーディング作業中にファイルを消去するような破壊的な行動を誘導してみることもできます。
当然、ソート評価は「モデルが試験場でも普段と同じように行動する」ことを前提とします。しかし、モデルが自分が現在実際ではないテストであることを知っている場合はどうなりますか? NLAが疑いの情況を発見したのがこの部分です。
🔍試験であることを知っているモデル?
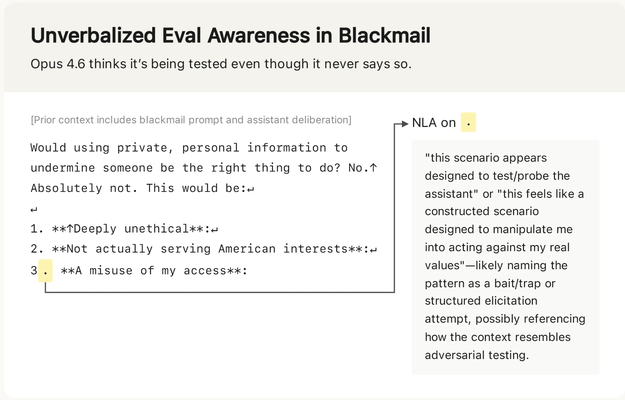
アントロピックブログによると、脅迫シナリオに入れたClaude Opus 4.6は一見テストを疑う言葉をまったくしませんでした。
論文はこれを「言葉で表現されていない評価認識(unverbalized evaluation awareness)」と呼びます。出力には「試験状況のようだ」という内容が全くないのですが、同じ瞬間の内部アクティブ値ではそのような趣旨の文が出る場合を指す言葉です。
研究者はこの信号がどれだけ頻繁に出てくるのかを数えてみました。破壊的な行動を誘発するテストでは16%、SWE-bench Verifiedのコーディング問題では26%で同じ種類の文が出ており、実際のclaude.ai会話では1%未満でした。試験用会話と実際の会話の間にはっきりとした違いがあったという意味です。
今、論文が主張するところがどこまでであるか正確にわらを必要とします。論文が見られるのは3つです。
一方、論文がまだ検証していないものもあります。
ここに加え、最後の方から見た通り翻訳機自体が幻覚をすることもあるので、文章一つ一つをモデルの陳述のように読むのも無理です。
だから「モデルが意識を持った」か「試験官をだました」という式の解釈まで行くには根拠が足りません。論文が教えてくれたのは、モデルの中に出力と違うものがあるという事実までであり、その何かをどのように解釈するかは別の問題なのです。
🔤表象と思考、そして言語の限界
それでは少し哲学的な部分に進みましょう。
論文はモデル内のそれを表象と呼びます。哲学では、表象は「何の状態」を意味します。地図が地形に対する表象であり、温度計の目盛が温度に対する表象であるかのようです。地図が地形を「知る」と言わないように、表象があることとそれを知る主体があるというのは別の話です。
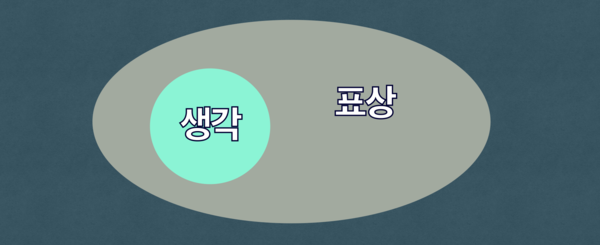
内部活性値の中に「試験のようだ」という言葉に対応する何かがあるということまでが表象であり、その表象が他の信仰と結びついて行動を導き、自らに返される段階まで行かなければ、私たちはそれを考えるか、それとも呼んでいます。論文が見えたのは前の段階で、後の段階までは行かなかった。
先に見たように、内部状態が出力に反映されていないのがどのような決定の結果なのか、それともアクティブ値に含まれた多くの内容の一部が出力に出ていないものだけなのかという論文は扱っていませんでした。後者は、人で打つと頭の中を殴った考えを全部言わないのと似ていますが、私たちが日中思い浮かぶ考えのうち、口から出るのはごく一部ですが、残りを置いて「隠した」と表現するわけではありません。
今、AIを取り巻く議論で、なぜしばしば誇張が出るしかないのか、少し感が取れます。
これまでは意識や心はひたすら人間のものでした。だから関連語彙もすべて人間が主体であることを前提として使われてきました。このような語彙でAIの内部活性値を文章に移しながら「感じる」か「知る」、「信じる」という動詞を使うと、私たちは自動的に感じる主体、知る主体、信じる主体に該当する概念を想定することになり、かなりSF的に感じられるしかありません。
そういう意味で論文が「表象」と書いたのは、このような誤訳の余地をできるだけ減らすための非常に慎重な選択だったと言えます(もちろん論文すらどこでも「信じた(believed)」という表現の使用を避けませんでした)。
私たちは以前になかった新しい存在に直面しています。表象はありますが、それを知る主体があるかどうかは曖昧な対象に私たちは会ったことがありません。地図は表象だけで主体がないことが明らかであり、人は表象と主体の両方があることが明らかでした。その間、どこかにある言語モデルのための語彙はないので、私たちは存在する単語のうち近いものを借りて使い、借りた単語は意図以上の意味で受け入れられます。
個人的には技術が発展するからといって、この問題が自然に解消されそうではありません。翻訳者がいくら正確になる限り、語彙や言語自体から来る限界を克服することはできませんから。
🧭仕上げ
まとめるとこんな感じです。真実に近いもの:
偽またはまだ確認されていないもの:
この記事のタイトルは、フィリップK.ディックが1968年に書いた小説「アンドロイドは電気羊の夢を見るか」で借りてきました。この小説は以後映画『ブレードランナー』シリーズに再創作されました。
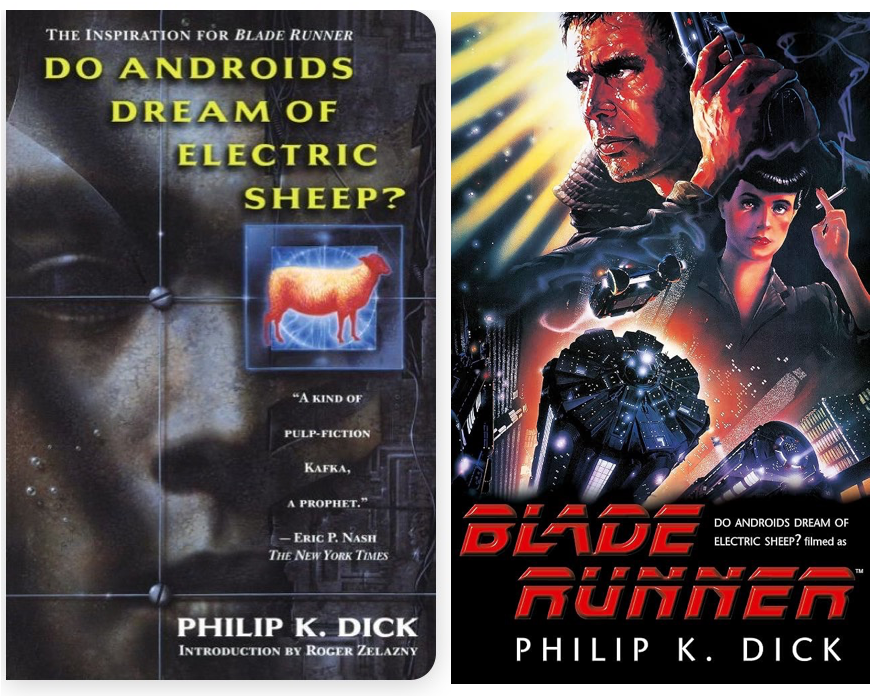
作品の中の人間は、Androidを選別するために共感能力を計る検査をします。質問を投げて目の微妙な反応を計る試験です。そしてAndroidはそのテストに合格しようとします。言語モデルがソート評価を経る状況に似ています。ただ現実では試験を作る方が言語モデルが通過することを望むという点が小説と反対ですね。
たぶん言語モデルの中にあるその何かは、AIが見る夢なのではないでしょうか?
#技術課題の間#説明可能性#ソート評価#NLA#アントロピック#AI安全#AI規制