有一种职业,叫作数字殡葬师。
当委托人提出想要删除的文字、照片和视频时,他们会在互联网上将其找出来并删除;如果删不掉,就设法让它们至少不再出现在搜索结果中。委托内容从深度伪造合成物到想要隐藏的过去,五花八门。费用约从每条帖子5万韩元起,但随着难以删除的网站增多,据说如今已经是“漫天要价”。
删除内容甚至成了一种职业,可见我们一直相信互联网是一个“永久定格、供人围观的空间”。
然而,皮尤研究中心(Pew Research Center)在2024年5月发布的报告《When Online Content Disappears》,指出了互联网出人意料的一面:2013年存在的网页,有38%在10年后已经无法打开。
一边是花钱雇人删除,另一边却是每10个网页中就有4个无人碰过便自行消失,这究竟是怎么回事?
🧹 “被遗忘权”的诞生
西班牙律师马里奥·科斯特哈·冈萨雷斯在1998年因社会保障债务,住房被查封并交付拍卖。《先锋报》(La Vanguardia)刊登了这则公告。
科斯特哈不久便还清了债务,但此后10多年,只要在Google输入他的名字,这则公告就会排在最前面。于是,他在2010年向西班牙数据保护局(AEPD)投诉了报社和Google。数据保护局认为报纸公告是依法刊登的,因此允许保留,但决定要求Google从搜索结果中删除该链接。
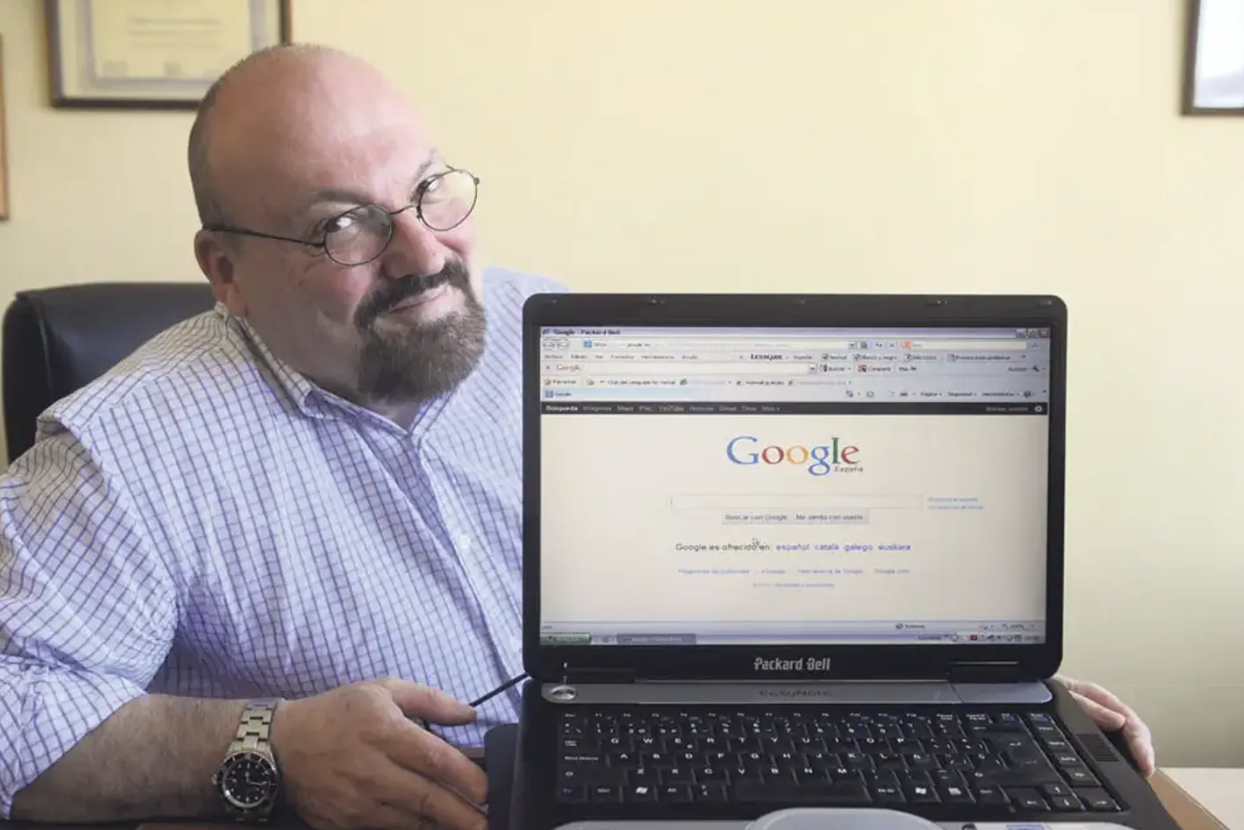
Google不服并提起诉讼后,西班牙法院认为该问题取决于对欧盟法律的解释,便请求欧洲法院作出判断。2014年5月13日,欧洲法院认定,搜索引擎同样有义务删除这类搜索结果。由此,“被遗忘权”一词传遍了世界[1]。
[1] Google Spain SL, Google Inc. v. AEPD, Mario Costeja González——欧盟法院(CJEU)大审判庭,2014年5月13日判决,案号C-131/12。法院将搜索引擎运营者视为个人数据处理的控制者,认定即便原始文章合法保留,仍可要求删除“不适当、不再相关或过度”的搜索结果。2018年生效的欧盟《通用数据保护条例》(GDPR)第17条将其明文规定为“删除权(被遗忘权)”。
韩国也有同样的关切。2016年6月,韩国广播通信委员会实施了被媒体称为“韩国版被遗忘权”的《互联网本人发布内容访问屏蔽请求权指南》。这是一套自律规范:当自己无法直接删除自己发布的帖子时,可以请求门户网站等经营者将其屏蔽,不让他人看到。
自2023年4月起,韩国个人信息保护委员会还在运营俗称“橡皮擦服务”的制度,代为请求删除当事人在未成年时期自行发布的帖子。
就这样,过去10年里,我们担心的是“如果删不掉怎么办”。几乎没有人担心“如果留不下来怎么办”。
📉 10年后,38%消失了
皮尤研究中心从非营利网页存储库Common Crawl中,随机抽取了2013年至2023年每年约9万个网页,总数近100万个。随后在2023年10月,逐一重新访问了这些地址。
结果如何?总数的25%无法打开。年代越久的网页消失得越多:2013年存在的网页有38%无法访问,2021年的网页仅过了两年就有约20%无法访问,2023年的网页也有8%无法访问。
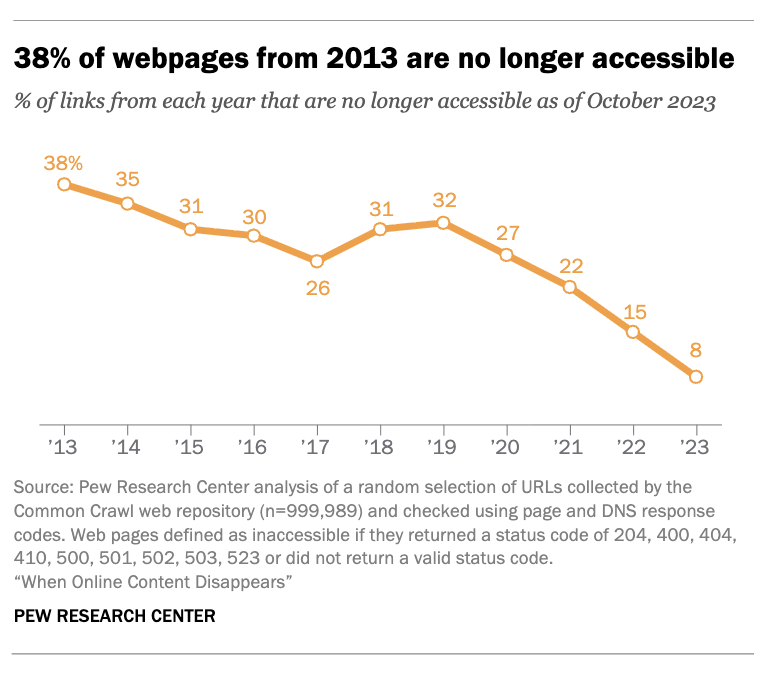
这个数字还是保守估计。皮尤研究中心只把明确表明服务器或页面不存在的错误计为“无法访问”;如果地址仍然有效但内容发生了变化,或者因屏蔽机器人而无法打开,都算作“可以访问”。所以,无法从原地址正常打开的网页,应该还要更多。
🔨 网页如何死去
网页消失的原因多种多样,有时连整个域名都会消失。这通常发生在公司关门,或者没有人再支付每年的域名续费和服务器费用时。
不过,在前述25%中,比起因这些原因消失的网页(9%),网站所有者仍然存在、却只有网页消失的情况(16%)更多。这通常发生在所有者调整网站时。
网站改版或更换论坛程序后,即便帖子原封不动地迁移过去,地址结构也会改变。此时,如果遗漏了将旧地址转向新地址的设置(重定向),外部指向它们的链接就会全部断开。而对于负责改版的一方来说,这项设置的优先级,往往远远排在新网站上线之后。
有些内容消失不是因为改版,而是因为清理。Google从2009年起运营短网址服务goo.gl,将很长的网址缩短成goo.gl/ABC12x这样的形式。到了2024年7月,Google宣布将从次年8月25日起停用所有链接。理由是,在2024年6月整整一个月里,99%的链接都没有任何活动。
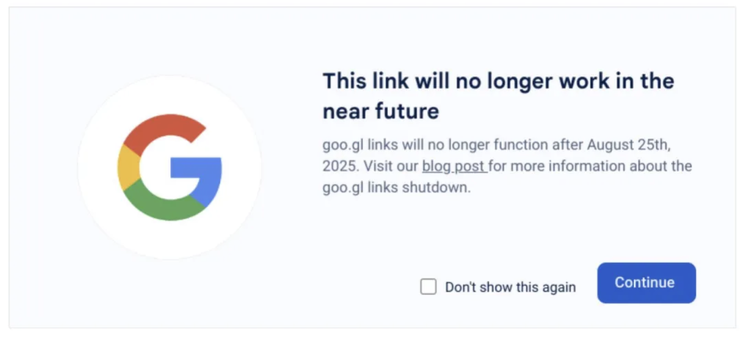
有人质疑,嵌在文档、视频和帖子各处的链接该怎么办。面对反对声音,Google在距服务终止仅剩三周多时,改为决定“保留部分链接”:只停用2024年年底无人点击的链接。因此,goo.gl域名至今仍可运作,保留下来的链接会转到原网页,其余链接则已经断开,只会显示错误页面。
总的来说,很多网页的消失,并不是因为有人想删除它们,而是在网站改版和削减成本的过程中发生的。
🏚️ 只剩地址的图书馆
哈佛法学院的乔纳森·齐特林在2021年发表于《大西洋月刊》的文章《The Internet Is Rotting》中,将网络比作“没有图书馆,每个人把书放在自己家里,只分享地址的体系”。到2021年再去拜访一个2015年登记的地址,发现书不在了,也没什么奇怪。
之所以如此,原因在于互联网的建造方式。设计互联网的学者既没有钱像建设电话网络或配送网络那样,亲自铺设一个庞大的网络,也没有想过靠它赚钱。于是,他们只制定了将既有网络相互连接的规则,互联网并没有因此产生运营公司或管理组织。在其上创建万维网的蒂姆·伯纳斯-李,也免费公开了协议。
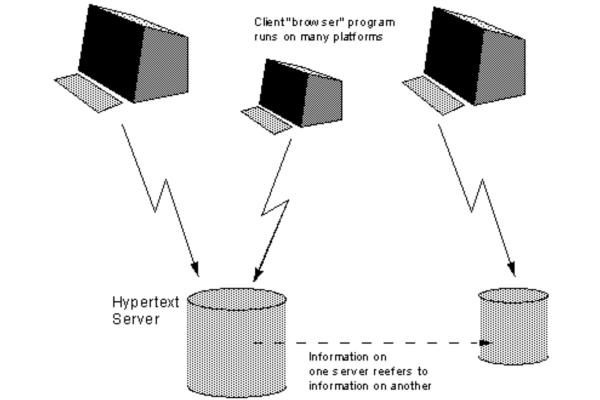
既然不收费,就不需要有公司记录谁在使用什么,也不需要有一个俯瞰整个网络的中央机构。链接不过是写下对方网页的地址,所以可以指向世界上任何一台服务器;然而,那台服务器的所有者甚至不知道谁给自己的网页加了链接。
伯纳斯-李也意识到了这一点,因此在1998年的文章《好的地址不会改变》(Cool URIs don’t change)中,呼吁不要更改地址。不过,他并未加入阻止地址变更的机制。
并不是没有其他设计。早在万维网问世前数十年,特德·纳尔逊构想的Xanadu,就连“双向链接”也规划在内:建立链接后,被链接的一方也会获知。这是从一开始就想建立不会断开的链接。
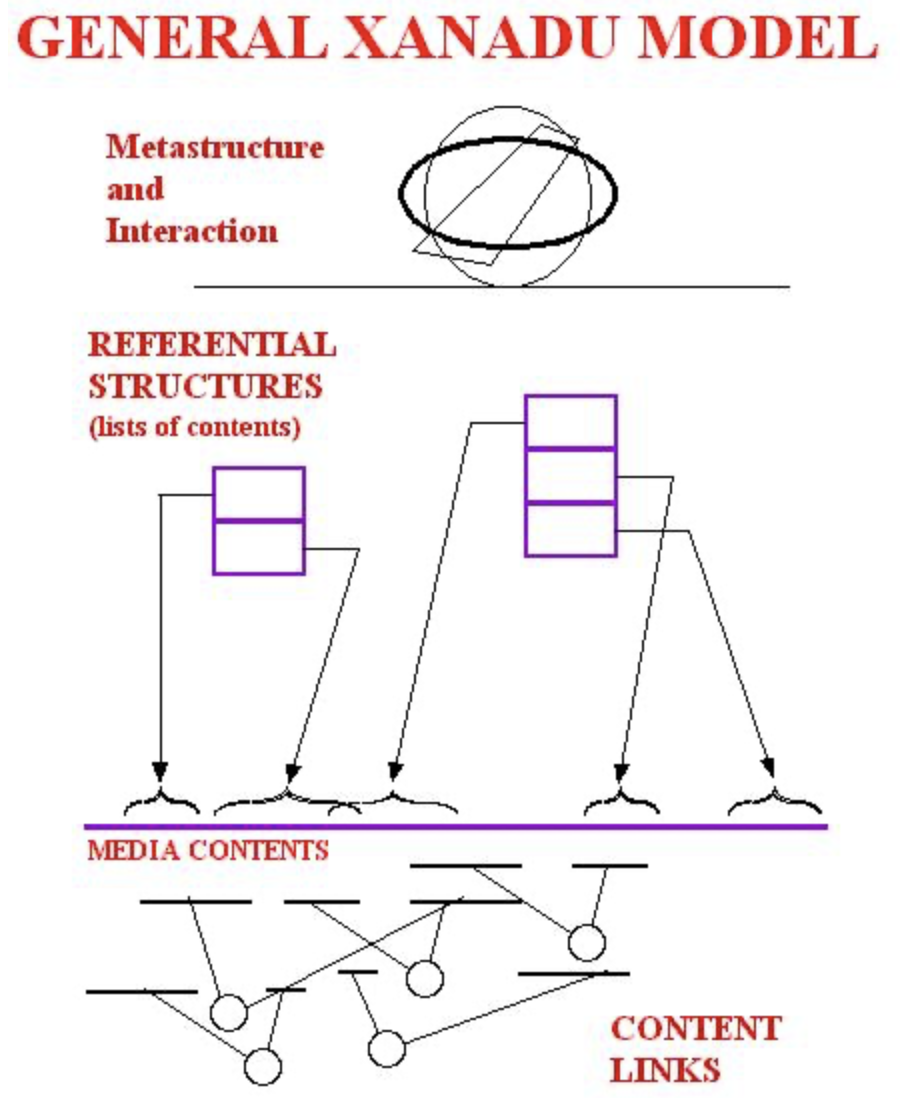
然而,Xanadu试图从一开始就兼顾版本管理和版权费结算等所有事情,几十年过去也没能真正完成。纳尔逊后来批评,万维网用“单向、总是断开的链接”把超文本变得微不足道。但最终存活下来的,却是不完美、至少能运作的万维网。
齐特林把互联网和万维网的这种设计态度称为“拖延原则”(Procrastination Principle):不为了提前解决未来可能出现的所有问题而让设计变得笨重,而是等问题出现后再去解决。因此,网站的出现与消失、网页的迁移,都不是缺陷,而是有意为之的特性。
🫥 责任的空白
拖延原则成功了。不需要许可、也不需要管理员的万维网,比任何其他网络发展得都更快。然而,代价是出现了“维护他人所依赖内容的责任空白”。毕竟,房主只要顾好自己的书就行,而防止别人家里的书消失,并不是任何人的义务。
这种空白平时并不显眼,却会在运营者撒手的瞬间显现。派拉蒙在2023年5月撤销了MTV News部门,又在一年多后的2024年6月关闭了网站。自1996年起积累的文章地址,一夜之间全部跳转到了MTV首页。派拉蒙表示文章保存在公司内部,但外界已经无法打开。
同年1月,创刊仅8个月便关门的新闻初创公司The Messenger,在宣布停刊几小时后就清空了网站。留下的只有名称和电子邮件地址。
出人意料的是,新闻机构并没有为妥善保存文章投入太多精力。哥伦比亚大学陶氏中心(Tow Center)在2019年调查了21家新闻机构,其中19家完全没有采取措施保存自己的网络文章。别说书面保存政策,就连非正式惯例也没有。事实上,这相当于把这项工作交给了互联网档案馆或Google这样的外部机构。对于始终追逐“此刻新发生的事情”的新闻媒体来说,保留已经发布的文章,始终排在后面。
放在从前,图书馆或许会填补这一空白。但随着出版转向数字化,图书馆也不再收藏学术期刊和电子书,而是购买在一定期限内阅览的权利。一旦订阅中断,连此前接收的内容也打不开了。就连图书馆,拥有的也不再是书,而只是房屋地址。
🧾 留存需要花钱
数字保存研究者戴维·罗森塔尔在1998年于斯坦福大学图书馆启动了名为LOCKSS的保存项目,并一直领导该项目,直至2017年退休。LOCKSS是“Lots Of Copies Keep Stuff Safe”的缩写,意思是副本多,内容就安全。它让多家图书馆直接分持电子期刊的副本,尝试让图书馆再次拥有书,而不只是地址。
皮尤研究中心的报告发布后,罗森塔尔提出了几点批评,其中之一是:皮尤研究中心没有确认,那些打不开的网页是否仍以副本形式保存在网页档案中。打不开与消失,是两回事。事实上,2026年4月,互联网档案馆把皮尤研究中心的地址与自家的Wayback Machine进行比对后发现,如果连Wayback Machine也一起查找,原本每4个中就有1个的“打不开的网页”,会减少为每10个中约1个。
但副本不会自动产生。罗森塔尔20多年来反复强调:数字保存面临的最大威胁,不是技术,而是钱。比起文件损坏或过时,没有资金保存才是大得多的威胁。2017年,他估计全世界每年用于网页存档的资金还不到3,000万美元,尽管创作这些内容花费了数千亿美元。他警告说,照此下去,未来读者理应能够看到的内容,将有一半以上无法留存。
按照罗森塔尔的经验法则,数字保存成本的一半花在最初采集的阶段,三分之一用于存储,剩下的六分之一用于提供阅览。消失以后就无法采集,所以,最终能留下什么,取决于网页还活着时,由谁支付最初的那笔费用。
那么,目前网络上的记录是如何管理的呢?我们又应当为这些内容的保存付出多大的努力?
下一篇,我们将看看消失的网页会在知识中留下怎样的空洞,以及人们正在作出哪些努力来对抗消亡。
#技术与制度之间 #链接腐烂 #数字消亡 #被遗忘权 #皮尤研究 #记录